深度学习算法的成功为在AR/VR应用使用神经网络(NNs)实现最先进性能提供了一个突破口。新兴的AI和机器学习(ML)支持的AR/VR任务包括对象检测、图像分割、眼睛和手势跟踪以及深度估计。将这些神经网络部署到边缘设备,如AR眼镜和可穿戴设备,将实现下一代人机交互和计算的新范式。
随着越来越多的AR/VR工作负载成为神经网络负载,AI/ML加速器成为SOC中的主要能源消耗者。然而,这些设备的小尺寸对尺寸、存储容量、长电池寿命和能效以及实时处理延迟提出了严格的要求,以实现无缝和愉快的用户体验。即使定制硅芯片针对神经网络加速进行了高度优化,用于存储器访问的功耗占比依然超过50%,严格的功耗预算使得片外DRAM访问对AR/VR而言过于昂贵。此外,考虑到紧凑的占位面积限制,2D解决方案无法在X-Y方向上继续扩展。
近年来,人们提出了3D集成方法来应对设备缩放挑战,包括微凸点、混合焊接和单片3D IC。特别是,混合焊接通过使用面对面(F2F)焊盘堆叠2D晶圆,实现了高密度、细间距3D互连集成和更高密度的垂直集成,可为本地存储和计算的低能量和低延迟访问提供高带宽。
AR/VR工作负载的挑战
将AR/VR NN部署到边缘设备上的关键特征包括:
(1)由于高输入/输出分辨率要求,激活内存占用空间较大。
(2)由于成本原因,需要在单个加速器上支持各种卷积运算和不同类型的基于计算机视觉的AR/VR模型。
正因为如此,我们的评估原型ML加速器采用可扩展计算阵列设计,以满足帧率(FPS)要求,并支持部署各种AR/VR工作负载的多功能性。
即使针对AR/VR工作负载的加速器进行了高度优化,由于大量激活内存需求而导致的内存访问仍然是满足能源和延迟要求的一个挑战。由于权重在推断期间是固定的,而激活对于每个输入样本是不同的,所以诸如量化、修剪和再训练之类的技术通常仅应用于权重,并且激活不太可能在运行时间之前被压缩,产生了边缘设备中的大量激活存储器占用空间。图1展示了一系列在权重和激活内存需求方面具有高度异构性的AR/VR工作负载,以及一些工作负载(例如,HRNet、Agg、去噪和超分辨率)的激活值大于权重。
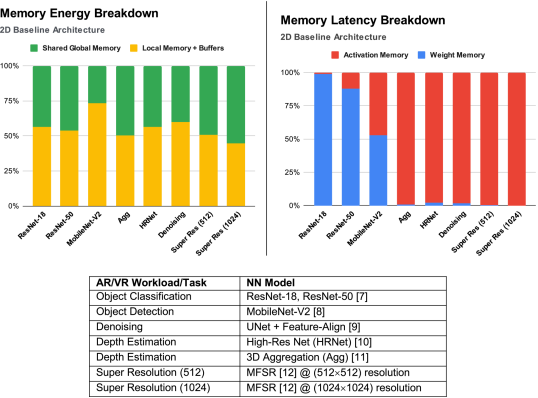
图1. AR/VR工作负载的内存能耗和延迟故障。其中,内存总能耗的50%是由于溢出到共享全局内存中的工作负载造成的。
与标准片上存储器分解技术/架构相比,使用高密度3D互连能够在加速器级别展示本地优势。
特别是,随着我们提高图2(a)中的分辨率要求,超分辨率变得极其昂贵。对于4MB片内激活存储器,外部带宽要求随着分辨率的提高呈超线性增长。在90 FPS时,分辨率为1,024×1,024,带宽要求超过16GB/s的典型DRAM/LPDDR4峰值带宽,因此无法支持更大的超分辨率情况。这尤其具有挑战性,因为分类精度、图像保真度和整体AR/VR用户体验随着分辨率的提高而提高。然而,这些网络通常需要几十到几百MB的存储器,从而需要片外溢出到外部存储器。
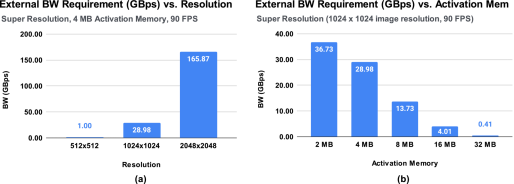
图2.(a)4MB激活存储器超分辨率的外部带宽要求,分辨率从512×512扩大到2,048×2,048;以及(b)由于增加了用于1,024×1,024图像分辨率的超分辨率的本地激活存储器容量,因此降低了带宽要求。
图2(b)表明,如果将内部SRAM增加到8-16MB,这将减少片外溢出量,并将带宽要求降至可接受的范围。增加2D内部SRAM容量的挑战是AR/VR用例苛刻的尺寸限制,特别是对于AR眼镜或可穿戴设备。2D中的大型中央SRAM不仅面积昂贵,而且会导致布线密度拥塞,并增加计算核心和SRAM之间的能量开销。
为了解决增加片上激活存储器的尺寸、带宽和可扩展性问题,我们建议使用3D集成来增加内部SRAM容量,但要在X-Y尺寸范围内。3D堆叠不仅减少了占地面积和带宽限制,还可以通过更短的线路长度和高密度连接来降低延迟和能耗。
为了说明这一点,我们对大型多存储体SRAM设计进行了布图规划实验。使用7纳米技术工艺设计套件从布局和布线实验中提取能量值。图3显示,与2D相比,对于相同的存储容量,我们可以实现类似或更低的能量访问,因为使用F2F键合和混合凸点可以缩短2层或4层堆叠的布线长度。考虑到TSV技术的能源开销成本,在查看8MB容量的4层3D堆叠的示例时,我们开始看到堆叠超过4层的回报递减。然而,随着我们将容量扩大到16-32MB,这在能量上变得更接近于2D配置,并且我们期望TSV技术/开销随着时间的推移而改善。
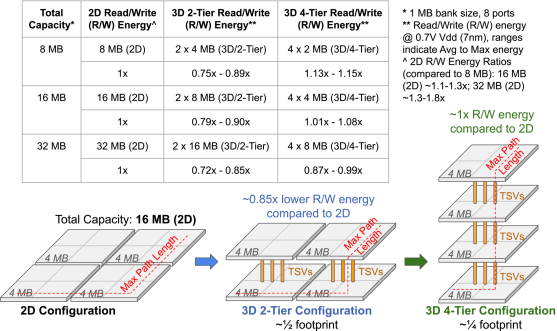
图3. 相同内存容量(8-32MB)在3D层(2-4层分区)中的读/写能量比较。3双层3D访问能量由于布线长度较短而低于二维访问能量,但由于TSV能量开销,在4层时开始增加或变得与2D配置能量相等。
出于分析目的,我们探索了2D基线、3D 2层和3D 4层配置之间的能源与占用空间(内存容量)设计权衡,但将设计空间限制在接近二维基线的占用空间(从1-16MB扩展)。虽然我们也期望3d堆叠在延迟和带宽方面有所改善,但我们悲观地假设延迟和带宽与2d基线SRAM访问相似,这是我们分析的保守估计。
方法:用于3D叠加模拟的ML加速器解析模型
我们使用内部ML加速器模拟器,该模拟器可对各种硬件指标估计,如运行AR/VR模型的已评估原型ML加速器的执行时间(延迟)、能量、输入/输出流量和资源利用率。这种基于分析模型的模拟器采用ML模型(例如PyTorch),提取运算符,并根据基于加速器架构的TOPS和能量表计算预期性能指标。虽然不是周期精确模型,但模拟器已经通过周期精确模拟进行了内部验证,并用作提供早期性能评估的工具,以指导不同ML模型的架构设计趋势和决策。
我们将模拟器配置为接收更大的激活内存,并考虑扩展的3D内存能量开销。鉴于DRAM访问极其昂贵,我们将工作负载选择限制在适合通过SoC片上网络(NoC)访问的32MB共享SRAM内的NNs。图4展示了我们设置的框图。
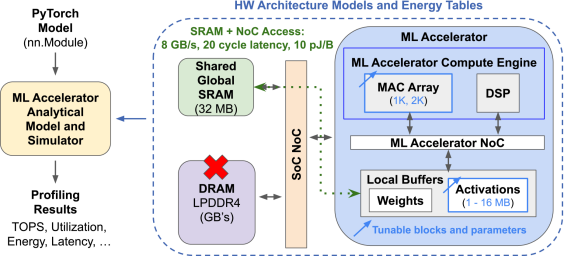
图4. ML加速器模拟器和模型架构。本地SRAM/缓冲区扩展到16MB用于激活,MAC阵列从1K扩展到2K。由于DRAM访问非常昂贵,我们假设加速器外部的所有存储器访问都通过与SoC NoC共享的全局SRAM。
为了保持与2D基线相似的占用空间,我们用两种关键配置扫描了图5中的设计空间参数:
(1)使用3D堆叠来实现更小的占用空间,并将激活内存增加到2-8MB。
(2)将MAC阵列增加到2K并从4-16MB的激活内存进行堆栈会产生较小的占用空间开销(38%)。这提供了一个有代表性的探索来比较不同的3d配置选项与我们的2D基线相比在能量、延迟和占用空间之间的设计权衡。注意我们只考虑了ML加速器的内存占用,但是包括了本地和共享内存访问的能量。我们的目标是通过增加本地内存来减少加速器外部的共享内存访问,从而减少内存溢出。
3D配置与2D基线相比:
(1)占用空间更小,在Z方向上堆叠2MB的激活内存,最多8mb;以及
(2)从1K增加到2K MAC(38%的占用空间增加),在Z方向上堆叠4MB的激活存储器直到总共16MB。
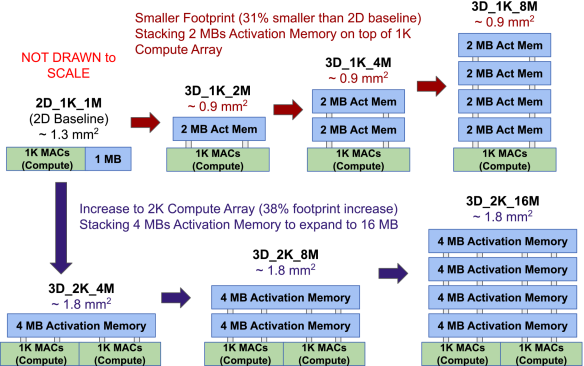
图5. 3D配置与2D基线的比较。
结果和发现
我们的ML模拟器针对高激活内存需求的AR/VR工作负载运行结果包括:深度估计(HRNet、Agg)、去噪和超分辨率。
深度估计
深度估计支持3D体验,例如AR眼镜的增强通话。精确的每像素深度预测对于自然和身临其境的通话体验至关重要。深度估计管道由两个关键的神经网络模型组成:高分辨率网络(HRNet)和3D聚合(Agg)。
图6显示了与2D基线相比,3D配置中HRNet和Agg的能源和延迟节省。关注共享内存能量和内存延迟,我们看到将HRNet的本地激活内存增加到4MB,Agg增加到8MB,减少了共享内存访问,从而将内存能量和延迟降低到可以忽略的水平。我们的模拟器估计,HRNet的总能耗节省为1.35倍,总延迟节省为1.4-2.6倍,Agg的总能耗节省为1.45倍,总延迟节省为1.6-3倍。
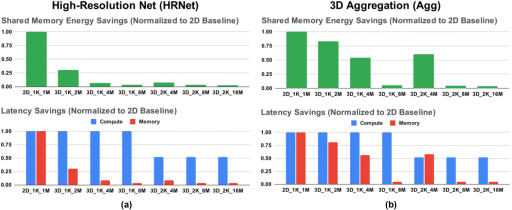
图6. 深度估计神经网络模型的共享内存能量和计算/内存延迟节省。(a)HRNet和(b)根据我们的2D基线标准化的Agg。HRNet的激活内存为4MB,Agg的激活内存为8MB,此时共享内存的溢出减少到可以忽略的程度。
去噪
去噪是AR/VR应用的另一个重要工作负载,因为无缝和愉快的用户体验需要图像恢复,去噪也有助于提高有限传感器分辨率下的检测率。由于模型相对较小,从1MB增加到2MB可显著减少图7中的共享内存访问,我们看到增益递减会将激活内存增加到2MB以上。我们的模拟器估计,从2D到3D,总能耗节省了1.35倍,总延迟节省了1.4-2.8倍。如果受到面积限制,不能堆叠超过2MB,这是一个很好的候选工作负载,它受益于3D集成,并且比2D基线占用的空间更小。
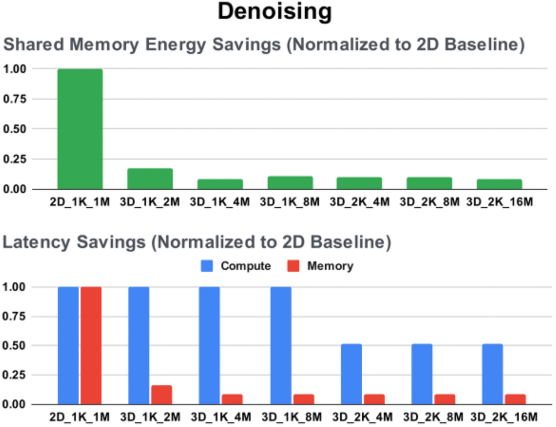
图7. 共享内存能量和计算/内存延迟节省,用于去噪,标准化为我们的2D基线。在2MB左右的激活内存中,共享内存的溢出减少到可以忽略不计,并随着容量的增加而递减。
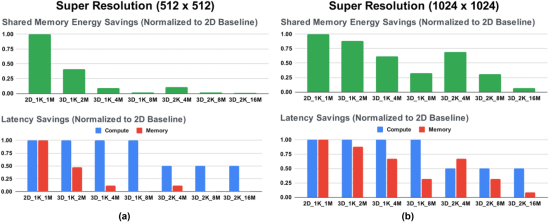
图8. (512×512)和(1,024×1,024)分辨率下超分辨率的共享内存能量和计算/内存延迟节省,以2D基线为基准。对于(512×512)和(1,024×1,024),共享内存溢出的最佳减少量分别为8MB和16MB。
超分辨率
AR/VR系统中的超分辨率用于放大低分辨率图像,以提高图像质量。在更高分辨率下部署超分辨率模型的能力受到片内存储器容量的限制,因此片外带宽要求也无法满足FPS要求。
图8显示了(512×512)和(1,024×1,024)分辨率下超分辨率的能量和延迟改善情况。减少共享内存访问的最佳位置是8MB(512×512)和16MB(1,024×1,024)。这与我们从图2中观察到的情况一致,即激活内存达到16MB会将外部内存带宽需求降低到可接受的范围。我们模拟器估计,在(512×512)超分辨率下,总能量节省1.45倍,延迟减少1.9-3.7倍,在(1,024×1,024)超分辨率下,能量减少1.3-1.6倍,延迟减少1.6-3.8倍。
我们注意到,分辨率为(1,024×1,024)的超分辨率以前在2D中无法部署,这说明了3D集成如何能够部署更大的NN模型,而不会产生显著的占用开销,同时改善加速器的能量和延迟。
结论
表1总结了我们提出的3D配置的结果,以及预期的性能)能源、延迟)改进和计算的2d和3d尺寸。使用能源尺寸产品(FoM1)的品质因数(FoM),我们注意到最佳3d配置出现在3d_1K_8M)8mb容量的最小尺寸)。如果延迟至关重要,并且我们能够承受38%的额外占用空间开销,则针对节能延迟占用空间产品使用FoM 2可获得3d_2K_16M的最佳配置。
表1. 3D堆叠神经网络加速器架构配置汇总
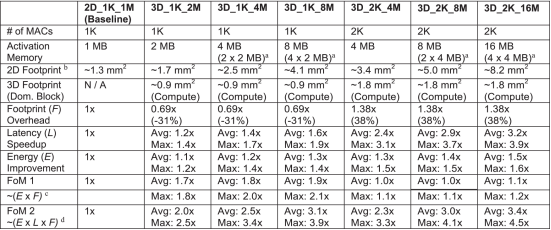
我们提出的将激活内存从1MB增加到2-8MB的3D配置将延迟提高了1.2-1.9倍,将能耗提高了1.1-1.4倍,占用空间更小(减少31%),占用空间略有增加(38%的开销),将激活内存从1MB增加到4-16MB,MAC数量从1K增加到2K,可使深度估计、去噪和超分辨率AR/VR的能耗降低1.3-1.6倍,延迟节省2.4-3.9倍。结果还表明,分辨率为(1,024×1,024)的超分辨率(以前在2D中不可部署)可以适应类似的尺寸,同时在能量和延迟方面都有所改善。
未来,我们计划在X-Y和Z方向上扩展内存容量,以查看收效递减的点(TSV/占用空间开销)。此外,我们计划集成DRAM访问估计,构建一个内存层次结构来分析部署更大的AR/VR模型。
原文链接:
https://www.computer.org/csdl/magazine/mi/2022/06/09933882/1HWLLFaYN9K