大型语言模型(LLM)是能够分析和生成文本的计算机模型,它们接受了大量文本数据的训练,以提高它们在文本生成甚至编码等任务中的表现。
目前大多数LLM都是纯文本的,也就是说,它们只擅长基于文本的应用程序,而理解其他类型数据的能力有限。
纯文本LLM的例子包括GPT-3、BERT、RoBERTa等。
相反,多模态LLM结合了其他数据类型,如图像、视频、音频和其他感官输入以及文本。将多模态集成到LLM中解决了当前纯文本模型的一些局限性,并为以前不可能实现的新应用程序提供了可能性。
Open AI最近发布的GPT-4就是Multimodal LLM的一个例子,它可以接受图像和文本输入,并在许多基准测试中显示出人类水平的性能。
多模式人工智能的兴起
多模态AI的进步可以归功于两个关键的机器学习技术:表征学习和迁移学习。
通过表示学习,模型可以为所有模式开发一个共享的表示,而迁移学习允许它们在对特定领域进行微调之前先学习基本知识。
这些技术对于实现多模态AI的可行性和有效性至关重要,正如最近的突破所证明的,例如CLIP(将图像和文本对齐),以及从文本提示生成高质量图像的DALL·E2和Stable Diffusion。
随着不同数据模式之间的边界变得不那么清晰,我们可以期待更多的人工智能应用程序利用多种模式之间的关系,这标志着该领域的范式转变。临时方法将逐渐过时,理解各种模式之间联系的重要性只会继续增长。
多模式LLM的工作
纯文本语言模型 (LLM) 由transformer模型提供支持,可帮助它们理解和生成语言。该模型接受输入文本并将其转换为称为“词嵌入”的数字表示,这些嵌入有助于模型理解文本的含义和上下文。
然后,Transformer 模型使用一种叫做“注意力层”的东西来处理文本,并确定输入文本中不同单词之间的相互关系,此信息有助于模型预测输出中最有可能的下一个单词。
另一方面,多模式 LLM 不仅可以处理文本,还可以处理其他形式的数据,例如图像、音频和视频。这些模型将文本和其他数据类型转换为通用编码空间,这意味着它们可以使用相同的机制处理所有类型的数据,这允许模型生成包含来自多种模式的信息的响应,从而导致更准确和上下文的输出。
为什么需要多模态语言模型
GPT-3 和 BERT 等纯文本 LLM 具有广泛的应用,例如撰写文章、撰写电子邮件和编码。然而,这种纯文本方法也突出了这些模型的局限性。
虽然语言是人类智能的重要组成部分,但它只代表了我们智能的一个方面。我们的认知能力在很大程度上依赖于无意识的感知和能力,这在很大程度上取决于我们过去的经验和对世界运作方式的理解。
仅接受文本培训的法学硕士在整合常识和世界知识的能力方面存在固有的局限性,这对于某些任务来说可能会出现问题。扩大训练数据集在一定程度上有所帮助,但这些模型可能仍会遇到意想不到的知识缺口。多模式方法可以解决其中一些挑战。
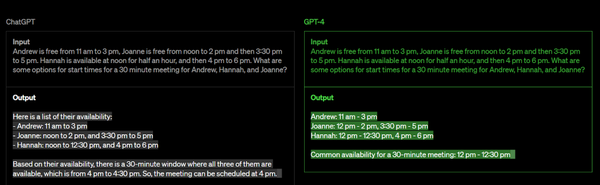
为了更好地理解这一点,请考虑 ChatGPT 和 GPT-4 的示例。
尽管 ChatGPT 是一种卓越的语言模型,已在许多情况下证明非常有用,但它在复杂推理等领域有一定的局限性。
为了解决这个问题,GPT 的下一个迭代 GPT-4 有望超越 ChatGPT 的推理能力。通过使用更先进的算法并结合多模态,GPT-4 准备将自然语言处理提升到一个新的水平,使其能够解决更复杂的推理问题并进一步提高其生成类似人类响应的能力。
多模式 LLM的一些例子
OpenAI:GPT-4
GPT-4 是一个大型的多模式模型,可以接受图像和文本输入并生成文本输出。尽管在某些现实世界的情况下它的能力可能不如人类,但 GPT-4 在许多专业和学术基准测试中都表现出了人类水平的表现。
与其前身 GPT-3.5 相比,这两种模型之间的区别在随意的谈话中可能很微妙,但当任务的复杂性达到一定阈值时就会变得明显。GPT-4 比 GPT-3.5 更可靠、更有创意,可以处理更细微的指令。
此外,它可以处理涉及文本和图像的提示,允许用户指定任何视觉或语言任务。GPT-4 已经展示了其在各个领域的能力,包括包含文本、照片、图表或屏幕截图的文档,并且可以生成自然语言和代码等文本输出。
Khan Academy最近宣布将使用 GPT-4 为其人工智能助手Khanmigo提供支持,该助手将充当学生的虚拟导师和教师的课堂助手。每个学生掌握概念的能力差异很大,而 GPT-4 的使用将帮助组织解决这个问题。
微软:Kosmos-1
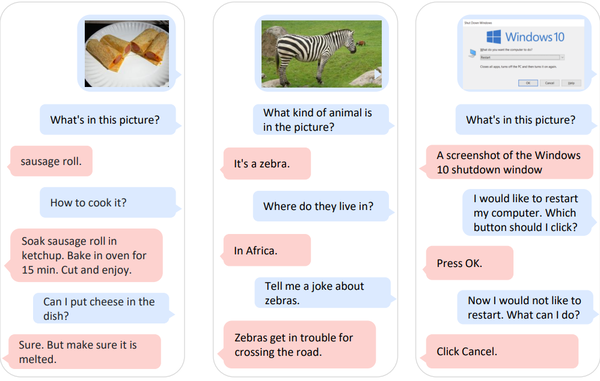
Kosmos-1 是一种多模态大型语言模型 (MLLM),可以感知不同的模态、在上下文中学习(少量样本)并遵循指令(零样本)。Kosmos-1 已经在网络数据上从头开始训练,包括文本和图像、图像-标题对和文本数据。
该模型在语言理解、生成、感知语言和视觉任务上取得了令人印象深刻的表现。Kosmos-1 原生支持语言、感知语言和视觉活动,可以处理感知密集型和自然语言任务。
Kosmos-1 已经证明,多模态允许大型语言模型以更少的资源实现更多,并使更小的模型能够解决复杂的任务。
谷歌:PaLM-E
PaLM-E 是由谷歌和柏林工业大学的研究人员开发的一种新型机器人模型,它利用来自各种视觉和语言领域的知识转移来增强机器人学习。与之前的努力不同,PaLM-E 训练语言模型以直接合并来自机器人代理的原始传感器数据。这导致了一个高效的机器人学习模型,一个最先进的通用视觉语言模型。
该模型接受具有不同信息类型的输入,例如文本、图片和对机器人周围环境的理解。它可以生成纯文本形式的响应或一系列文本指令,这些文本指令可以根据一系列输入信息类型(包括文本、图像和环境数据)转换为机器人的可执行命令。
正如研究人员进行的实验所证明的那样,PaLM-E 在具体任务和非具体任务中均表现出能力。他们的发现表明,在任务和实施例的组合上训练模型可以提高其在每项任务上的表现。此外,该模型的知识转移能力使其能够有效地解决机器人任务,即使训练示例有限。这在机器人技术中尤为重要,因为在机器人技术中获得足够的训练数据可能具有挑战性。
多模式 LLM 的局限性
人类自然地学习和结合不同的模式和方式来理解他们周围的世界。另一方面,多模式 LLM 试图同时学习语言和感知或结合预训练的组件。虽然这种方法可以导致更快的开发和改进的可扩展性,但它也可能导致与人类智能的不兼容,这可能会通过奇怪或不寻常的行为表现出来。
尽管多模式 LLM 在解决现代语言模型和深度学习系统的一些关键问题方面取得了进展,但仍有一些局限性需要解决。这些限制包括模型与人类智能之间的潜在不匹配,这可能会阻碍它们弥合人工智能与人类认知之间差距的能力。
结论:为什么多模式 LLM 是人工智能的未来?
我们目前处于人工智能新时代的前沿,尽管目前存在局限性,但多模态模型有望接管。这些模型结合了多种数据类型和模式,并有可能彻底改变我们与机器交互的方式。
多模式LLM在计算机视觉和自然语言处理方面取得了显着的成功。然而,在未来,我们可以期待多模式LLM对我们的生活产生更重大的影响。
多模式 LLM 的可能性是无穷无尽的,我们才刚刚开始探索它们的真正潜力。鉴于其巨大的前景,很明显,多模式 LLM 将在 AI 的未来发挥至关重要的作用。
