在准备数据时,经常通过许多不同的方法来达到可以提供准确结果的数据质量水平。在本文中,描述了无监督 ML 如何帮助机器学习项目的数据准备,以及它如何帮助获得更准确的业务洞察力。
传统的数据准备方法有什么问题?
为了准确的预测,数据不仅必须被正确标记、去代表广泛一致等。关键是机器学习模型应该处理“正确”的数据,目前尚不完全清楚“正确”数据的标准是什么。
当数据科学家准备数据时,他们通常需要领域专家协助数据分类和标记。如果考虑到大多数机器学习项目,通常没有领域专家可用于此类任务。在这里,由于对 ML 模型预期的最终输出的错误理解、数据的错误分类和人为错误,数据的正确性可能会失败。在这种情况下,ML 模型可能会在一开始就输出错误的结果,并在未来导致进一步的错误。
还有一个问题是预期结果是否真的可以在优化业务流程时增加价值。如果最初的假设是错误的怎么办?在这里,指的是存在一些产品所有者和数据科学家都不知道的数据底层结构的情况。
无论如何,数据科学家在训练 ML 模型之前花费高达 80% 的时间清理收集的数据,这并不能保证完全没有错误和偏见。这就是为什么往往难以达到理想的数据质量并满足所有数据标准要求的原因m这就是我们采用无监督机器学习方法的方式。
什么是无监督机器学习?
在回顾无监督机器学习之前,让我们先定义一下什么是监督学习。根据维基百科,监督学习是学习函数的机器学习任务,该函数基于示例输入输出对将输入映射到输出。它从由一组训练示例组成的标记训练数据中推断出一个函数。这些标记的训练数据对 ML 模型很有用,因为它可以更准确地区分数据类别。在这种情况下,模型性能的衡量标准是从一开始就定义的,并且很清楚什么可以被视为“准确”的输出。上一段描述了这种方法的可能后果。
在无监督机器学习中,没有概述数据标签,我们无法衡量算法的性能。该算法自行检测数据的深层结构,并将数据集分配到不同的类别中。该算法通常根据业务目标进行选择,如果执行正确,业务解决方案的功能将比基于监督学习的解决方案强大10倍。
无监督 ML 算法没有预定义任务,可能会检测到我们可能不知道的隐藏数据模式。此外,在寻找未来数据中的新模式时,最好使用无监督机器学习,从而提前优化基于机器学习的解决方案。
定义数据底层结构的无监督机器学习方法
无监督方法主要集中在底层数据结构的发现上。在这里描述了最常用的方法。
降维算法
降维是用于识别数据模式和处理计算量大的问题的 ML 方法。该方法包括一组算法,旨在通过将原始高维输入数据投影到低维空间来减少数据集中输入变量的数量。在处理涉及语音、视频、图像或文本的视觉和音频数据时,以及在简化数据集以更好地适应预测模型时,降维很有用。有很多降维算法的例子,但我想强调 UMAP,我们发现它在处理其中一个机器学习项目时很有用。
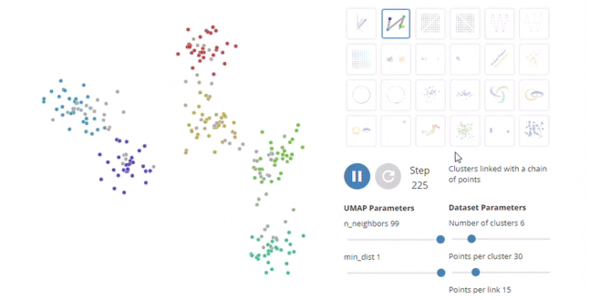
UMAP(Uniform Manifold Approximation and Projection)算法允许构建数据的高维图形表示,并进一步优化低维图形,使其在结构上尽可能相似。
该算法的主要特点是数据的非线性表示。与其他降维算法相比,它擅长缩放数据集的维度和大小以及快速投影。例如,UMAP 可以在不到 3 分钟的时间内投影 784 维、70,000 点的 MNIST 数据集,而 scikit-learn 的 t-SNE 实现需要 45 分钟。
数据聚类
聚类允许在一组未标记的数据中定义一个结构。简而言之,它根据数据的相似性和不同性将数据组织成组(集群)。这种方法适用于市场和客户细分、推荐引擎、文档分类、欺诈识别等案例。
聚类的目标是检测未标记数据集中的不同组,其中期望用户确定什么是“正确”聚类的标准,以便聚类结果符合他们的期望。
聚类算法有很多,包括KNN、K-means、Gaussian Mixture Model等,这里想强调两个在我们的实践中证明了其高性能的算法:DBSCAN和HDBSCAN。
DBSCAN(基于密度的噪声应用程序空间聚类)算法根据距离测量和数据科学工程师指定的最小实例数,获取彼此靠近的所有实例并将它们分组在一起。由于指定了多个集群内的距离,因此集群将包含位置最密集的那些实例。如果某个实例位于指定距离之外,并且不属于任何集群,它将被标记为异常值。
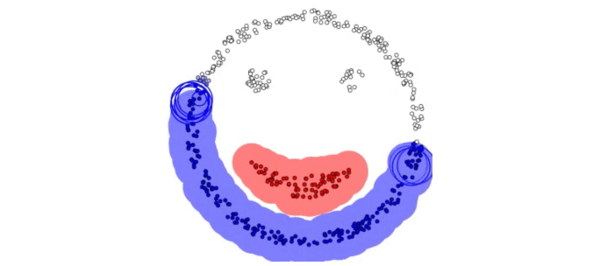
该算法善于发现那些可用于定义模式和预测趋势的数据结构和关联。例如,在开发推荐引擎时,可以将 DBSCAN 算法应用于客户数据库,以找到特定用户最需要的产品。
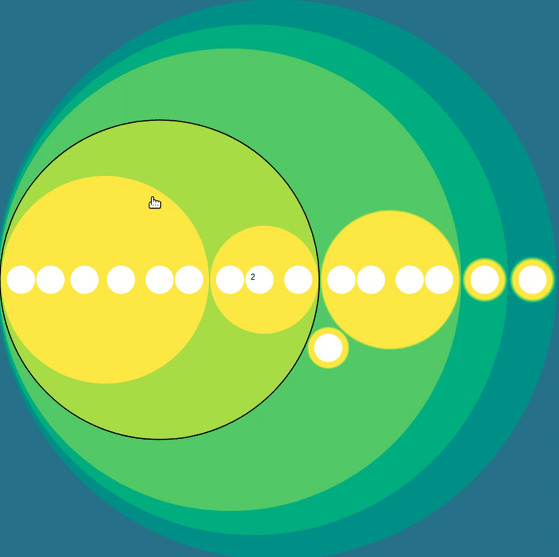
HDBSCAN (Hierarchical Density-Based Spatial Clustering of Applications with Noise) 算法 将 DBSCAN 转化为层次化的方式,并根据聚类的稳定性提取平面聚类。
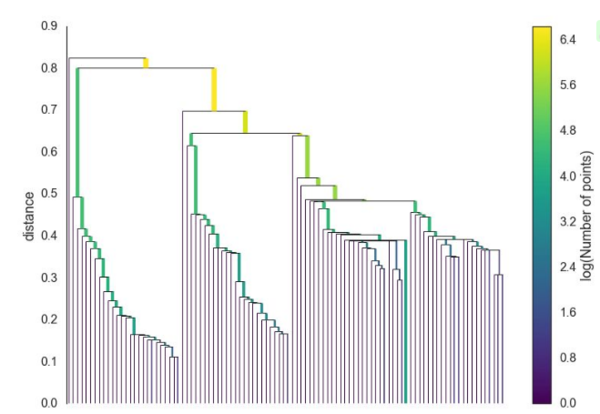
HDBSCAN算法首先根据密度或稀疏度改变空间,创建距离加权图的最小树,构建连通分量的聚类层次结构。该算法基于最小簇大小,压缩簇层次,最后从压缩树中提取稳定的簇。
异常检测算法
异常检测算法本身不是独立的。它通常与降维和聚类算法一起使用。通过使用降维算法作为异常检测的前置阶段,我们首先将高维空间转换为低维空间。然后我们可以计算出这个低维空间中主要数据点的密度,这可以被识别为“正常”。远离“正常”空间的那些数据点是异常值或“异常”。
聚类算法通常用于改进异常分析。它允许对类似的异常进行分组,并根据它们的行为类型进一步进行手动分类。通过遵循这样的过程,我们可以使用无监督的 ML 算法来检测异常,将它们聚类,手动为每个聚类提供标签;因此,获得我们无法预测的业务洞察力。
异常检测的一个很好的例子是垃圾邮件过滤,其中 ML 算法分析所有传入的消息,对它们进行聚类,并将垃圾邮件检测为异常值。它还广泛用于金融、保险、IT 和其他领域的欺诈检测。
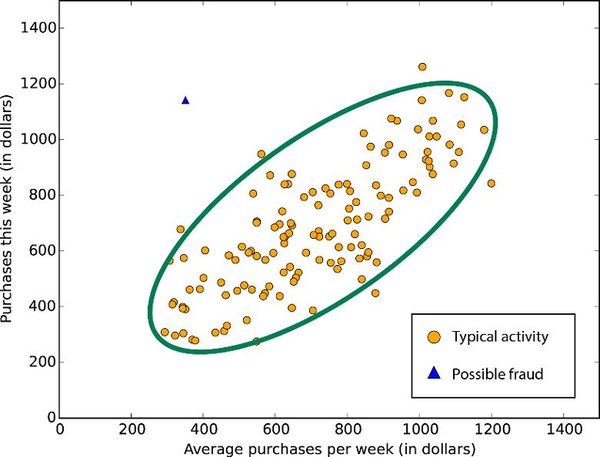
该算法也是制造业中基于 ML 的预测性维护系统的一部分。通过检测系统行为中的异常,该算法允许在设备故障发生之前对其进行预测。
关联挖掘算法
关联挖掘是一种无监督的 ML 算法,用于识别经常一起出现的大型数据集中的隐藏关系。与大多数处理数字数据的 ML 算法相比,关联挖掘可以处理非数字、分类数据,这意味着它需要比简单计数更多的操作。
该算法通常用于识别事务、关系或任何类似数据库中的模式和关联。例如,可以构建 ML 算法,该算法将通过条形码扫描仪的数据处理来分析购物篮,并定义一起购买的商品。
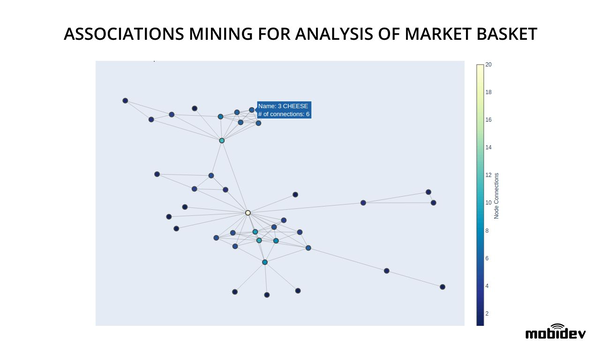
在 医疗保健 领域,关联挖掘可以用于设置正确的诊断。通过处理症状特征和各种疾病因素并定义关联,我们可以预测疾病概率。此外,如果将来添加新的症状,则有可能找到新数据与疾病之间的关系。
在公共部门,关联挖掘算法可用于人口普查数据处理。因此,它可能有助于优化公共服务和业务的规划,例如交通、教育、卫生、建立新的购物中心和工厂。
无监督 ML 业务案例
让我们回顾几个使用无监督 ML 的真实业务案例。
云计算硬件性能比较
我们的一个项目涉及使用无监督 ML 算法来比较虚拟机的性能。由于项目领域有点难以理解,我们决定不使用任何标签,因为它们可能是主观的,而是建立一个独立的系统;因此,我们做了以下事情:
- 在云端创建虚拟机
- 通过运行不同的测试对其进行基准测试,以衡量 VM 的性能
- 收集了大约 2000 个特征作为原始数据
- 分析收集到的原始数据并提取最有价值的基准
- 将基准压缩为多个系数(并行化、单核、稳定性、数据库、RAM)
- 计算自定义系数作为性能和价格之间的平衡
根据特性和价格选择最佳实例类型
上面描述的过程是降维技术的一个很好的例子,因为我们没有包括系统的所有特征,而是包含在结果方面可以被视为“代表性”的折叠信息。
人工标记评估和自动化
该项目涉及评估人工标签,这在数据科学中是一项艰巨的任务。我们必须找到评估人工标签质量的最佳方法。有了关于个人和法人实体的数据,我们应该将其分为三类,对其进行分析,找到特定的标签,并预测标签的准确性。
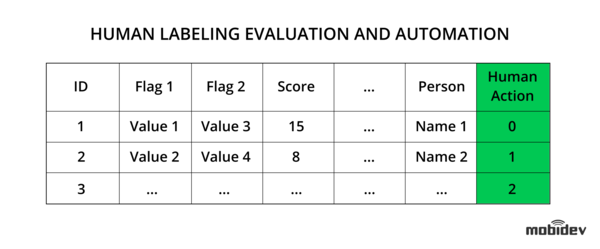
我们根据特定特征设置人类行为标签,构建分类器,并评估这些标签的质量。
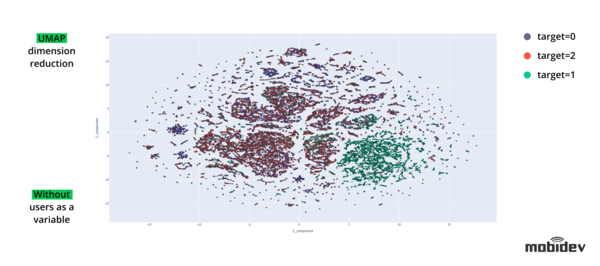
从上图可以看出,如果没有用户作为变量来划分类别几乎是不可能的,因为根据特征和标签,它们之间的距离太近了。
但是让我们看一下这张图表,其中包含我们将用户作为变量的数据,其中最终的人类行为标签取决于人。
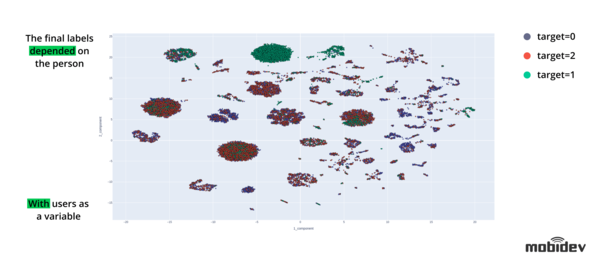
通过在该算法中添加一个人,我们可以获得最佳结果。这里重要的是数据应该是独立的,这意味着它不应该与对标签感兴趣的人有关系。因此,我们得出结论,没有正确的方法来进行分类任务,最好使用原始数据。
总之,任何商业案例都没有完美的路径,而无监督机器学习只是获得预期结果的工具。如果您确定它满足您的业务需求,它就会运作良好。
