机器学习模型能够更快速、更高效地解决几个真实世界的问题。其中之一是基于唇部运动,为动画角色和人类说话者合成语音。
为了解决这项被称为嘴唇到语音(Lip2Speech)合成的任务,机器学习模型基本上学习预测特定面部和嘴唇动作序列所导致的口语单词结果。自动化Lip2Speech合成可以用于多种用例,例如帮助不能发出语音声音的患者与其他人交流,为无声电影添加声音,恢复嘈杂或损坏视频中的语音,甚至还可用于确定CCTV录像中潜在罪犯在说些什么。
虽然一些用于Lip2Speech应用的机器学习取得了有希望的结果,但大多数这些模型在实时性能方面表现不佳,且未使用所谓的零样本学习方法进行训练。零样本学习本质上意味着预训练模型能够有效预测其在训练期间未遇到的数据类别。
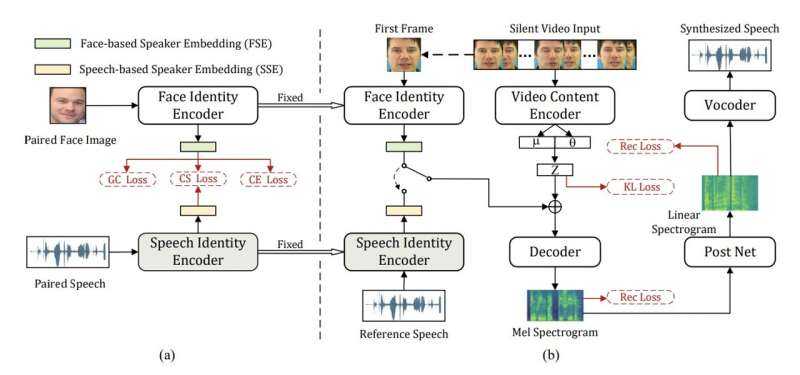
中国科学技术大学的研究人员最近开发了一种新的Lip2Speech合成模型,可以在零-shot条件下产生个性化的合成语音。这种方法在arXiv预印本服务器上发表的一篇论文中介绍,基于变分自编码器,这是一种生成模型,部分基于神经网络来进行数据编码和解码。
为了在零-shot条件下有效地解决Lip2Speech任务,机器学习模型通常需要从可靠的视频录制中提取讲话者的附加信息。然而,如果仅有他们的面部在无声或难以理解的视频中说话,这些信息无法被获取。这个研究团队创建的模型可以规避这个问题,它可以生成与给定讲话者的外观和身份相匹配的语音,而不需要对讲话者的实际说话进行记录。
"我们提出了一种零样本个性化的唇语合成方法,其中面部图像控制说话者身份,"Sheng Zheng-Yan、Ai Yang和Ling Zhen-Hua在他们的论文中写道。 "采用变分自编码器来分离说话者身份和语言内容表示,使说话者嵌入能够控制未见说话者的合成语音的语音特征。此外,我们提出了相关的跨模态表示学习,以提高基于面部的说话者嵌入(FSE)在声音控制方面的能力。"
Sheng、Ai和Ling在一系列的测试中评估了他们的模型并发现它表现得非常好,能够产生与说话人的唇部运动、年龄、性别和整体外观相匹配的合成语音。未来,这个新模型可以用于创建各种各样的工具,包括帮助语音受损人士的辅助应用程序、视频编辑工具以及协助警方调查的软件。
Sheng、Ai和Ling表示:广泛的实验验证了所提出方法的有效性,其合成的话语比其他的方法更加自然、与输入视频的个性更加匹配。据我们所知,本文是首次尝试通过面部图像而非参考音频来控制语音特征的零射击个性化Lip2Speech合成的研究。
