今年,人工智能赢得了艺术比赛、统治了互联网、通过了法律考试并证明了它是未来的技术,但是,它仍然不能准确地生成一只手。
尽管人工智能图像生成器已经投入了大量工作,但手已经成为它们的克星,暴露了模型中的弱点。
虽然这在Dall-E 2及其所有后续竞争对手的崛起中一直是一个值得注意的问题,但随着 AI 生成器Midjourney创建的 Twitter 用户图像集的出现,这个问题成为了人们关注的焦点。
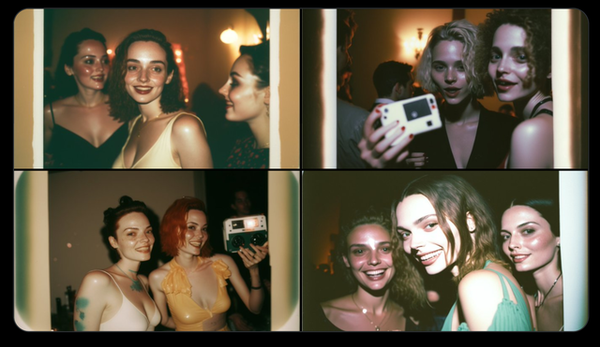
上图一眼望去,令人印象深刻,在聚会上营造出一群逼真的人。然而,在一张照片中,一个人有三只手,另一个人有七个手指和一个非常长的手掌,最后一张图片显示一个人的手指向后穿过电话。
那么为什么这么小的障碍会导致机器出现故障呢?
“这些 2D 图像生成器完全没有像手这样的物体的三维几何概念,”伦敦大学学院的计算机科学家兼作者Peter Bently 教授说。
“他们只掌握了手的一般概念,它有手掌、手指和指甲,但这些模型中没有一个真正理解完整的东西是什么。”
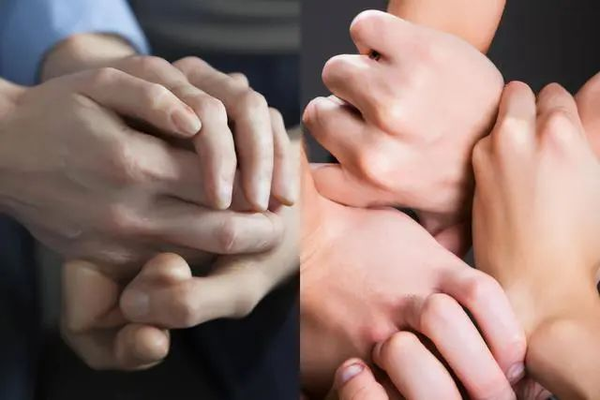
如果您只是想获得一只手的非常普通的图像,这不是什么大问题。一旦您为模型提供上下文,就会出现问题。如果它不能理解一只手的 3D 性质或某种情况的背景,它就很难准确地重建它。
例如,一只手拿着一把刀或相机之类的物体,或者有人用手做一个符号,这会立即混淆一个没有手的 3D 理解或它所握物体的几何形状的模型.
“我让 Dall-E 展示一张两只手十指交错的照片,我得到了一些奇怪的结果,它向我展示了两个手腕和其中一个的手指球,”Bently 教授说。
“但你可以理解为什么,它并不知道它在做什么,它只是将它看到的所有这些图像组合起来,以尽可能地满足你的文字描述。”
然而,不仅仅是 Dall-E 2 遇到了这个问题。其他流行的图像模型,如 Midjourney 和Stable Diffusion,都遇到了制作看起来正常的手的同样不可能完成的任务。
仔细看看图片
虽然这些模型所创建的图像常常让人感觉近乎完美,但实际上它们往往存在很大缺陷。你看得越多,就越有可能发现大量不准确的细节。
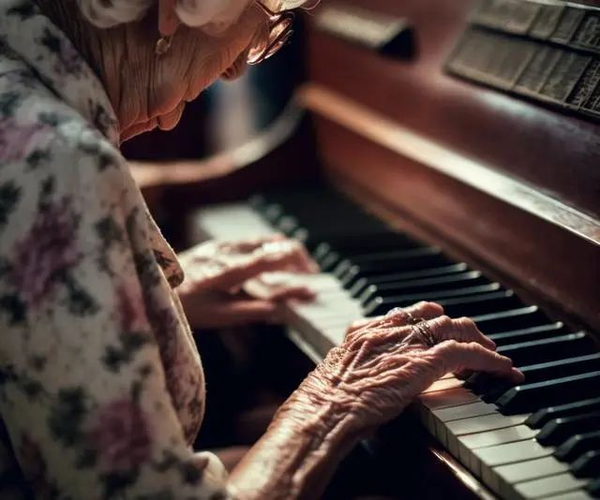
这部分取决于用户和他们使用的提示的强度,有些人从他们的详细提示中获得接近完美的图像。但实际上,这主要是模型本身的问题。
“当你真正仔细观察时,某处有一个明显的信号表明物理定律正在以某种方式被打破。也许有一只手臂穿过某人的胃,或者一只触手太多的章鱼,或者一棵漂浮在地面上的树,”Bently说。
“因为他们刚刚被喂养了很多很多东西的例子,它正试图尽可能地将它们拼凑在一起。”
这有时会导致一些奇怪的结果,通常给人一种类似于萨尔瓦多·达利画作的梦幻般的感觉。
“这些模型脱离了现实,他们没有任何背景,他们实际上没有任何知识或能力来考虑图像的背景,他们只是把我们给它的所有元素生硬地结合起来。”
人工智能图像的主要障碍
所以这些模型很好,甚至很棒,但它们离创造完美的图像还有很长的路要走。要解决这个问题并最终创造出一只看起来不像是受大卫·柯南伯格启发的手,会发生什么?
“这一切都可能在未来发生改变,这些网络正在慢慢接受 3D 几何图形的训练,以便它们能够理解图像背后的形状。这将为我们提供更连贯的图像,即使提示很复杂,”Bently 说。
“获得足够的 3D 设计数据可能需要时间。目前,我们正在以这些 2D 图像的形式获得简单的结果。在没有上下文的情况下在互联网并获得一百万张图片很容易。”
这是 OpenAI 开始使用其Point-E技术开展的工作,创建一个可以根据文本提示创建 3D 模型的系统。虽然它目前可供公众使用,但要产生准确的结果还有很长的路要走。
然而,当结果真的出现时,它们可能会导致非常详细的 3D 渲染甚至数字世界。正如 Bentley 所解释的那样:“大量资金投入到对 3D 模型感兴趣的元宇宙等领域。因此,通过这些综合预算,我们很有可能会看到由 AI 创建的越来越令人印象深刻的 3D 模型。”
这项技术可以继续改进,成为更大、更令人印象深刻的东西。现在我们正在研究 AI 生成的 2D 图像,未来可能是非常详细的 3D 渲染甚至数字世界。
