摘要
我们在本文中提出了一种用于机器人学的自监督感知动作预训练方法。我们的模型名为RPT,它是一个基于传感动作令牌序列的Transformer。给定一系列相机图像、机器人自感知状态和过去的动作,我们将交错序列编码为标记,屏蔽随机子集,并训练模型来预测屏蔽内容。我们假设,如果机器人能够预测缺失的内容,那么它已经获得了一个能够使其行动的物理世界模型。RPT旨在处理潜在的视觉表示,这使得预测易于处理,使模型能够扩展到10倍大的规模,并在实际机器人上以10 Hz的推理速度运行。为了评估我们的方法,我们使用运动规划和基于模型的抓取算法,并收集了9个月内的20000条真实世界轨迹数据集。我们发现,使用这些数据进行预训练始终优于从头开始训练,在堆叠方块任务中提高了2倍,并具有良好的可扩展性特性。
1 介绍
在过去的几年里,受到视觉和语言的启发,人们对机器人预训练的兴趣日益浓厚。例如,我们在人类视频的预训练视觉表示方面看到了有希望的结果 。最近,我们在用语言注释的大型机器人轨迹数据集上训练视觉运动模型取得了很好的结果。我们提出一个问题:我们可以仅从感觉运动轨迹中学习机器人的良好表征吗?
在本文中,我们提出了一种用于机器人的自监督感觉运动预训练方法。我们通过感知运动预测问题制定预训练。我们假设,如果机器人能够预测缺失的感知运动内容,那么它就已经获得了一个关于物理世界的良好模型,可以使其采取行动。我们通过屏蔽重建任务来实例化这个想法,类似于语言和计算机视觉中的BERT 和 MAE 对应任务。
我们的模型称为 RPT,是一个对感知运动标记序列进行操作的Transformer 。给定相机图像、本体感受状态和动作的输入序列,我们将交错序列编码为标记,屏蔽序列的随机子集,并从其余部分预测屏蔽内容。我们使用高掩蔽比在所有模式和时间上执行随机掩蔽,这鼓励模型学习跨模式、时空表示。
我们使用预先训练的视觉编码器对相机图像进行编码,并使用潜在的视觉表示进行感知运动序列学习。这使我们能够从互联网上的各种视觉数据中受益,这些数据不附带本体感受和动作信息。与像素空间中的预测相比,使用潜在视觉表示使任务更容易处理。最后,该设计将视觉成本与感觉运动上下文长度解耦,使得在物理机器人上使用具有超过3亿参数模型和上下文长度的10 Hz控制成为可能。
为了研究我们的预训练方法,我们使用运动规划和基于模型的抓取算法收集了一组超过20,000个真实世界轨迹的数据集。每个轨迹都是多视图相机图像、本体感受机器人状态和动作的序列。我们包括经典的电机控制和机器人任务,即单个物体拾取、箱子拾取、堆叠和卸垛,以及物体姿势、形状和外观的变化。
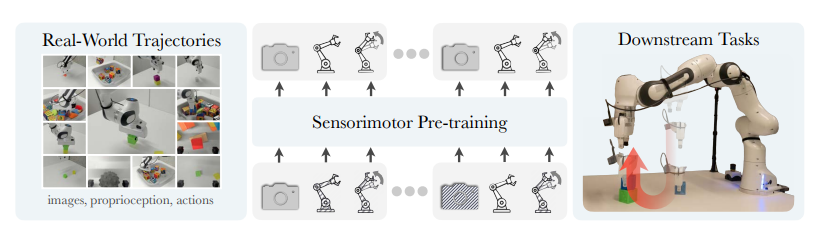
图1:使用传感器动作预训练的机器人学习。左侧:我们收集了一个包含多视角RGB图像、机器人本体感知状态和动作的大型真实世界轨迹数据集,用于自监督学习。中间:给定一个传感器动作轨迹,我们对其中的随机子集进行掩码处理(以斜线图案表示),并训练一个Transformer模型来预测被掩码处理的内容。右侧:我们使用预训练模型执行下游机器人任务。
为了了解预训练的效果,我们进行了一系列受控的现实世界实验,比较预训练和从头开始的训练。我们发现 RPT 始终优于从头开始的训练,并且对于更困难的任务,改进更大(最多 2倍于堆叠任务)。此外,我们的方法可以受益于来自不同任务的预训练数据、更好的视觉编码器和更长的感知运动上下文长度。与之前的工作一致,我们发现微调比线性探针评估更有效。最后,我们发现跨模态和时间进行遮盖,使用较高的遮盖比例对于良好的性能至关重要。
为了促进未来的研究,我们将公开所有代码、数据和模型。
2 相关工作
机器人学中的自监督学习。关于机器人学中的自监督学习已经有大量的研究成果:通过大规模的自监督学习来学习抓取策略;通过自监督的视觉对应关系学习视觉运动策略;根据抓取成功的反馈来校准学习到的特定物体的抓取策略;同时收集多个任务的机器人轨迹并学习相应的策略;在人类演示中使用辅助对比学习任务;从游戏数据中学习目标条件的机器人策略;利用多视角重构进行世界模型学习。总体而言,之前的工作主要集中在使用自监督学习来学习特定任务。相比之下,我们使用自监督学习来预训练通用的感知动作表征,可以将其迁移到下游任务中。
监督机器人的预训练。先前一些工作探索了机器人学中的多任务学习和预训练:BC-Z 进行了基于视觉的大规模模仿学习;使用跨域数据集训练策略;使用多任务Transformer策略学习操作;使用离线强化学习进行预训练;共同训练来自不同任务的通用代理。相比之下,我们采用了遮盖目标,使用潜在的视觉表示,并专注于物理世界。通过人类或专家演示训练了语言条件的Transformer策略。同样,我们利用Transformer模型,但专注于仅从感知动作轨迹中进行自监督学习。PaLM-E 通过一个具有实体化视觉问答模型的视觉输入来使语言模型与视觉输入相关。总体而言,我们与多任务机器人学习和机器人预训练的目标相符,但我们提出了一种通用的自监督预训练方法,仅从真实世界的感知动作轨迹中进行学习。
3 使用感知动作预训练的机器人学习
我们的模型RPT是一个基于Transformer的模型,它操作包含多视角相机图像、自感知机器人状态和机器人动作的感知动作流。我们首先在真实世界的机器人轨迹上进行带有屏蔽预测的预训练(图2)。然后,我们将该模型用于不同评估模式下的下游机器人任务,对应不同的遮盖提示(图3)。
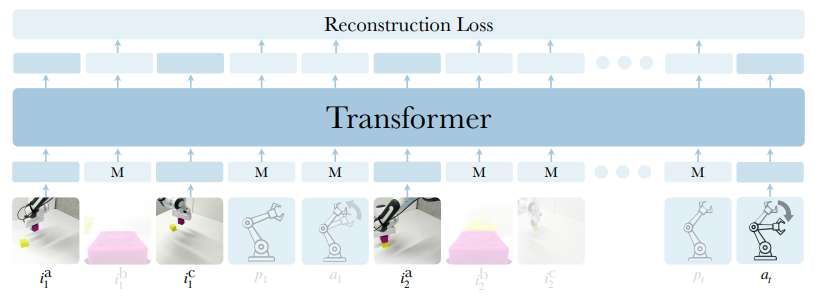
图2:带有掩码的感知动作预训练。给定一系列的相机图像、自感知机器人状态和过去的机器人动作,我们将交织的序列编码为标记,遮盖掉一个随机子集,并训练模型从剩余部分预测被掩码内容。
3.1 带有掩码的感知动作预训练
视觉潜变量。我们的模型必须处理来自多个视角的高维图像序列,从学习和计算的角度来看都是具有挑战性的。为了克服这个问题,我们使用一个预训练的视觉模型来计算视觉表示。这使我们能够利用来自各种互联网视频的大规模视觉数据,而无需自感知和动作信息。此外,与原始像素空间相比,使用潜在的视觉表示使得预测更加可行。最后,通过独立编码输入图像并在潜在视觉表示上进行操作,我们将视觉成本与感觉运动成本分离。这使我们能够扩展到大型视觉编码器、感觉运动模型和上下文长度,同时保持机器人的快速训练时间和推理速度。
标记编码器。我们为每个模态使用单独的线性编码器。由于我们的模态编码器不共享权重,因此我们不使用额外的模态嵌入,为了表示时间,我们为每个标记添加位置嵌入,同一时间步的所有标记共享位置嵌入值。
标记掩码。给定一系列感知动作标记,我们随机遮盖一部分。我们使用每个模态独立学习的遮盖标记来表示每个被遮盖的输入,并在时间上共享。我们独立地对输入标记进行遮盖,不考虑时间步或模态,这鼓励模型学习跨模态和时间的相关信息。
Transformer模型。编码和遮盖的标记序列传入Transformer模型。我们遵循标准的Transformer设计,由多个Transformer块和多头自注意操作组成。我们的模型预测与每个输入标记相对应的一组固定长度的潜变量表示。
预测目标。我们使用线性投影层将隐藏表示解码为预测目标。每个潜变量从隐藏尺寸解码回原始模态的维度。我们在关节的原始输入空间进行预测,而在图像的视觉潜变量空间进行预测。
遮盖目标。我们计算预测值与真实输入值之间的均方误差重建损失。我们仅对对应于被遮盖输入的潜变量表示的预测应用损失。观察到的输入的预测不会产生损失,为了加权不同模态的重要性和规模,我们应用了每个模态的损失权重。
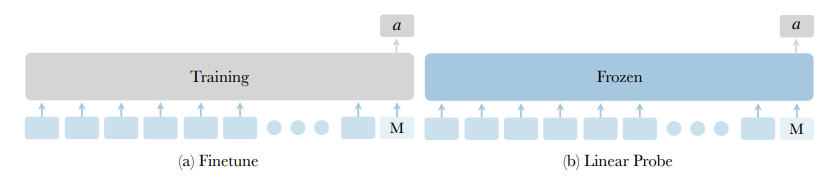
图3:下游评估。我们考虑两种不同的评估设置用于下游任务:(a) Fine-Tune 在下游任务上对整个预训练模型进行微调;(b) Linear Probe 冻结预训练模型并训练一个线性动作读取层。
3.2 下游评估
预训练的目标是学习可用于解决下游机器人任务的一般感知运动表征。在这里,我们重点关注语言和计算机视觉领域自监督学习文献中最常见的两种评估模式。
微调。使用预训练表示的一种方法是使用下游任务的数据对其进行微调(图 3a),这在下游数据量有限时特别有用。在这种情况下,预训练可以被视为为学习提供了良好的初始化。
线性探测。另一种方法是直接评估下游任务的预训练表示(图 3 b)。我们可以通过在冻结的感知运动表示之上仅训练线性动作预测层来实现这一点,我们将其称为线性探针评估。
4 感知动作轨迹数据集
为了研究我们的预训练方法,我们收集了大规模的真实世界机器人轨迹数据集。在本节中,我们将描述我们的数据收集过程,并展示数据集中的定性示例。
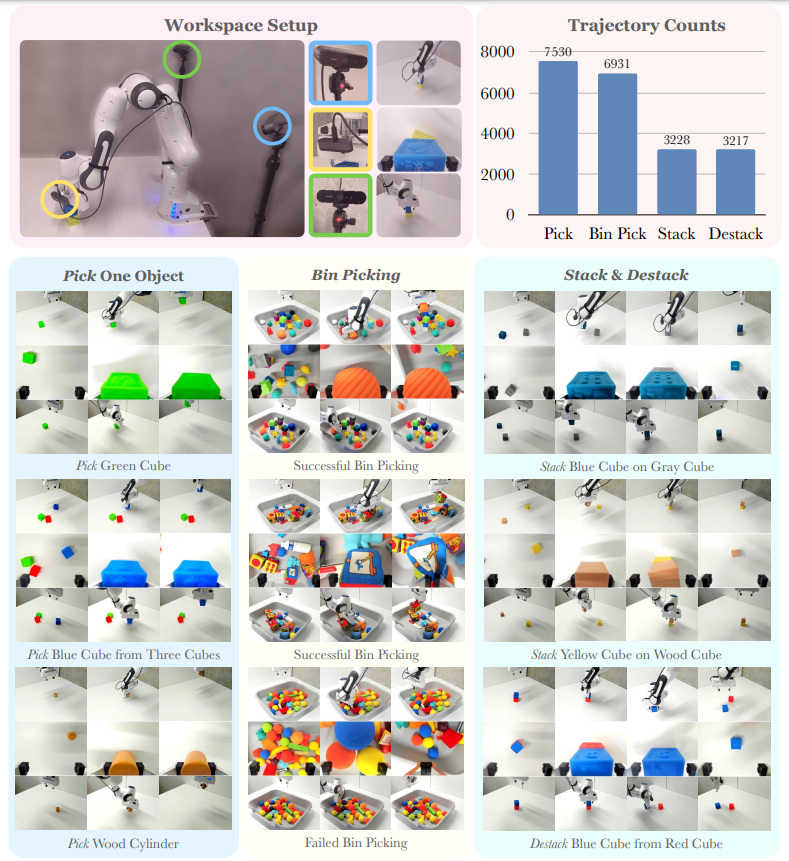
图4:数据集。我们使用Franka机械臂收集了一个包含超过20,000个真实世界轨迹的数据集。每个轨迹是由三个摄像头(一个连接在机械臂手部,两个连接在机械臂两侧)捕获的高质量图像序列,还包括关节位置信息和机器人动作。我们考虑了抓取、箱子拾取、拆堆和堆叠等任务,物体的位置、形状和外观在这些任务中有所变化。
硬件:我们使用Franka机器人,它有7个自由度的机械臂和一个平行夹持器(图4,左上角)。我们记录关节位置和速度等感知信息,我们将关节空间动作定义为连续状态之间的差异,工作空间配备了三个高质量的Logitech Brio彩色摄像头,一个自视角摄像头连接在机器人手上,两个外视角摄像头连接在机器人的左侧和右侧。我们以60 Hz的频率同步摄像头和机器人的数据流,并以30 Hz的频率保存数据。
(1) 抓取:机器人的任务是抓取并抬起一个立方体(从C个随机颜色的立方体中选择),该立方体位于桌子上的一个稳定姿态中的一个。我们编写了一个数据生成方案,其中机器人以在机器人坐标系中随机生成的3DoF姿态接收C个立方体,这些姿态不会发生碰撞,并为每个立方体连续生成一系列3DoF的抓取和放置姿态。然后,一个预定的策略来抓取立方体。在抓取后,机器人将抓取的立方体放置在下一个随机生成的姿态中,返回到起始关节配置,并开始下一个抓取动作。
(2) 拾取箱:机器人从一个灰色垃圾箱中拾取随机放置的软体和刚体物体(见图4)。我们使用一台高空置Realsense L515深度摄像头捕捉工作空间的深度图像,并将深度图像输入到完全卷积-抓取质量卷积神经网络(FC-GQCNN)中生成抓取姿态。每个抓取动作都以机器人移动到一个不遮挡深度摄像头观察工作空间的关节配置开始。在FC-GQCNN生成抓取姿态后,使用(1)中描述的预定策略来抓取物体。如果在轨迹的末端夹爪没有完全闭合,我们认为该轨迹是成功的。
(3) 堆叠和(4)拆垛 :从桌子上开始,有两个随机颜色的立方体,机器人首先将一个立方体移动到另一个立方体的上方,然后将堆叠的立方体放回到桌子上。立方体的姿态生成方式与(1)类似。对于堆叠,放置姿态的高度偏移了立方体的高度;同样,对于拆垛,抓取姿态的高度偏移了立方体的高度。然后,一个预定策略执行抓取和放置的轨迹。
统计数据:在9个月的时间内,我们收集了大约20,000个真实世界的轨迹(图4)。数据集中包括约7,000个单个物体抓取和垃圾箱抓取的轨迹,以及约3,000个堆叠和拆垛的轨迹。抓取和拆垛轨迹的平均长度约为300步,而堆叠轨迹的长度约为600步。数据集包含物体的姿态、形状和外观的变化,我们在图4中展示了示例轨迹的帧图像。
5 实施细节
视觉编码器。我们使用标准的视觉Transformer(ViT)架构对图像输入进行编码,并使用两个版本的ViT(ViT-Base和ViT-Large)进行RPT评估,分别具有86M和307M的参数。我们使用的预训练模型,这些模型是通过MAE 在Ego4D ,Epic ,Something-Something [31],100 Days of Hands 和ImageNet 的4.5M图像集合上进行训练的。我们使用相同的模型从所有三个相机提取特征。
感知动作Transformer。对于感知动作模型,我们使用一个仅包含大约1M参数的编码器-解码器Transformer。该Transformer的隐藏维度为192,包含四个Transformer块,每个块具有4个注意头,并且MLP比例为2.0。该Transformer可以接受具有不同上下文长度的感知动作输入。我们尝试使用1、4和16个步骤的输入,并在上下文长度为16时得到了最佳的经验性能。
预训练。我们采用统一的随机掩蔽策略,即对于每个标记,我们首先从预设范围中随机采样一个掩蔽概率,然后以相应的概率对标记进行掩蔽。我们考虑三种类型的掩蔽:(i)标记掩蔽独立地在不同的时间步和模态下对每个标记进行掩蔽,(ii)时间步掩蔽在同一时间步内对所有模态的标记进行掩蔽,(iii)模态掩蔽在同一模态下对所有时间步的标记进行掩蔽。详见图8进行说明,我们在第6.3节对不同的掩蔽概率和掩蔽类型进行了消融研究。
微调。我们通过模仿学习对预训练模型进行微调,用于下游任务。在微调过程中,模型采用与预训练中相同上下文长度的过去感知动作输入,将最后一个时间步的动作标记替换为掩蔽标记。然后,我们训练一个线性头部,从最后的输出掩蔽标记中预测接下来的16个步骤的动作。
6 实验
在本节中,我们进行经验评估,以展示以下内容:
(i)预训练的有效性(第6.1节),(ii)RPT在不同预训练数据上的泛化能力(第6.2节),以及(iii)核心设计决策的消融研究(第6.3节)。对于每个评估结果,我们报告了在16个真实世界试验中的任务成功率,其中对象的位置和旋转有所变化。
6.1 与从头开始训练的比较
我们首先通过比较有无预训练的微调性能来展示我们掩蔽预训练的有效性。我们保持相同的视觉编码器、感知动作架构,并对每个模型进行学习率、批量大小和训练长度的优化。我们考虑了三个难度递增的评估任务:拾取、解堆叠和堆叠。对于预训练,我们使用与微调相同任务的不同数据变体,并保留一个未见过的数据集进行评估。
在图5中,我们展示了随着微调演示数量增加的性能。我们观察到,相对于从头开始训练,预训练在各种任务和数据情况下都能带来一致的改进。此外,对于最难的堆叠任务,收益最大。这是一个长期任务,需要精确的空间定位和精细的动作控制,对于像我们在这里使用的端到端关节位置控制方法来说,这是一项特别具有挑战性的任务。
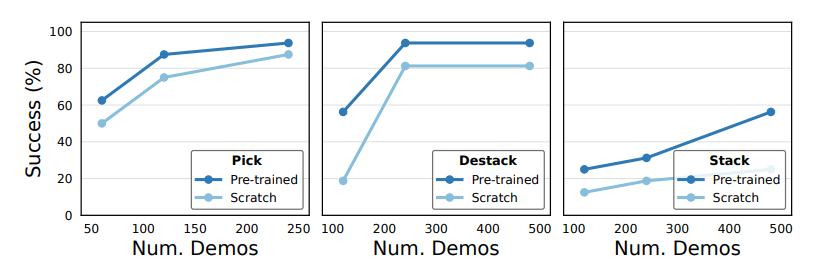
图5:样本复杂度,微调。我们研究了预训练对于随着微调演示数量增加的影响。我们观察到预训练相对于从头开始训练带来了一致的改进,并且在最难的叠放任务中获得了更大的收益。
6.2 对不同预训练数据的泛化能力
先前我们使用了来自相同任务的数据进行预训练和微调。为了验证掩蔽预训练实际上学习到的是一种通用的感知动作表示,而不是特定任务的表示,我们测试了在预训练和微调中使用不同任务数据时的性能。具体而言,我们首先在不同任务的数据上对模型进行预训练:堆叠、拾取、成功的箱子拾取轨迹和所有箱子拾取轨迹(图6,左侧)。然后我们对堆叠任务进行微调和评估。在图6的右侧,我们可以看到,当在堆叠、拾取或箱子拾取任务上进行预训练时,RPT在堆叠任务上获得了类似的性能,这表明我们的方法能够有效地从不同任务的数据中学习感知动作表示。我们还观察到,在对箱子拾取的不完美(包括成功和失败)轨迹进行预训练时,性能较低,这表明预训练数据的质量很重要。
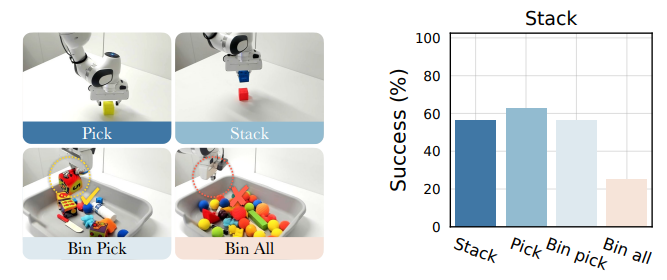
图6:预训练数据。我们评估在不同数据分布(左侧)上进行预训练的模型在堆叠任务上的性能(右侧)。我们观察到,使用成功轨迹进行预训练可以带来一致的改进,而包含失败轨迹的效果不如预期。
6.3 消融研究
视觉编码器。我们通过比较不同大小的视觉编码器来研究视觉特征的重要性。具体而言,我们在堆叠任务上测试了ViT-B和ViT-L。结果如图7左侧所示,我们观察到,将ViT-B切换为ViT-L可以显著提高成功率,这可能是因为堆叠任务需要精确的空间定位,而ViT-L的特征包含更多的空间信息。值得注意的是,即使将ViT-L作为视觉编码器(其中包含超过300M的参数),我们的模型仍能够进行实时推理。
上下文长度。我们比较具有不同输入上下文长度的感知动作模型。我们在堆叠任务上测试了上下文长度为1、4和16的情况。需要注意的是,上下文长度为1涉及跨越5个模态标记的预测。如图7中间所示,RPT在1步和4步输入上获得类似的性能,而在上下文长度为16时具有更高的成功率。
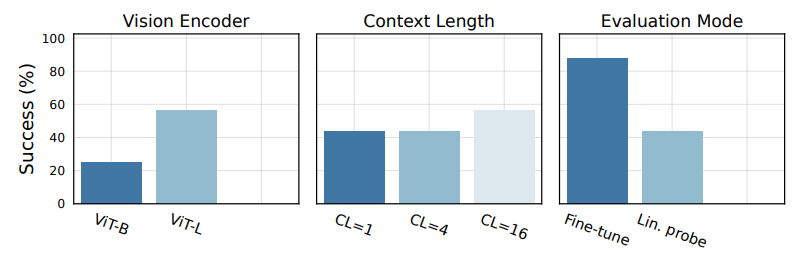
图7:消融研究。我们发现,我们的方法受益于更好的视觉编码器(左侧),更长的时间上下文长度(中间),并且微调比线性探针更有效(右侧)。
线性探测。为了评估从掩蔽预训练中学到的表示,我们冻结预训练的表示,并测试RPT的线性探测性能。我们在表示的顶部训练了一个线性头,使用了120个拾取演示。如图7右侧所示,线性探测达到了43.75%的成功率,与从头开始训练的基准模型(图5)的60个演示相当,这表明从掩蔽预训练中学到的表示已经包含了良好的感知动作表示。
掩码类型。在我们的预训练方法的核心是掩码的感知动作预测任务。我们假设掩码预训练通过学习跨时间和模态的结构化相关性,有助于下游任务。为了验证这一点,我们对只学习模态或时间相关性进行了消融研究。具体而言,我们测试了时间步掩码,它掩码了一个时间步内不同模态的标记,以及模态掩码,它掩码了一个模态内所有时间步的标记。这两种方法分别移除了模态和时间的相关性。结果如图8所示,我们可以看到,与独立对每个时间步和模态进行掩码的标记掩码相比,时间步掩码和模态掩码都得到了较差的性能。这为我们的假设提供了支持性的证据,即学习下游任务所需的时间和模态相关性都是至关重要的。
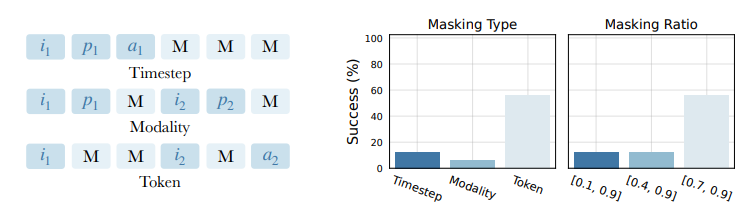
图8:掩码实验结果。我们发现随机对所有标记进行掩码的效果要比同时对一个时间步骤或一个模态中的所有标记进行掩码的效果要好得多。此外,我们还发现高掩码比例对于学习良好的感知动作表示至关重要。
掩码比例。我们评估了不同的掩蔽比例选择。之前在掩蔽视觉预训练方面的研究发现,较高的掩蔽比例是有帮助的。在我们的实验中,我们也得到了类似的观察结果。如图8所示,当掩蔽比例在[0.1, 0.9]或[0.4, 0.9]之间时,与[0.7, 0.9]相比,性能显著下降,这表明输入的感知动作序列中不同时间步和模态之间存在较高的冗余,而高掩蔽比例对于学习下游任务的有用表示是至关重要的。
推理速度。我们的感知动作模型设计为在每个图像上计算的潜在视觉表示上进行操作,这将视觉模型与感知动作模型解耦,使得视觉计算成本与感知动作上下文长度无关。这使得我们可以使用大型视观模型(高达307M参数),同时以10 Hz的速度进行推理。相比之下,另一种机器人Transformer设计使用了一个含有14M参数的模型,运行速度为3 Hz。这表明我们的模型在保持高推理速度的同时,能够利用大型视觉模型进行训练,从而获得更好的性能。
7 讨论
限制:为了研究我们的预训练方法,我们收集了单个机器人在单个实验室中的物理传感器动作轨迹数据集。虽然这是一个良好的初始步骤,可以通过控制实验来了解我们的方法,但在多样性和真实性方面存在重要限制。因此,未来的研究应该致力于将我们的方法扩展到更多样化的环境中,以提高其泛化能力。
结论:我们描述了一种基于传感器动作预训练的机器人学习方法。我们的模型是一个基于Transformer的模型,操作的是传感器动作序列。我们通过掩码预测对模型进行预训练。我们发现,对这些数据进行预训练始终优于从头开始训练,在堆叠任务中实现了2倍的改进,并且具有良好的可扩展性。
