对于地质学家来说,确认矿物质的种类是一个复杂而耗时的问题,通常每个样品的确认时间需要30分钟至数天不等。更加复杂的是,目前已确认的矿物质中,多数研究仍然不够充分,只有约六千种中的几百种被全面研究过。
在地质学中,通过视觉诊断来识别矿物质和岩石是一种常见的实践方法,因为相比其他方法(如光谱学和化学分析),这种方法更加廉价和快速。然而,与更昂贵的方法相比,它耗时并且不够准确。即使是经验丰富的矿物学家在处理罕见的材料或低质量的样本时也可能出错。将机器智能应用于这个过程可以帮助识别错误并减少专家在例行工作上所花费的时间。
尽管在这个领域有着不断进行的研究,但在科学文献中缺乏对矿物图像分析的明确基准。为了填补这一空白,人工智能研究所与Sber AI和莫斯科国立洛蒙诺索夫大学合作,创建了一个专注于矿物认知的计算机视觉模型基准数据集。
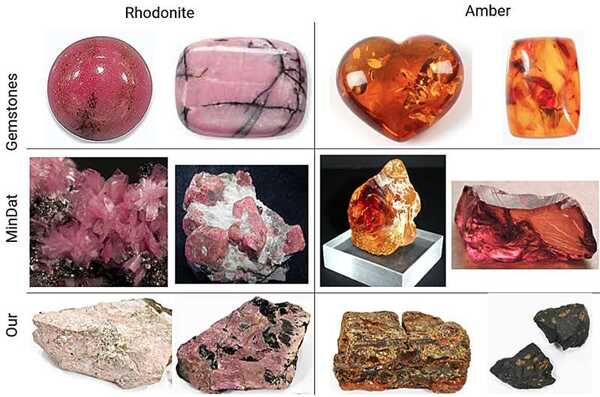
我们称之为MineralImage5K数据集。它基于费尔斯曼矿物学博物馆的收藏,包含四万四千个样本。虽然比Mindat数据集小,但MineralImage5K提供了更加统一的照片条件,并且由未经处理的样本组成,非常接近自然矿物。
MineralImage5K数据集分为三个不同复杂性的子集,挑战矿物分类、分割和尺寸估计的研究人员。基准中最简单的分类任务包含了十个矿物种类,每个种类至少有462个示例。最棘手的问题是仅根据一张图像将矿物分类为5000个类别。
当处理矿物照片时,人工智能可能会遇到一个问题,即如何确定所呈现的岩石中哪一部分才是实际感兴趣的矿物。为了解决这个问题,我们提供了大约100张附加标签和分割任务的独立图像集合,除了分类任务外。将分割任务整合到分类流程中,可能在模型出现错误时提供额外的见解,并减少此类情况的数量。
除了分类和分割,我们还研究零样本矿物尺寸估计。自动样本尺寸估计对于博物馆样本存储程序非常有用。通过拥有所有样本的这些数据,我们可以计划出最佳的存储系统,并购买或制造合适尺寸和正确数量的盒子。因此,我们在基准中提供了超过1.8万个带标签的样本,用于回归任务。
为了证明基准的有效性,我们评估了一个在通用领域数据上预训练的视觉语言模型。我们发现,对基于MineralImage5K等特定领域数据集进行微调可以显著提高其准确性。我们还强调了跨数据集评估的有希望潜力,用于评估矿物认知模型。
我们的研究发表在《计算机与地球科学》杂志上。我们非常乐意帮助使用该数据集和基准,并邀请所有感兴趣的研究人员分享他们对让其对社区更有用的想法。