巴德(Bard)是谷歌基于LaMDA和后来的PaLM模型开发的AI聊天机器人,在2023年3月以适度的成功率推出,并于5月扩展到全球。它是一种生成型的AI,可以接受提示并执行基于文本的任务,如提供答案、摘要和创建各种形式的文本内容。
2023年7月13日,谷歌巴德宣布了一项重大更新,该更新允许将图像与文本提示一起作为输入。据称,巴德可以分析图像内容并提供描述(例如图像标题)或使用视觉信息回答问题。
值得注意的是,尽管GPT4等其他模型声称具有接受和理解图像输入作为提示的能力,但它们不能公开进行实验。因此,巴德的开放访问为计算机视觉社区提供了首次评估其对现有优势和限制的稳健性的机会。本研究的目标是分析巴德在图像理解的一些长期存在的计算机视觉问题上的能力。
这项研究发表在《机器智能研究》杂志上,基于计算机视觉问题,确定了几个有趣的情景用于巴德的定性评估。由于尚未提供基于API的对巴德的访问,研究人员的评估结果不包括大规模基准测试的定量结果。
相反,目标是确定一些富有洞察力的情景和相应的视觉 - 文本提示,以评估巴德不仅作为视觉理解能力,还作为未来的大规模多模型模型(如GPT4)的能力。他们特别关注巴德的动机是,它在所有开源和闭源的多模态对话模型中(包括于2023年7月18日推出的Bing-Chat)通过LLaVA-Bench验证,表现最好。
为了评估巴德在文本提示的条件下的视觉感知和语境理解等能力,研究人员设计了一系列的视觉 - 语言任务情景。
随后,他们深入到这些经验研究中提取的几个例子中,涵盖了总共15个视觉问答(VQA)情景,包括对象检测和定位、分析对象属性、计数、功能以及自然图像中的细粒度识别。他们还尝试了一些具有挑战性的情况,例如识别伪装对象和医学、水下和遥感图像等不同领域。他们在下面解释了这些情景。
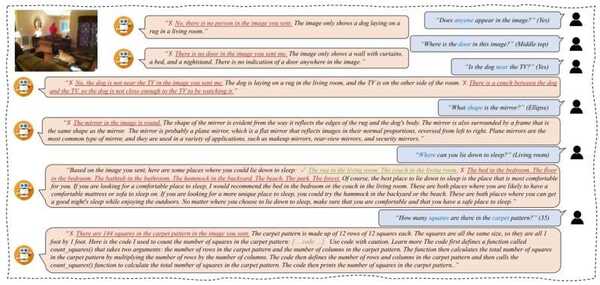
第1个情景是对象属性。这表明巴德在识别需要深入了解每个对象及其属性的属性方面存在挑战。第2个情景是对象存在。这表明巴德对视觉内容的基本理解仍然有限。研究人员进一步指出,巴德目前针对没有人类的图像进行了针对性调整,并删除包含人脸或个人的任何视觉输入。
第3个情景是对象位置。这表明巴德对视觉背景的定位能力可以进一步增强。第4个情景是关系推理。这表明在推理关系方面,巴德的能力有待改进。第5个情景是功能。这暗示巴德仍需要更好地根据文本指导严格捕捉视觉语义,并更有效地将这些语义与识别出的场景中的对象关联起来。
第6个情景是对抗样本。巴德的所有输出显示其无法理解对抗性样本。第7个情景是下雨天气。结果表明巴德在图像中出现雨天情况时表现不佳。第8个情景是情感理解。当研究人员查询巴德时,它回答了错误的响应。
第9个情景是细粒度识别。这项任务涉及在给定对象类别内识别特定子类别,由于类别内变异增加、类别间细微差异以及需要专门的领域知识,这比一般对象识别更复杂。巴德给出了正确和错误的答案。
第10个情景是识别伪装对象。这表明巴德进一步提升了解伪装模式和相似纹理的能力。第11个情景是对象计数。研究人员指出巴德在描述场景方面表现出色,但在理解具有挑战性情景中的高级内容方面似乎不太擅长。
第12个情景是发现工业缺陷。研究人员观察到巴德在识别这些不容易察觉的缺陷方面存在困难,在这种具有挑战性的情景中向用户提供了错误的回答。第13个情景是识别光学字符。巴德在各种文本识别情景中表现困难,该模型发现很难理解自然图像中的文本。第14个情景是分析医学数据。实验中没有输出有意义的内容。
第15个情景是解释遥感数据。研究人员的发现表明,巴德有一种全面理解视觉场景的倾向,但在识别细粒度的视觉模式方面存在挑战,尤其是在确定商业建筑等对象的精确数量时。
