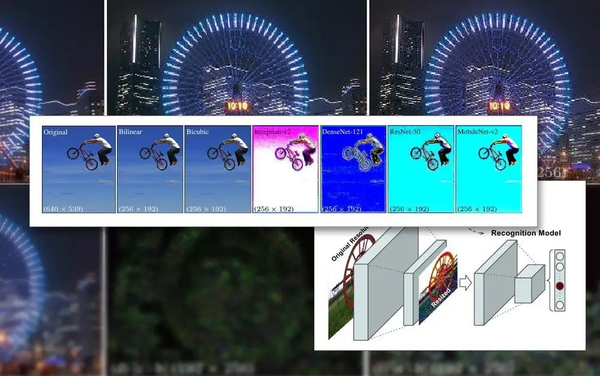
Google Research提出了一种新的方法,通过改进数据集中图像在预处理阶段的收缩方式,来提高基于图像的计算机视觉训练工作流程的效率和准确性。
在论文《Learning to Resize Images for Computer Vision Tasks》 (《为计算机视觉任务学习调整图像大小》)中,研究人员Hossein Talebi和Peyman Milanfar利用CNN创建了一种新的混合图像调整大小体系结构,该架构显着改善了在四个流行的计算机视觉数据集上获得的识别结果。
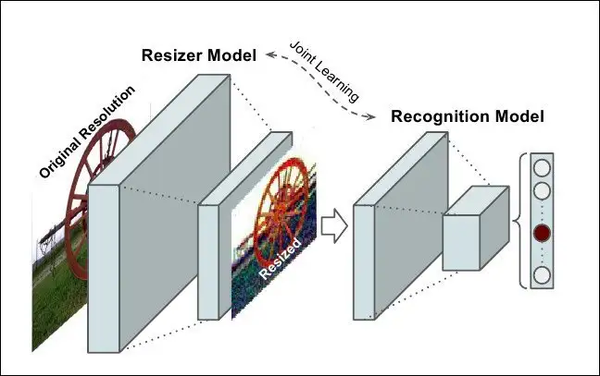
用于识别和调整大小的拟议联合框架
这篇论文观察到,目前在自动机器学习管道中使用的缩放/调整大小的方法已经过时了几十年,经常使用基本的双线性、双三次和最近邻调整大小的方法,这些方法不加区别地处理所有像素。
相比之下,本文提出的方法通过CNN增强图像数据,并将该输入整合到最终通过模型架构的调整大小的图像中。
人工智能训练中的图像约束
为了训练一个处理图像的模型,一个机器学习框架将包括一个预处理阶段,在这个阶段,不同大小、颜色空间和分辨率的不同图像(将有助于训练数据集)被系统地裁剪和调整为一致的维度和稳定的、单一的格式。
一般来说,这将涉及到一些基于PNG格式的折衷,在处理时间/资源、文件大小和图像质量之间进行权衡。
在大多数情况下,处理后图像的最终尺寸非常小。下面我们看到了一个80×80分辨率图像的示例,其中生成了一些最早的deepfakes数据集:

由于人脸(和其他可能的主体)很少符合所需的正方形比例,因此可能需要添加黑条(或允许浪费空间)以使图像均匀化,从而进一步减少实际可用的图像数据:
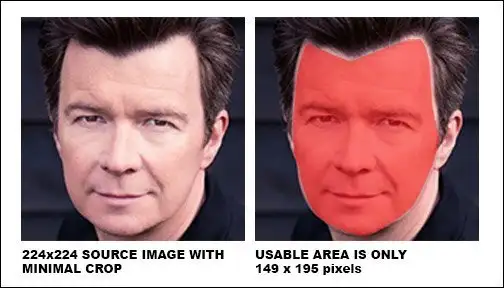
在这里,人脸是从更大的图像区域中提取出来的,直到被尽可能经济地裁剪以包括整个人脸区域。然而,如右图所示,大部分剩余区域在训练期间不会被使用,从而增加了调整后数据图像质量的重要性的权重。
随着近年来 GPU 功能的改进,随着新一代 NVIDIA 卡配备越来越多的视频 RAM (VRAM),平均贡献的图像大小开始增加,尽管 224×224 像素仍然是相当标准的(例如,它是ResNet-50数据集的大小)。
未调整大小的 224×244 像素图像
将批量文件装入VRAM
这些图像必须是相同大小的原因是,梯度下降法(模型随时间改进的方法)需要统一的训练数据。
图像必须如此小的原因是必须在小批量训练期间将它们加载(完全解压)到VRAM中,通常是每批6-24个图像。每批图像太少,除了延长训练时间外,没有足够的组材料来很好地概括;太多的话,模型可能无法获得必要的特征和细节。
训练架构中的“动态加载”部分被称为潜在空间。这就是从相同的数据(即相同的图像)中反复提取特征,直到模型聚合到一种状态,在这种状态下,它已经拥有了所有需要的广义知识,以便对以后不可见的类似类型的数据进行转换。
这个过程通常需要几天的时间,但它可能需要一个月或更长时间的持续的、不间断的、高容量的、24/7的思考来实现有用的归纳。VRAM大小的增加只在一定程度上有帮助,因为即使是图像分辨率的微小增加也会对处理能力产生数量级的影响,而对精度的相关影响可能并不总是有利的。
使用更大的VRAM容量来适应更大的批处理大小也是有利有弊,因为由此获得的更高的训练速度可能会被不那么精确的结果所抵消。
因此,由于训练体系结构是如此受限制,任何能够在现有管道的限制范围内影响改进的东西都是一个显著的成就。
如何帮助调整大小
训练数据集中包含的图像的最终质量已被证明对训练结果有改善效果,特别是在物体识别任务中。2018年,Max Planck智能系统研究所的研究人员认为,重采样方法的选择显著影响了训练的表现和结果。
此外,谷歌先前的工作(由这篇新论文的作者共同撰写)发现,通过保持对数据集图像中的压缩工件的控制,可以提高分类精度。
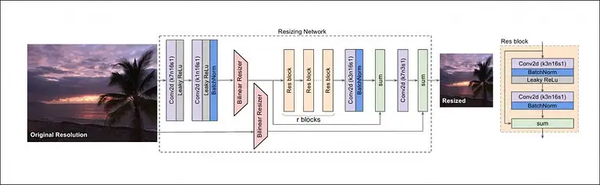
Google Research 的 CNN 架构提出了下采样算法
新重采样器内置的CNN模型结合了双线性调整大小与“跳跃连接”功能,可以将训练网络的输出纳入调整大小的图像。
与典型的编码器/解码器架构不同,新的方案不仅可以作为前馈瓶颈,还可以作为向任何目标尺寸和/或纵横比伸缩的反向瓶颈。此外,“标准”重采样方法还可以替换为其他任何合适的传统方法,如Lanczos。
高频细节
新方法产生的图像实际上似乎是“烘焙”的关键特征(最终将被训练过程识别)直接到源图像。从美学的角度来看,结果是非常规的:
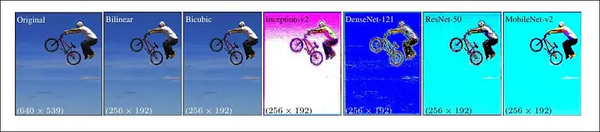
新方法应用于四个网络——Inception V2;densenet - 121;ResNet-50和MobileNet-V2。Google Research图像降采样/调整大小方法的结果产生了具有明显像素聚合的图像,预测了在训练过程中将被识别的关键特征。
研究人员注意到,这些初始实验专门针对图像识别任务进行了优化,在测试中,他们的CNN驱动的“学习调整器”能够在此类任务中实现改进的错误率。研究人员打算在未来将该方法应用于其他类型的基于图像的计算机视觉应用。
原文链接:https://www.unite.ai/better-machine-learning-performance-through-cnn-based-image-resizing/
