摘要
机器学习模型中的数据表示对其性能有很大影响。这对于在嘈杂的中等规模量子 (NISQ) 设备上实现的量子机器学习模型变得更加重要。在不丢失任何信息的情况下,将高维数据编码到 NISQ 设备的量子电路中并非易事,并且带来了很多挑战。虽然简单的编码方案(例如用于编码高维数据的单量子比特旋转门)通常会导致电路内的信息丢失,但具有纠缠和数据重新上传的复杂编码方案会导致编码门数的增加。这不太适合 NISQ 设备。这项工作提出了“增量数据上传”,这是一种用于应对这些挑战的高维数据的新型编码模式。我们将给定数据点的特征向量的编码门分布在整个量子电路中,并在它们之间使用参数化门。这种编码模式可以以最少的预处理要求更好地表示量子电路中的数据。我们使用 MNIST 和 Fashion-MNIST 数据集展示了我们的编码模式在分类任务中的效率,并通过分类精度和模型的有效维度比较了不同的编码方法。
1.引言
最近,量子计算领域引起了科学界不同领域的兴趣激增。随着IBM和谷歌等几家厂商实现了量子位和保真度不断增加的量子器件,量子计算的研究开始从理论研究转向应用研究。目前,人们正在探索用于信息处理和计算目的的量子设备,以克服传统硬件在不同行业领域(如金融、网络安全和化工)所造成的许多限制。来自不同科学技术领域的研究小组正在研究众多启发式和非启发式的量子计算方法,以解决给定问题并实现量子霸权。
然而,当前量子比特数量和低门保真度的限制使得非启发式方法难以实现。
因此,启发式方法,特别是在机器学习(ML)领域,被认为是NISQ时代实际量子计算的主要候选者之一。虽然经典 ML 已经非常成熟并且具有数十年的特定领域增强功能,但其量子对应物仍然是一个活跃的研究领域,具有许多松散的结局和不确定性。将来自 NISQ 设备的因素(如低门保真度和量子位连接限制)添加到这种不确定性的混合中,基于学习的方法(如量子机器学习 (QML) 和量子强化学习 (QRL))变得更加复杂。
在基于门的量子计算和量子机器学习领域中,对于给定问题选择最优变分量子电路(VQC)的问题是至关重要和有意义的。量子电路中用于QML的门被分为三类,即编码门、解码门和变分门。这些编码门、解码门和变分门在许多QML作品中被进一步分为编码层、解码层和变分层,尽管这些层只是一种视觉表示,并不能反映经典的QML中层背后的理论。编码门是根据所选择的编码方法和输入特征的数量来选择的。编码方法的最佳选择对QML模型的成功学习至关重要,因为这代表了输入到电路的经典信息。虽然之前就已经研究了不同编码方法对VQC的数据表示和表达的影响,但据我们所知,我们提出的编码模式(参见第二节)在以前的文献中没有讨论过。
编码门集定位成为基于VQC的QML模型从高维数据中学习的一个显著因素,这是由于量子设备的尺寸限制,在量子比特的数量和QC的深度方面,可以在模拟和真实设备上执行。对于固定电路深度和门数,这种限制会在编码门的数量和参数化门的数量之间进行权衡。输入的维度越大,所需的编码门的数量就越大,使用的编码门的数量就越多,可以使用的参数化门的数量就越少。参数化门数的减少降低了模型的表现力。这种输入维度的降低会导致信息丢失。在电路开始时对数据进行编码或者像数据重新上传这样的编码模式,对于高维数据来说并不是很有希望,因为这会导致QC深度和门数的增加,或者数据中的信息变得不太容易被模型访问。
本文研究了编码门集定位对QML模型可训练性的影响,提出了一种高维输入的编码模式,如图1所示。我们的方法背后的关键概念是增量上传。
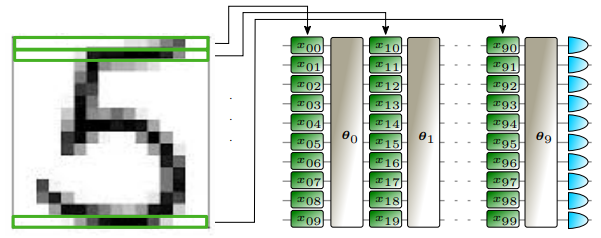
图 1:提议的方法:图像被缩小到 10 × 10,然后逐行馈送到 10 位量子电路,每个编码层(绿色)后面跟着一个变分层(灰色),然后测量 10 个量子位( 蓝色的)。
我们在图像分类任务(即 MNIST和 Fashion MNIST)上评估我们的方法,因为图像输入是具有各种实际意义的最常见的高维输入之一。虽然使用 QML 对 MNIST 进行分类并不新鲜,即早期工作使用大幅缩小的 4×4 图像进行二进制分类或使用量子技术进行降维和分类,截断数据集或使用降维仅适用于容忍这些信息丢失的简单分类任务。另一种有效处理高维图像数据的方法是量子卷积神经网络。然而,这不是一种纯粹的量子方法,输入图像被分解成更小的块并顺序馈送到电路中,导致运行时间更长,然而,为了展示如何处理更复杂的分类任务,我们使用完整 MNIST 数据集的高维表示。
2.方法
VQC中的量子门可以分为三类:编码层、解码层和变分层。由于电路深度的限制和避免可能的贫瘠高原效应,QC 的设计方式必须允许在给定的门数和电路深度下实现最大的分类性能和表现力。为此,我们研究了编码层定位对QML模型性能的影响,方法是将编码层分解为更小的编码层,并逐步增加VQC中各层之间的变分参数数量。此外,我们还想在本文中介绍用于分组编码门的命名法。从这里开始,所有编码门的集合被称为一个编码块,而分成更小的编码门组的编码块被称为编码层。
用于图像数据的编码块的明显分解将用于对输入图像的每一行的原始特征进行编码的门进行拆分和分组。这些按行分组的编码门(以下称为编码层)可以根据设计选择在 VQC 中自由移动,尽管每次移动都会导致不同的架构,从而影响模型的性能。因此,我们设计了五种不同的编码块分割模式,它们之间具有增量数量的参数化门。这些电路如下: IDU 1,这里,编码层之间没有变分层。所有编码门都放在开头,然后是所有变分层。 IDU 2、IDU 4、IDU 8、IDU 10 分别代表编码块被分成 2、4、8 和 10 部分的电路。在每个拆分之间,有一个变分层,其余的变分层附加在最后。任何两个编码层之间的变分层数量都限制为一个,因为我们想分析通过在它们之间引入最小且恒定数量的变分层所获得的性能提升。这种限制只是一种设计选择,其他设计选择当然是可能的。该编码模式的整体工作如图 2 所示。我们称这种编码模式为增量数据上传 (IDU)。将该模式的性能与数据重新上传 (DRU) 编码模式进行比较,根据Skolik等人的评估指标和Schuld等人的理论支持,DRU编码模式被认为是遵循 Skolik 等人的评估指标的最新技术。然而,为了进行公平的比较,QML模型的参数数量保持不变。因此,在DRU架构中,整个图像信息被编码到电路中,然后是一个变分层,这个过程不断重复,直到变分参数的数量与增量数据上传实验中使用的参数数量相匹配。
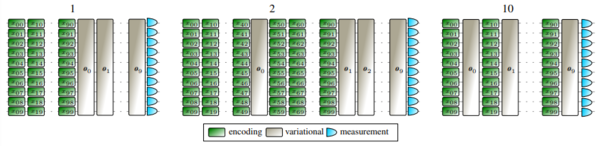
图 2:交错层的不同拆分。 对于 1-split,有 10 个编码层,然后是 10 个变分层,对于 2-split,有 5 个编码层,然后是 1 个变分层,然后是 5 个编码层,然后是剩下的 9 个变分层。 建议的 10 分割是交织编码和变分层。
3.评估
3.1数据统计
我们的实验是使用 MNIST和 Fashion-MNIST数据集进行的。 MNIST 是一个手写数字数据集,由 70,000 张图像组成,代表数字 0-9,每个图像的大小为 28 × 28 像素。每个数字类大约包含 5,400 - 6,750 张图像。 70,000 张灰度图像的数据集被随机分组为 48,000 张用于训练的图像、12,000 张用于验证的图像和 10,000 张用于评估的图像。由于我们的量子实验在经典硬件上使用 Tensorflow Quantum 和 Cirq 模拟器,因此更深、更大的电路在计算上变得难以处理。为了减少计算时间,我们使用双线性滤波器将图像的大小从 28 × 28 减小到 10 × 10,以便对数据进行编码所需的编码门数很小。同样,Fashion MNIST 也是由 70,000 张大小为 28 × 28 的灰度图像组成,代表 10 个类别的衣服。至于 MNIST,我们减少了图像大小,从而减少了整体计算时间。
3.2量子编码、变分和解码层
我们所有的数据集都包含 10 个类。 因此,我们设计了一个 10 量子比特的量子电路以及 softmax 函数来学习映射函数 ,其中 是具有 个数据点的数据集, 是数据点属于每个类别的概率。 量子电路由多个编码和变分层组成,如下所述。
将经典数据点 嵌入量子电路的过程通常称为数据编码,有时也称为数据上传。在实践中,将数据点编码到量子电路中的最常见方法之一是通过状态准备电路作用于计算基础中的状态 。状态准备电路通常由与 的维度匹配的单个量子比特旋转门组成,有或没有纠缠门,因此 的每个原始特征都可以在 之间缩放并用作旋转角用于状态准备电路中的一个门。我们选择了总共 100 个与每个数据点 的特征维度相匹配的单量子比特旋转门 作为我们所有实验的编码层。 门分为十组,每组作用于一个量子位。 中的每个像素值(范围在 之间)被缩放到 并作为编码门的旋转角度馈送。
变分层保存可学习的参数,这些参数使用梯度下降进行优化以逼近映射函数 。 在量子电路中,变分层再次使用单量子位旋转门和多量子位纠缠门实现,其中旋转门的旋转角度作为可学习参数。 我们的变分层由具有最近邻受控 纠缠的单量子比特 旋转门组成。 具有编码和变分层的完整量子电路如图 3 所示。该电路在计算基础上进行测量,单个量子比特的期望值与 softmax 函数一起用于类预测。

图 3:单个编码块,后跟一个变分层。 编码块和变分块以不同的间隔重复 10 次以形成不同的架构。
3.3增量数据上传
我们使用表示编码层中不同分割的每个架构来实现我们的间隔上传方法。我们使用 ADAM 优化器 [23] 在所有数据集上以 0.001 的学习率为 25 个 epoch 训练每个架构。
从图4中我们可以推断出编码层的分割与模型的性能之间存在直接的相关性。编码块之间的变分层数越多,在训练和测试阶段映射函数的逼近性越好,分类的准确性越高。具有十个编码块的体系结构的最高准确率约为60%。我们在Fashion MNIST上观察到了相同的模式。

图 4:编码层中具有不同拆分的量子电路在 5 次训练运行中的平均验证准确度及其标准偏差。 DRU代表Data Reuploading method,数字1、2、4、8、10代表1个完整编码层的量子电路,编码层分别分为2、4、8、10个块。
为了验证间隔上传方法不依赖于数据,并且有望用于任意分类任务的论点,我们使用随机选择的固定排列对MNIST数据集中每张图像中的每个像素值进行了混洗。在这个打乱的MNIST数据集上训练的模型也显示出与其他数据集相同的模式。这些模型的试验精度如表1所示。
表1:测试集上的间隔上传性能。

3.4 IDU 在“更深”的电路中
从图4和表1可以清楚地看出,采用数据重新上传类型编码的量子体系结构表现出与性能最差的IDU体系结构相似或更低的性能。直观地说,这是一个预期结果,因为用于数据重新上传架构的数据是一个缩减的数据集,其中每个图像在其列上求和。 这种求和会导致信息丢失,从而导致模型性能下降。 然而,具有单个编码层的架构在图像列上执行相同的求和(因为只有 Rx 门用于编码)并且性能略好于 DRU 架构。 使用 DRU 编码的模型性能不佳可能与变分层的低表达能力有关。对这一假设的解释见第4.2节。
为了进一步验证这一假设,我们将变分层的参数数量从20个增加到60个,以提高模型的可训练性,如图5所示。这反过来又提高了DRU架构的性能。对于相同参数数的DRU,参数数越多的DRU的精度就越好。然而,与所有拆分大于两个的 IDU 架构相比,DRU 的性能仍然显著降低。表2显示了参数数量较多的不同架构的结果。
表2:在“更深层次”架构上的性能。
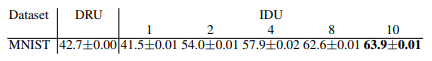
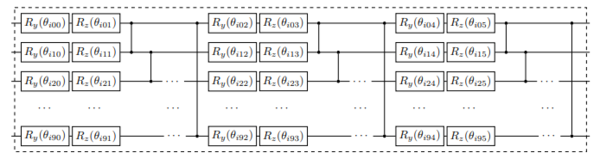
图 5:在更深层模型中使用的具有 60 个参数的变分层。
3.5用于高级编码方案的 IDU
顺序使用单量子位 类型编码门会导致沿列对输入图像数据进行部分或全部求和,从而导致一些信息丢失。 为了在不影响求和效应的情况下进一步验证 IDU 型编码模式的效果,我们测试了其他两种编码方法:(1) 编码,其中我们对每一行使用一系列交替的 旋转门 图像而不只是 门,见图 6;(2) 编码,它类似于 编码,但在 门之间使用 门,见图 6。
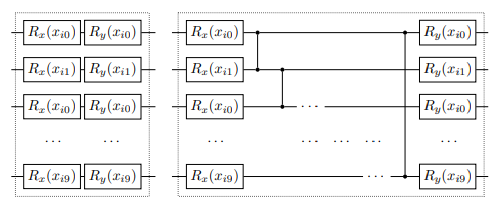
图 6: 类型编码(左)和 类型编码(右)的单个编码块。
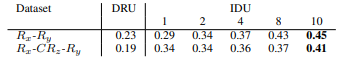
两种编码方法对MNIST数据集的分类结果如表3所示。我们看到增量式数据上传类型编码模式的作用更为普遍,并且不局限于单量子位 类型编码。请注意,编码方法是简单的设计选择,其中编码门不通勤。这些编码方法并没有针对MNIST数据集进行优化,因为实验的目的是研究增量数据上传对不同编码方法的影响,而不是编码方法本身对MNIST数据集的影响。
表3:在高级编码方法上的增量数据上传性能。
4.理论考虑
4.1可训练性和可表达性的量化
ML 模型的两个重要属性是其可表达性和可训练性。Abbas等人将定量分析工具推广到量子领域。这两个概念都基于与统计模型 相关的Fisher 信息矩阵(FIM)VQC。在实践中,我们使用定义为的经验 FIM
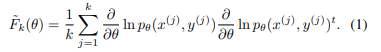
这里, 是i.i.d. 从联合分布 中得出。对于MNIST数据集,输入 和标签 。然而,以下考虑可以推广到任何有限维度的数据。
FIM 捕获参数空间的几何形状,这对模型的可训练性具有至关重要的影响。 为了评估这一点,考虑了正半定矩阵的谱,即其特征值的分布。 退化的谱表示参数空间失真,这对于任何基于梯度的优化技术都是不利的。 此外,随着模型大小(即量子比特数)的增长,特征值在零附近的不断积累表明存在贫瘠的高原。
有效维度是捕捉 ML 模型的可表达性或容量的工具。 它基于(经验)FIM,因此可以通过抽样相对简单地估计。 统计模型 的有效维度定义为

其中 是参数的数量, 是参数空间的体积, 是(经验)FIM 的归一化版本。 参数 捕获参数空间的有效分辨率(即与数据可用性有关)。 它在归一化因子 中输入定义。 在某些条件下,有效维度提供了泛化误差的上限。 用更简单的话来说,该度量量化了给定模型可以近似的不同函数的范围。 为了比较不同的模型,有效维度的归一化版本更可取。 除以 将度量限制在 范围内,其中较高的值表示更可表达的模型。
经验 Fisher 信息矩阵是使用来自 MNIST 数据集的 200 个随机样本 和 100 个随机参数集 估计的,其中 200 个参数均来自范围为 的均匀分布。 图 7 显示了针对不同 IDU 架构的 4000 多个样本的 FIM 的特征值谱。出于演示的原因,直方图切割大于 1 的值,无论如何这不会改变整体情况。 图 8 显示了从 到 样本大小的不同 IDU 架构的归一化有效维度。图 7 中显示的结果表明,对于具有更高分割数的 IDU 架构,特征值谱变得更加均匀。 当考虑图 7 底部所示的累积和图时,这种归一化效果变得更加明显。
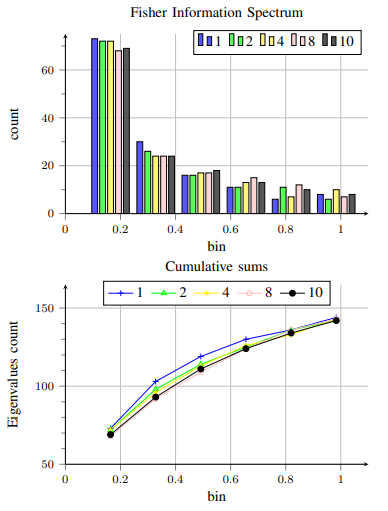
图7:Fisher信息
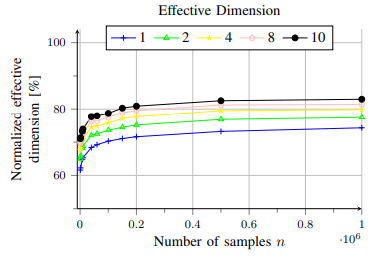
图 8:不同 IDU 架构的有效维度。
尽管在所考虑的实例中归一化效果的特殊性非常小,但它表明在采用所提出的方法时可训练性有所提高。 由于频谱更均匀,接近零的特征值更少,参数空间的失真更小,这有利于优化方法。 有效维度方面的差异更加明显,即当使用更多 IDU 层时,它明显增加。 这表明模型可表达性增加,而参数数量保持不变。 在所有情况下,归一化的有效维度随着参数空间的更大分辨率而增长,这对于机器学习模型来说是一种合理的行为。
4.2频谱
为了更深入地了解前几节中观察到的性能差异,下面我们研究不同架构所代表的功能类。 稍微概括设置,我们在下面考虑 并用列向量 表示矩阵的第 行,即对于 , 。因此,向量 对应于图 1 中第 个编码层中馈送的数据。Schuld等人表明,当每个编码层由围绕每个量子位的给定轴的单量子位旋转给出时,由 VQC 表示的函数 是傅里叶和。 特别是,变分层确定振幅,而频谱由数据编码层固定。 参照Ref.[12],我们发现
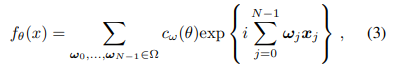
其中 是频谱, 是包含 作为第 行的矩阵。由于 是实值,我们发现 。更直观地说,这些函数表示频率为 的 维傅立叶和。请注意,系数 仅是独立的,并且如果变分层是通用的,则可以自由选择,即可以表示任何酉矩阵。在实践中,电路的表达能力可能会受到变分参数数量的严重限制,事实上,一般的 量子比特单位需要在量子比特数量上呈指数级增长的许多参数。然而,方程(Eq.(3))定性地解释了表1所示的行为,在表1中观察到,性能随着交错变分层数量的增加而增加。由于数据编码仅基于 旋转,因此图 2 左侧子图中的设置等效于对向量求和,并将结果仅通过一个编码层馈送到电路中。结果,(Eq.(3)中的输入维度从 减小到 ,使得模型无法访问数据 中存在的大部分信息,这解释了表1左列中性能不佳的原因。随着变分层数量的增加, 可以获得更多信息,因为只有数据中的一些行被求和,最终达到图 2 右侧子图所示的完全交错设置的最佳性能。值得注意的是在保持变分层数量不变的情况下减少交错层的数量,增加了最终变分层的可表达性,但似乎可以想象,这种增加不能通过部分或全部对数据 中的行求和来补偿信息损失。同样的论点适用于表1和表2中的DRU列的解释。在这里,在数据重新上传设置中,图像的行首先被求和,然后重复编码到电路中,中间有变化的层。虽然傅里叶和的频谱现在包含 之间的所有整数,但从方程 (Eq. (3)) 可以看出,通过将 替换为所有 的行上的总和,同样是模型似乎无法补偿在对图像行求和时丢失的信息。在更通用的编码方案(例如用于后续编码层的交替 门)的情况下,直观地说,由于编码门的非交换性,这种效果不太显着。然而,表3表明,在非交换编码门的情况下,数据中的信息也可以通过模型更好地访问,其中更多的变化层与结束层交错。对这种情况进行更严格的讨论将成为进一步工作的重点。
5.结论
本文针对高维数据,提出了一种增量数据上传的编码模式。 它作为在变分量子电路中定位编码层的指南。 在这里,编码层和变分层依次交替,这样数据就被增量地馈送到电路中,并且变得更容易被模型访问。 在它们之间具有最大变分层的 IDU 在图像分类任务中表现出 15-25 个百分点的性能提升。 有效维度和 Fisher 信息结果也支持我们的主张,即 IDU 模式在不增加其参数数量的情况下增加了 QML 模型的可训练性和表达性。 此外,将量子模型表示为部分傅里叶和,我们能够将其性能与可访问频率范围联系起来。
我们的实验还表明,像数据重上传这样的编码模式在处理高维数据时精度较低,在QML模型中参数较少,尽管它增加了整体QC深度和量子门的数量。 因此,我们得出结论,基于高维数据、浅层电路深度和给定编码方法的QML模型的性能有所提高。 然而,在IDU框架中为给定的数据集寻找最佳编码方法需要进一步的研究。
---煤油灯科技victorlamp.com翻译整理---
