
日本丰田工业大学计算机科学工程系主动智能系统实验室(AISL)的博士生Oskar Natan和导师 Jun Miura教授组成的研究团队开发出了能够同时处理自动驾驶车辆感知和控制的AI模型。
人工智能模型通过完成多个视觉任务感知环境,同时驾驶车辆遵循一系列路线点。此外,该AI模型可以在各种场景下的各种环境条件下安全驾驶车辆。在点对点导航任务下进行评估,该AI模型在标准模拟环境下达到了某些近期模型的最佳驾驶性能。
自动驾驶是一个复杂的系统,由多个子系统组成,处理多种感知和控制任务。然而,部署多个特定任务的模块成本高,效率低,因为仍然需要大量的配置,以形成一个集成的模块化系统。
此外,由于需要手动调整许多参数,集成过程可能会导致信息丢失。随着深度学习的快速研究,这一问题可以通过端到端和多任务方式训练单个AI模型来解决。因此,该模型可以仅根据一组传感器提供的观测数据提供导航控制。由于不再需要手动配置,因此模型完全可以自己管理信息。
对于端到端模型来说,仍然存在的挑战是如何提取有用的信息,以便控制器能够正确地估计导航控制。这可以通过向感知模块提供大量的数据来更好地感知周围环境来解决。此外,传感器融合技术可以用于提高性能,因为它融合了不同的传感器来捕获不同的数据方面。
但是,由于需要更大的模型来处理更多的数据,因此不可避免地会产生巨大的计算负载。此外,数据预处理技术是必要的,因为不同的传感器往往有不同的数据模式。此外,训练过程中的不平衡学习可能是另一个问题,因为模型同时执行感知和控制任务。
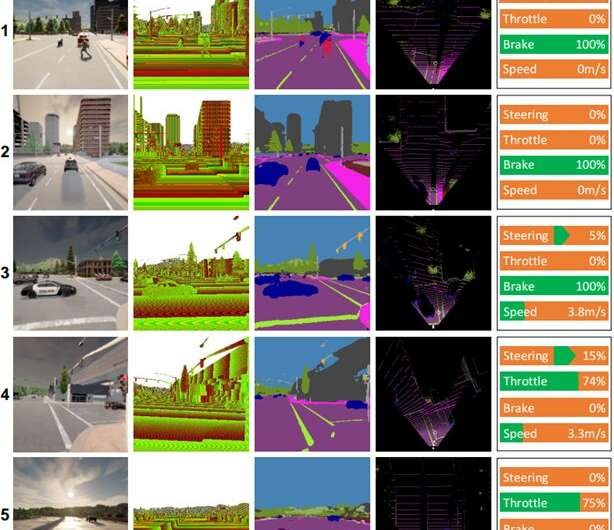
为了应对这些挑战,该团队提出了一个以端到端和多任务方式训练的AI模型。该模型主要由两个模块组成,即感知模块和控制器模块,感知阶段开始处理RGB图像和由单个RGBD相机提供的深度地图。
然后,从感知模块中提取的信息以及车辆速度测量和路线点坐标被控制器模块解码,以估计导航控制。为了保证所有的任务都能平等地执行,团队在训练过程中采用了一种叫做修正梯度归一化(MGN)的算法来平衡学习信号。
研究小组认为,模仿学习允许模型从大规模数据集学习,以匹配接近人类的标准。此外,该团队设计的模型使用比其他模型更少的参数,以减少计算负载,并在资源有限的设备上加速推理。
在标准自动驾驶模拟器CARLA上的实验结果表明,将RGB图像与深度图融合形成鸟瞰(bird -eye-view, BEV)语义图可以提高整体性能。由于感知模块对场景有更好的整体理解,控制器模块可以利用有用的信息来正确估计导航控制。此外,该团队表示,所提出的模型更适合部署,因为它比其他模型具有更少的参数,从而获得更好的驾驶性能。
该研究发表在《IEEE智能车辆汇刊》 《IEEE Transactions on Intelligent Vehicles》上,目前团队正在对模型进行修改和改进,以解决夜间、大雨等光照较差的驾驶环境下的几个问题。作为一个假设,研究团队认为,添加一个不受亮度或照明变化影响的传感器,如激光雷达,将提高模型的场景理解能力,并导致更好的驾驶性能。另一个未来的任务是将所提出的模型应用于现实世界中的自动驾驶。
