摘要
本文提出一种短深度量子电路来确定性地制备任意的Dicke 态 ,它是汉明权重为 的所有 个量子比特计算基态的等幅叠加。 Dicke 态是一类重要的纠缠量子态,具有多种应用,在物理系统中具有悠久的实验创造历史。 另一方面,对于在现实量子计算硬件连接上制备Dicke态的高效可扩展量子电路,我们知之甚少。
具体来说,我们提出了Dicke态 的制备电路,(i)深度为 ,用于全对全连接(例如在当前的离子阱设备上);(ii) 在大小为 且 的网格上,网格连接深度为(例如在当前大多数的超导量子比特设备上)。
这两种方法的总门数均为 ,不需要辅助量子比特,并且可以推广到那些对称纯状态的准备和压缩,其中所有非零幅度对应于汉明权重最多为 的状态。 本文的工作显著改进和扩展了先前最先进的电路,该电路在任意 的线性最近邻连接上深度为 ,在 的全对全连接上深度为 。
1.引言
Dicke 态是最有用的高纠缠量子态之一。Dicke 态 定义为汉明权重HW(x)=kHW\left(x\right)=k 的所有n个量子比特计算基态xx 的等幅叠加,其中汉明权重HW(x)HW\left(x\right) 表示位串xx 中11 的个数,
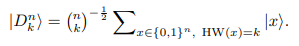
例如,∣D42⟩=16(∣1100⟩+∣1010⟩+∣1001⟩+∣0110⟩+∣0101⟩+∣0011⟩)\rvert D{4\atop 2}\rangle={1\over \sqrt{6}}\left(\rvert1100\rangle+\rvert1010\rangle+\rvert1001\rangle+\rvert0110\rangle+\rvert0101\rangle+\rvert0011\rangle\right) 。我们注意到,通过翻转每个比特,我们得到∣Dnn−k⟩=X⊗n∣Dnk⟩|D{n\atop n−k}\rangle=X^{⊗n}|D{n\atop k}\rangle ,因此∣Dnk⟩|D{n\atop k}\rangle 的结果也适用于∣Dnn−k⟩|D{n\atop n−k}\rangle ,我们可以假设2k≤n2k≤n 而不丧失一般性。Dicke态已在量子博弈论、量子网络、量子计量、量子纠错和量子存储中得到研究。从量子算法的角度来看,它们最具影响力的应用是将它们用作haming -weight约束组合优化问题(如Maximum k-Verte Cover)所有可行解状态的初始叠加。事实上,绝热计算和变分量子优化已经探索了这样的用例,特别是量子交替算子Ansatz (QAOA)。由于其广泛的适用性,各种较小的Dicke态已经实现在大多数NISQ技术上,如捕获离子,原子,光子,超导量子位和其他。最后,对于新型量子器件,Dicke态是一个有用的纠缠基准测试(作为GHZ态的替代或补充)。
1.1结果和相关性
在本文中,我们提出了一种可扩展的短深度量子电路,用于在基于门的量子计算机上确定性地制备迪克态∣Dnk⟩|D{n\atop k}\rangle 。更准确地说,如果底层量子位拓扑是全对全连接,我们首先提出具有深度为O(klognk)O\lparen k\log{n\over k}) 的Dicke态∣Dnk⟩|D{n\atop k}\rangle∣Dnk⟩|D{n\atop k}\rangle∣Dnk⟩|D{n\atop k}\rangle 的制备电路。这种连通性是当前离子阱器件的特征,如霍尼韦尔/Quantum或IonQ的设备。
第二组用于电网连接电路的深度为O(knk)=O(nk)O\left(k\sqrt{{n\over k}}\right)=O\left(\sqrt{nk}\right) ,我们更喜欢前一种表示法来说明与第一个结果的构造相似性。我们的网格连通性结果适用于大小为Ω(ns)×O(ns)\Omega\left(\sqrt{{n\over s}}\right)×O\left(\sqrt{n}s\right) 且1≤s≤k1≤s≤k 的“网格状”拓扑,这是目前大多数超导量子比特设备的典型情况,如IBMQ、谷歌和Rigetti的设备。如果在适应电路时,从网格到拓扑存在一个正则映射,且在深度和2个量子比特门计数上最多有恒定因素开销,我们就称拓扑(例如,重十六进制晶格)为网格状。这些拓扑具有长期的意义,因为纠错代码,如蜂窝代码,表面代码和与BaconShor的混合,具有这种连通性。为了简单起见,在我们的证明中,我们假设笛卡尔网格拓扑。
我们的两种方法的总门数均为O(kn)O\left(kn\right) ,不需要辅助量子比特,并推广到那些对称纯状态的准备和压缩,其中所有非零振幅对应的状态汉明权重不超过kk 。我们的电路设计的关键成分是经典的递归分治算法设计范式。基于经典下界的见解(可能有误导性),我们推测我们的电路深度在常数因子和低阶项下是最优的,并且对于nk×nk\sqrt{{n\over k}}×\sqrt{nk} 网格拓扑上的任意kk 是最优的。
1.2论文结构
我们的深度为O(klognk)O\left(k\log{n\over k}\right) 和O(knk)O\left(k\sqrt{{n\over k}}\right) 的 Dicke 态制备电路分别用于全对全和网格拓扑结构,显著改进和扩展了之前的先进电路,即对于任意kk 线性最近邻连通性的深度为O(n)O\left(n\right) ,对于k=1k=1 全对全连通性的深度为O(logn)O\left(\log n\right) 。
我们在第2节对其他相关结果进行了详细概述。在第3节中,我们建立了必要的预备知识并提出了主要的递归分治思想,包括方案的“攻克”部分。仅需要 LNN 连接的“划分”部分,因此是全对全拓扑和网格拓扑的子图,在第4节中给出。在第5节中,我们给出了全对全拓扑和网格拓扑的拓扑相关递归结构。第6节我们以结论结束。
2.相关研究
表1给出了相关结果的概述,并与我们的新结果进行了比较。 我们需要引入相关态:WW 状态是汉明权重为1的Dicke态,∣Dn1⟩|D{n\atop 1}\rangle ,对称态是Dicke状态的叠加。 因此,它们可以分别被视为Dicke 态的子集(超集)。 此外,Dicke 态具有d=(nk)d=\left({n\atop k}\right) 个非零状态向量项。 因此,我们可以认为它们是dd 稀疏的,尽管对于非常量kk ,稀疏度是超多项式的。 这些状态的状态制备有四种基本方法:概率的、确定的、通过 Schur 变换的量子(非)压缩以及通过稀疏状态制备技术。
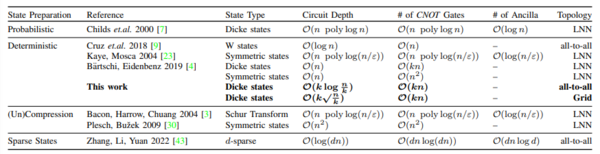
表1:Dicke态的状态制备方案及其子集和超集:W态为汉明权重为1的Dicke态,对称态是 Dicke态的叠加态。概率状态制备使用nn 量子比特乘积状态到汉明重量子空间的投影测量。量子压缩更为普遍,它被反向用于态制备。这里的εε 表示来自于可逆浮点算术电路精度的误差。稀疏状态准备也更普遍,但适用于d=(nk)d=\left({n\atop k}\right) 稀疏的Dicke态,我们得到log(d)≥klognk\log\left(d\right)≥k\log{n\over k} ,给出与我们的第一个结果相同的电路深度,但具有超多项式的门和辅助。
概率状态制备是将nn 量子比特乘积状态投影到汉明重子空间中,其成功概率为(nk)(kn)k(n−kn)∈Ω(1n)\left({n\atop k}\right)\left({k\over n}\right)^k\left({n-k\over n}\right)\in\Omega\left({1\over \sqrt{n}}\right) ,产生具有O(npolylogn)O\left(npoly\log n\right)的CNOT门,电路深度为O(npolylogn)O\left(npoly\log n\right) ,并需要在线性最近邻(LNN)量子位拓扑上使用O(logn)O\left(\log n\right) 个辅助量子位。
Dicke态也可以通过使用(逆)Schur变换生成,它实现了LNN拓扑上的计算基和Schur基之间的Schur- weyl对偶性,电路深度为O(nploylog(n/Ɛ))O\left(nploy\log(n/{\char"0190})\right) 和O(log(n/ε))O\left(\log\left(n/ε\right)\right) 个辅助量子位,其中εε 表示来自浮点算术子电路精度的误差。对于量子位,Schur 基给出了一个状态的总角动量JJ 及其zz 分量mm ,加上一个额外的指标来区分相同元组(J,m)\left(J,m\right) 的状态。在Dicke态∣Dnk⟩|D{n\atop k}\rangle 的情况下,我们有唯一值J=nJ=n 和m=n−2km=n−2k 。因此,Schur 变换可用于对称状态的量子压缩,通过消除存储JJ 和索引值的需要,给出了具有二次深度的构造,特别是没有辅助量子位。在确定性状态准备中,电路确定地准备了对称状态,初始方案在LNN拓扑上使用O(log(n/ε))O\left(\log\left(n/ε\right)\right) 个辅助量子位构建深度为O(npolylog(n/ε))O\left(npoly\log\left(n/ε\right)\right) 的电路,并与随后通过Schur变换获得的结果相匹配。一项改进导致线性深度的状态准备电路不需要辅助量子比特,在 LNN 连接上需要O(n2)O\left(n^2\right) CNOT 门用于对称状态和O(kn)O\left(kn\right) CNOT 门用于 Dicke 状态。对于WW 状态,对数O(logn)O\left(\log n\right) 构造存在于所有连接。对于网格连接,该方案可以很容易地扩展到O(n)O\left(\sqrt{n}\right) 深度。一些旨在提高NISQ实现效率的方法(对于较小的n和k)的特性改进没有反映在渐近性中。
对于任意d稀疏状态,最近提出的状态制备方案,尽管需要大量O(dnlogd)O\left(dn\log d\right) 辅助量子位,但只需要O(log(dn))O\left(\log\left(dn\right)\right) 的最佳深度。应用于d=(nk)d=({n\atop k}) 稀疏的Dicke态,我们得到深度log(dn)≥log(d)≥klognk\log\left(dn\right)≥log\left(d\right)≥k\log{n\over k} ,总共使用一个多项式数量的门和辅助量子位。
我们的结果是第一个Dicke态制备电路,它在深度上对nn 是次线性的,不需要超多项式门或辅助资源,参见表1。
3.预备知识和主要思想
为了制备Dicke态,我们重用Dicke态单位UnkU{n\atop k} 的概念,它作为输入的经典态∣0n−l1l⟩\rvert0^{n-l}1^l\rangle 且l≤kl\leq k ,制备Dicke态∣Dnl⟩|D{n\atop l}\rangle 。注意,经典状态∣0n−l1l⟩\rvert0^{n-l}1^l\rangle 是要生成的Dicke状态的汉明权重的00 填充一元编码。我们选择一个大端位串表示(最高有效位“大端”在左侧),其中电路图中从上到下的导线顺序对应于 ket 表示法中的从右到左的顺序:
定义1.用UnkU{n\atop k} 表示所有满足的酉解l≤k:Unk∣0n−l1l=∣Dnk⟩l\leq k:U{n\atop k}|0^{n-l}1^l=|D{n\atop k}\rangle 。
使用这种依赖于输入的状态准备酉有几个好处,只需很少的开销即可将 Dicke 状态准备扩展到对称状态准备,并且使用逆酉Un†kU{n†\atop k} 到对称状态压缩:
- 具有非零振幅的对称态∣Ψ⟩|Ψ\rangle 仅在汉明权重≤k≤k 的计算基态上可写成Dicke态基,∑l=0kαl∣Dnl⟩\sum\nolimits_{l=0}^k\alpha l\rvert D{n\atop l}\rangle 。因此,它们可以通过输入∑l=0kαl∣0n−l1l⟩\sum\nolimits_{l=0}^k\alpha l\rvert0^{n-l}1^l\rangle 到UnkU{n\atop k} 中来制备。这个输入本身可以在深度O(k)O\left(k\right) 中准备好,即使在 LNN 连接上也是如此。
- 这种形式的现有对称状态∣Ψ⟩|Ψ\rangle 也可以压缩为[log(k+1)]\left[\log\left(k+1\right)\right] 个量子比特,使用逆酉Un†kU{n\dagger\atop k} 得到∑l=0kαl∣0n−l1l\sum\nolimits_{l=0}^k\alpha l\rvert0^{n-l}1^l ,然后转换为单热编码∑l=0kαl∣0n−l1l0l−1⟩\sum\nolimits_{l=0}^k\alpha l\rvert0^{n-l}1^l0^{l-1}\rangle ,然后转换成00 填充的对数编码∑l=0kαl∣0⋅⋅⋅0⟩∣l⟩\sum\nolimits_{l=0}^k\alpha l\rvert0\cdot\cdot\cdot0\rangle\rvert l\rangle ,只有log[(k+1)]log\lbrack(k+1)\rbrack 个非零量子位。这些编码转换可以在深度O(klogk)O\left(k\log k\right) 中实现全对全连接,O(kpolylogk)O\left(kpoly\log k\right) 用于 LNN 连接。
这使我们能够专门专注于针对特定拓扑的Dicke状态酉UnkU{n\atop k} 的有效实现。对于LNN连接,我们回顾了以下最先进的线性深度结果:
引理1.Dicke 态酉UnkU{n\atop k} 可以在线性最近邻连接上使用深度为O(n)O\left(n\right) 的电路来实现,总共有O(kn)O\left(kn\right) 个 2 量子比特门并且没有辅助量子比特。
3.1主要思想
通俗地说,我们将使用引理 1 背后的电路结构,方法是调用O(nk)O\left({n\over k}\right) 个并行执行的更小的Dicke态单位UkkU{k\atop k} 实例,每个实例在其kk 个量子位上分配一些一元编码的输入汉明权重l≤kl≤k 。这仍然需要O(nk⋅k2)=O(kn)O\left({n\over k}·k^2\right)=O\left(kn\right) 个门,但深度仅为O(k)O\left(k\right) 。
那么这有什么问题呢?挑战在于提供这些输入的正确加权叠加:
- 输入的汉明权lil_i 输入到不同的Dicke态单位UkkU{k\atop k} 需要加起来为kk ,∑i=0n/kli≠k\sum\nolimits_{i=0}^{n/k}l_i\ne k 。
- 特定汉明权重组合输入(li)i\left(l_i\right)_i 的振幅需要反映由(li)i\left(l_i\right)_i 产生的Dicke态中计算基态的数量。
为了便于说明,我们给出了一个具体的例子,参见图1(左):Dicke态∣D63⟩\rvert D{6\atop 3}\rangle 是长度为2⋅32·3 的(63)\left({6\atop 3}\right) 个计算基态与汉明权重为33 的叠加。注意,只有1=(30)(33)1=\left({3\atop 0}\right)\left({3\atop 3}\right) 基态在最低有效位33 中具有汉明权重∣000111⟩\rvert000111\rangle 。然而,有9=(31)(32)9=\left({3\atop 1}\right)\left({3\atop 2}\right) 个基态的汉明权重在最低有效位中为22 。同样的观察结果也分别适用于汉明权重0和10和1 。
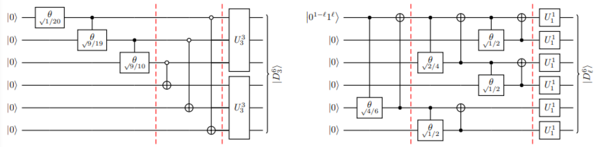
图1:先前使用并行Dicke态酉UkkU{k\atop k} 制备∣Dnk⟩|D{n\atop k}\rangle 的方法:我们使用大端序表示法(从上到下的导线是从右到左的位串)和简写门表示法θx/y:−Ry(2cos−1(x/y)):∣0⟩↦xy∣0⟩+y−xy∣1⟩\theta_{\sqrt{x}/y}\coloneqq R_y\left(2\cos^{-1}\left(\sqrt{x/y}\right)\right):\rvert0\rangle\xmapsto{}\sqrt{{{x\over y}}}\rvert0\rangle+\sqrt{{{{y-x\over y}}}}\rvert1\rangle 。(左)之后,我们在最低有效量子比特上制备叠加态120(1∣000⟩+9∣011⟩+1∣111⟩)\sqrt{{1\over 20}}\left(\sqrt{1}\rvert000\rangle+\sqrt{9}\rvert011\rangle+\sqrt{1}\rvert111\rangle\right) 。注意,分子1、9、9和后缀总和20、19、10作为项出现在角度参数中。接下来,我们将缺失的汉明权重添加到其他量子比特中,创建120∑l=03(33−l)(3l)∣0l13−l⟩∣03−l1l⟩{1\over \sqrt{20}}\sum\nolimits_{l=0}^3\sqrt{\left({3\atop 3-l}\right)}\sqrt{\left({3\atop l}\right)}\rvert0^l1^{3-l}\rangle\rvert0^{3-l}1^l\rangle 。这种初始状态制备是静态的,使用固定的汉明权重k=3k=3 。最后,我们使用Dicke态单位U33U{3\atop 3} 对称两个量子比特三元组(右),我们在前四个和后两个量子比特之间分配0≤l≤10≤l≤1 的输入汉明权重,得到26∣0(01−l1l)0000⟩+46∣00000(01−l1l)⟩\sqrt{{2\over 6}}\rvert0\left(0^{1-l}1^l\right)0000\rangle+\sqrt{{4\over 6}}\rvert00000\left(0^{1-l}1^l\right)\rangle 。递归地应用该构造在所有6个量子比特之间进一步分配汉明权重,产生∣D6l⟩|D{6\atop l}\rangle 。至关重要的是,该结构适用于输入为∣00000⟩|00000\rangle 和∣000001⟩|000001\rangle 的情况,分别对应于l=0l=0 和l=1l=1 。Dicke态U11U{1\atop 1} 仅仅是恒等式。
因此,如果我们想让∣D63⟩|D{6\atop 3}\rangle 在三个最低有效量子位和三个最高有效量子位上并行执行两个Dicke状态单位U33U{3\atop 3} ,我们首先必须准备一个输入状态,在这两个集合中正确分配汉明权重 3 量子位:
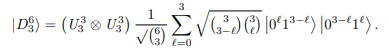
事实上,使用较小的Dicke态单位U[n/2]kU{\left\lbrack n/2\right\rbrack\atop k} 和U[n/2]kU{\left\lbrack n/2\right\rbrack\atop k} 制备Dicke态∣Dnk⟩|D{n\atop k}\rangle 提高了IBMQ上制备的Dicke态的保真度,因为由此产生的电路降低了门数。
3.2汉明权重分布
事后来看,可以根据汉明权重分布来讨论以前的方法。上面将固定的(非输入)汉明权值k拆分为两组量子比特的方法不适合递归应用,参见图1(左)或用于Dicke态∣D63⟩\rvert D{6\atop 3}\rangle 的交互式Quirk电路)。因此,与单个UnkU{n\atop k} 酉相比,状态准备深度没有渐近改进。另一方面,W 状态在全对全连接上存在渐近改进(注意 U11=IdU{1\atop 1}=Id )。 它基于一个子程序的递归应用,该子程序可以正确地重新分配汉明权重00 和汉明权重11 ,但不能推广到更高的汉明权重,参见图 1(右)或 Dicke 状态的 Quirk 电路∣D60,1⟩\rvert D{6\atop 0,1}\rangle 。
因此,我们的方法是增强这两种方法,这样我们就可以得到一个子程序,它可以将n>kn>k 量子比特上的任何汉明权重0≤l≤k0\leq l\leq k (作为一元编码)分配到mm 和n−mn-m 量子比特的分区中。 然后,如果m>km>k 和n−m>kn-m>k 分别在这些较小的mm 和n−mn-m 量子位集合上递归调用此类子例程。 因此,他们构建了递归分治方法的“分治”部分。 否则,我们已经到了最后一步,可以分别使用 Dicke 状态酉UmmU{m\atop m} 和/或Un−mn−mU{n−m\atop n−m} 将二进制 Hamming 权重对称地分布在量子位上。 因此,这些Dicke态的统一体构建了递归分治法的“征服”部分。 我们定义了一个相应的权重分布块:
定义2(重量分配块)。用WDBn,mkWDB{n,m\atop k} 表示所有l≤k:∣0n−l1l⟩l\leq k:\rvert0^{n-l}1^l\rangle 的任何酉映射
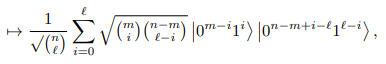
当y>ry>r (这可能发生,例如,对于l>ml>m ,如果m<km<k )时,我们设(xy)=0\left({x\atop y}\right)=0 。
注意,这样的WDBn,mkWDB{n,m\atop k} 对mm 和n−mn−m 量子比特的两个集合的kk 最低有效量子比特以外的所有量子比特都起作用。在图2中,我们给出了如何使用权重分布块WDB11,53WDB{11,5\atop 3} , WDB6,33WDB{6,3\atop 3} , WDB5,23WDB{5,2\atop 3} 和Dicke态单位U33U{3\atop 3} 和U22U{2\atop 2} 制备0≤l≤30≤l≤3 的Dicke状态∣D11l⟩|D{11\atop l}\rangle 的完整概述。
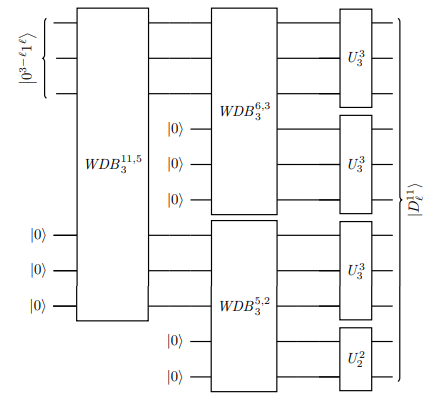
图2:我们的方法:我们的方法:以一元编码∣0803−l1l⟩\rvert0^80^{3-l}1^l\rangle 为11个量子比特的输入汉明权重0≤l≤30\leq l\leq3 ,通过WDB11,53WDB{11,5\atop 3} 在底部5个量子比特和顶部11−5=611−5=6 个量子比特之间分配。然后,它使用WDB6,33WDB{6,3\atop 3} 递归地分布在33 和6−3=36−3=3 的顶部66 个量子比特之间,并使用WDB6,33WDB{6,3\atop 3} 在22 和5−2=35−2=3 的底部55 个量子比特之间。最后,分别用Dicke态酉U33,U33,U33和U22U{3\atop 3},U{{3\atop 3}},U{{3\atop 3}}和U{{2\atop 2}}对称地分布3、3、3和23、3、3和2 量子比特(仍然是一元编码)四组上的汉明权重。
比较:有必要在这个新术语中解释之前的工作:图1(右)所示的WW 状态的对数深度方案使用了权重分布块WDB6,21,WDB4,21,WDB2,11WDB{6,2\atop 1},WDB{4,2\atop 1},WDB{2,1\atop 1}。一般来说,它使用WDBn,m1WDB{n,m\atop 1} 表示任意n,mn,m ,但仅限于k=1k=1 。
图 1(左)所示的使用两个 Dicke 状态单元Umk,Un−mkU{m\atop k},U{n-m\atop k} 准备DickeDicke 状态∣Dnm⟩|D{n\atop m}\rangle 的方案可以解释为单个权重分配块WDBn,mkWDB{n,m\atop k} 只接受固定的输入l=kl=k ,而不接受l<kl<k 。
引理 1 中结果背后的方案使用权重分布块WDBn,1kWDB{n,1\atop k} (在 [4] 中称为拆分和循环移位 SCS 门),它使用“阶梯形”在 LNN 拓扑上以O(n)O\left(n\right) 深度实现 “ 建造。 这些阶梯形状是这些 SCS 门的递归应用导致总深度为O(n)O\left(n\right) 而不是O(n2)O\left(n^2\right) 的原因。
新颖性:我们的构造扩展并统一了理论见解以及所有这些方法背后的构造,以形成一个完全通用的权重分布块WDBn,mkWDB{n,m\atop k} 。 一个重要的观察结果是WDBn,mkWDB{n,m\atop k} 对除了每组m和n−mm和n-m 量子位的最后kk 个量子位之外的所有量子位都起作用。 因此,对于权重分布块的递归应用的拓扑相关结构,我们将仔细排列量子位,使得这两组kk 量子位中的每一个都是沿着跨越 2k2k 量子位的 LNN 连接的邻居。 这将我们带到了我们方法的“划分”部分。
4.重量分配电路
在本节中,我们提出了一种深度为O(k)O\left(k\right) 、需要O(k2)O\left(k^2\right) 门但没有辅助量子比特的重量分配块WDBn,mkWDB{n,m\atop k} 的电路构造。其原理如图3所示,细节如图4所示。回想定义2,对于任意的一元编码输入0≤l≤k0\leq l≤k 对于n个量子比特,WDBn,mkWDB{n,m\atop k} 必须分配到n−mn-m 个和mm 个量子比特的(正确加权)一元编码输入的叠加。当l≤kl≤k 时,我们可以将自己限制在一个包含后一个集合的前kk 个量子比特的电路中。
我们的电路结构(如图3中k=4k=4 所示)实现了以下步骤
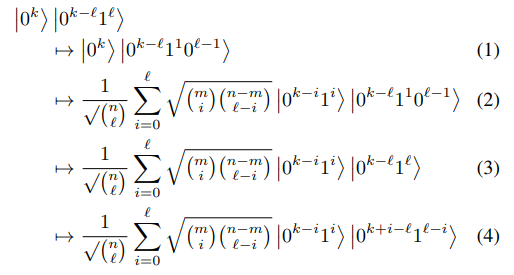
在步骤(1)中,我们将ll 的一元编码转换为ll 的独热编码。这允许在步骤(2)中向∣0k⟩|0^k\rangle 初始化的第二个寄存器中添加更简单的单量子位控制的状态。该步骤在图4(左)中详细说明。在步骤(3)中,我们将第一个寄存器的独热编码恢复为一元编码。最后,在步骤(4)中,我们从第一个寄存器中减去(以叠加的方式)第二个寄存器的值。这个一元减法电路在图4(右)中详细说明,并在这里作为一个Quirk电路给出。
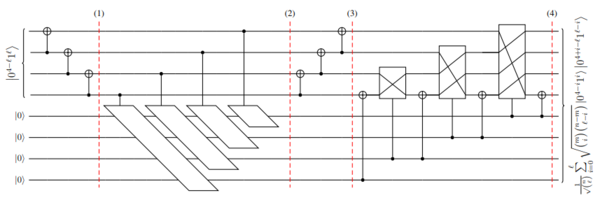
图 3:权重分布块WDBn,mk=4WDB{n,m\atop k=4} 的示意图,我们限制自己显示相关的 4 + 4 个量子比特。 我们从左到右:(1)从输入汉明权重ll 的一元编码切换到独热编码;(2)使用一元编码将汉明权重i≤li≤l 的叠加添加到第二个寄存器中 ; (3) 切换回第一寄存器中的一元编码; (4) 从第一个寄存器中的权重ii 中减去第二个寄存器中的权重ll 。 步骤 2、4 中的大型受控门深度为O(k)O\left(k\right) ,但也具有阶梯形状。 因此它们可以部分并行执行,仅将渐近深度增加一个常数因子。 如果m<4m<4 ,则必须将第二个寄存器截断为mm 个量子位。
我们现在从图3和图4中给出的电路中得出成本:显然,步骤(1)和(3)中的编码变化只需要O(k)O\left(k\right) 门和深度。对于步骤(2)中的控制加法,每个可能的值0≤l≤k0≤l≤k 都会产生一个需要O(l)O\left(l\right) 门和深度的控制加法。由于加法门具有阶梯形状,它们可以部分并行,因此我们得到总门数为O(k2)O\left(k^2\right) 的深度为O(k)O\left(k\right) 。这同样适用于控制置换门,它们构成了步骤(4)中的一元减法的构建模块。因此,我们的电路的整体深度为WDBn,mkWDB{n,m\atop k} 为O(k)O\left(k\right) ,总门数为O(k2)O\left(k^2\right) 。
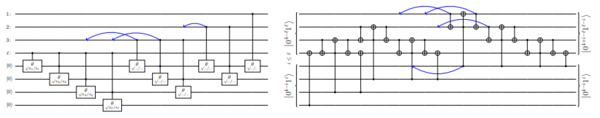
图4:图3中权重分配块WDBn,mk=4WDB{n,m\atop k=4} 所使用的(左)受控加法电路和(右)一元减法电路的详细实现。在两个电路中,门在第二个寄存器上呈阶梯形状,这使得受控门的并行化(蓝色箭头)。为了将状态(nl)−1/2∑i=0l(mi)(n−ml−i)∣04−i1i⟩\left({{n\atop l}}\right)^{-1/2}\sum\nolimits_{i=0}^l\sqrt{\left({m\atop i}\right)}\sqrt{\left({n-m\atop l-i}\right)}\rvert0^{4-i}1^i\rangle 受控添加到第二个寄存器中,我们首先预先计算项xi=(mi)(n−ml−i)x_i=\left({m\atop i}\right)\left({n-m\atop l-i}\right) 以及后缀和si=∑i=0lxis_i=\sum\nolimits_{i=0}^lx_i 。 然后可以通过一系列受控的 θxi/siθ_{\sqrt{x_i/s_i}} 门添加状态。 为了简化一元减法电路中的大型受控置换门,我们将受控置换门分解为受控 SWAP 门的阶梯,称为 Fredkin 门,然后将 Fredkin 门标准分解为 Toffoli 和两个 CNOT 门。
在这里需要讨论其他细节:首先,如果m<km<k ,那么第二个寄存器需要从kk 个量子位截断到mm 个量子位。这可以通过删除涉及第二个寄存器的最高k−mk-m 量子比特的任何操作来实现。这是没有问题的,因为这些操作对应于步骤(3)中i>mi>m 的项(mi)=0\left({m\atop i}\right)=0 ,因此对应于步骤(4)中的身份或0值1-控制。我们用权重分布块WDB6,33WDB{6,3\atop 3} 和WDB5,23WDB{5,2\atop 3} 的交互式怪异电路来说明这一点,它们都用于图2中给出的Dicke状态∣D113⟩|D{11\atop 3}\rangle 的构建。
其次,我们希望有一个WDBn,mkWDB{n,m\atop k} 的实现,它也适用于沿k+kk+k 个量子比特的 LNN 拓扑,只有一个常数因子开销。这是可能的:我们可以在交换网络上花费额外的O(k)O\left(k\right) 深度和O(k2)O\left(k^2\right) 门,对于步骤(2)和(4)中的电路,该网络使一个寄存器的控制与第二个寄存器中的受控门邻近。这仍然允许并行化(尽管减少了一个常数因子)。 我们得到:
引理 2.权重分配块WDBn,mkWDB{n,m\atop k} 可以在最小(n−m,k)+\left(n−m,k\right)+ 最小(m,k)\left(m,k\right) 量子比特之间的LNN个连接上用一个深度为O(k)O\left(k\right) 的电路实现,具有O(k2)O\left(k^2\right) 的2量子比特门,并且没有辅助量子比特。
请注意,在引理2中,我们没有指定两个寄存器的LNN连接以何种顺序“粘合”在一起。事实上,这两种选择都很好,因为我们可以用O(k)O\left(k\right) 深度的交换网络和O(k2)O\left(k^2\right) 交换门将第一个寄存器中的量子位重排为逆序。
5.拓扑相关的递归结构
在最后的技术部分,我们设计递归结构来应用我们的重量分配块。对于全对全连接,我们在设计中没有约束:任何递归结构继承了这两组kk 量子比特之间的全对全连接。对于网格拓扑,我们必须更加小心:递归结构应该满足引理2的连通性要求。图5给出了我们构造的示例。
5.1全对全连接
为了获得全到全连接上的递归结构,我们将nn 个量子比特划分为⌊nk⌋\lfloor{n\over k}\rfloor 个大小为kk 的不相交集合,再加上可能的n(mod k)n\left(\mod k\right) 个剩余量子比特的集合。对于每个集合,我们分配一个层,该层最初表示集合中量子比特的数量。然后,我们对不相交的集合数据结构使用按大小联合(即层)算法(没有路径压缩)来构建一个有根树,其中 (i) 将量子比特集作为其节点,并且 (ii) 将节点标记为 对应于各个节点子树的所有集合中的量子比特总数的层,参见图 5(左):
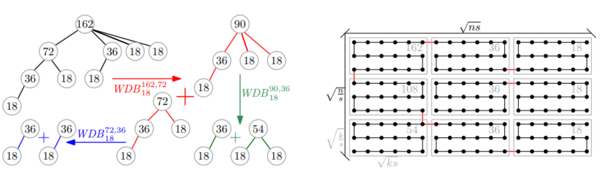
图5:递归应用重量分布块WDBn,mkWDB{n,m\atop k} 的结构,用于Dicke态∣D16218\rvert D{162\atop 18} :(左)对于全到全连接,我们将nn 个量子比特分布到nk{n\over k} 个大小为kk 的不相交集合中。这些集合排列在一棵有根的树中,并由它们的层标记,这表示子树中所有量子比特的总数。我们使用Union-Find数据结构的方法来构建树,例如,递归应用权重分布块WDBx,ykWDB{x,y\atop k} 在xx 层的根和yy 层的最高层子树之间将树分割为度大致相等的x,x−yx,x−y 根的子树。(右)对于1≤s≤k1≤s≤k 、大小为ns×ns\sqrt{{n\over s}}×\sqrt{ns} 的网格,我们将量子比特划分为nk×nk\sqrt{{n\over k}}×\sqrt{{n\over k}} 多个大小为ks×ks\sqrt{{k\over s}}×\sqrt{ks} 的矩形。确定每个矩形中kk 个量子比特之间的LNN连接,使得相邻矩形中的LNN端点是相邻的网格点。矩形的层对应于其右下象限(对于最左侧列的矩形)中的量子比特总数,或其行及其右侧(对于所有其他矩形)的量子比特总数。我们使用权重分布块WDBx,x−√nkkWDB{x,x−√nk\atop k} 在第一列中从上到下分布输入权重,然后使用块WDBy,y−kkWDB{y,y−k\atop k} 在每一行中从左到右分布,其中行可以并行处理。
直到每个集合都包含在同一棵树中,我们取具有最低层根节点a和b的两棵树,将较低层的根节点a作为子节点附加到另一个根节点b上,并用两层之和更新b的层。结果树的高度仅为结点数的对数,即O(lognk)O\left(\log{n\over k}\right) 。
我们现在可以使用权重分配块来递归地“撤销”按大小合并的算法:对于xx 层的根节点和y层的最高层子节点,我们对根节点和它的子节点应用WDBx,ykWDB{x,y\atop k} ,切断它们的边,然后分别得到两个根节点为x−y和yx−y和y 的较小的树。权重分布块的下一次迭代现在可以并行地应用于这两个根节点(以及它们各自的最高层子节点)。由于树的高度为对数,在最多O(lognk)O\left(\log{n\over k}\right) 的递归步骤之后,我们已经将输入的汉明重量分布到所有量子比特集。这就得到了我们的第一个主要结果:
定理 1(全对全连接)。 Dicke 状态酉UnkU{n\atop k} 可以在所有连接上使用深度为O(klognk)O\left(k\log{n\over k}\right) 的电路来实现,总共有O(kn)O\left(kn\right) 个 2 量子比特门并且没有附属量子比特。
证明.我们首先遵循上面概述的方案,使用权重分配块在最多kk 个量子比特的集合中分配 Hamming 权重l<kl<k 。 根据引理 2,这样的块可以在O(k)O\left(k\right) 深度内实现,具有O(k2)O\left(k^2\right) 门并且没有辅助量子比特。 除了根之外的每一组量子比特恰好是一个权重分布块的目标,因此所有块加起来有O(nkk2)=O(kn)O\left({n\over k}k^2\right)=O\left(kn\right) 个门。 另一方面,我们最多有一个对数的递归步骤,产生的总深度为O(klognk)O\left(k\log{n\over k}\right) 。
最后,我们并行使用 Dicke 状态酉UkkU{k\atop k} (和Unmod knmod kU{{{{n\mod k\atop n\mod k}}}} ,如果kk 不整除nn ),在每个集合内分配 Hamming 权重。 根据引理 1,这增加了另一个门数O(nkk2)=O(kn)O\left({n\over k}k^2\right)=O\left(kn\right) 门,深度为O(k)O\left(k\right) ,使总计数达到定理中给出的值。
在传递与最小广播时间问题的相似性时,我们注意到,从一个(待选择的)发送方发送的消息应该在最小时间内广播到图中的所有节点,并且限制节点在任何给定的时间步内最多可以向其邻居之一发送消息的副本。
如果图是输入的一部分,那么最小广播时间问题是NP难的。然而,如果已知该图是一个团,则上述方案的调整可以获得最佳的广播时间。因此,我们推测对于常数k,定理1中显示的深度在常数因子之前是最优的。
5.2电网连接
我们现在考虑任何网格大小为Ω(ns)×O(ns)\Omega\left(\sqrt{{n\over s}}\right)×O\left(\sqrt{ns}\right) 且1≤s≤k1≤s≤k 的网格连通性。 首先,我们假设值ns,ks,nk\sqrt{{n\over s}},\sqrt{{k\over s}},\sqrt{{n\over k}} 以及ns,ks,nk\sqrt{ns},\sqrt{k}s,\sqrt{nk} 都是整数。 在这种情况下,我们可以将一个大小为ns×ns\sqrt{{n\over s}}×\sqrt{ns} 的矩形网格划分为nk×nk\sqrt{{n\over k}}×\sqrt{{n\over k}} 个大小为ks×ks\sqrt{{k\over s}}×\sqrt{ks} 的矩形,每个矩形包含kk 个量子比特。 在每个矩形中,我们挑选出一个类似蛇的 LNN 子拓扑,使得蛇的“头部”和“尾部”与每个相邻矩形中的蛇的头部或尾部相邻,参见图 5(右)。
现在我们可以再次为矩形分配层,类似于前一小节:在除最左边外的每一列中,矩形的层对应于该矩形中的量子比特总数及其右边的所有矩形。在最左边的一列中,矩形的层对应于该矩形中的量子比特总数及其右下象限中的所有矩形。
我们使用重量分布块WDBx,x−nkkWDB{x,x−\sqrt{nk}\atop k} 在最左边的列中从左上矩形从上到下分布一个输入汉明重量,然后使用重量分布块WDBy,y−kkWDB{y,y-k\atop k} 在每一行中从左到右分布,其中行可以并行处理。这就得到了第二个主要结果:
定理 2(电网连接)。 Dicke 状态酉UnkU{n\atop k} 可以用深度为O(knk)O\left(k\sqrt{{n\over k}}\right) 的电路在大小为Ω(ns)×O(ns)\Omega\left(\sqrt{{n\over s}}\right)×O\left(\sqrt{ns}\right) 的网格拓扑上实现,其中1≤s≤k1≤s≤k ,总量子比特门为O(kn)O\left(kn\right) ,没有辅助量子比特。
证明(假设整数的平方根值)。方案的第一部分将输入汉明重量l≤kl≤k 从最左边的矩形从上到下分配到最左边的一列。为此,我们需要许多形式为WDBx,x−nkkWDB{x,x−\sqrt{nk}\atop k} 的连续重量分布块,利用引理2,使用O(k2nk)⊆O(kn)O\left(k^2\sqrt{{n\over k}}\right)⊆O\left(kn\right) 许多门而没有辅助量子比特,得到电路深度O(knk)O\left(k\sqrt{{n\over k}}\right) 。
最后一部分再次并行使用 Dicke 状态酉UkkU{k\atop k} ,不超过先前的深度或门数,产生定理中的值。
我们注意到这个方案还有改进的空间。首先,我们可以从一个中心矩形的输入汉明重量开始,它将首先沿其列分布,然后分布到左侧和右侧的半行,使总体深度减少4倍。更重要的是,我们可以直接应用Dicke态单位UnkkU{\sqrt{n}k\atop k} 来对称地将汉明重量分配到大小为kk 的nk\sqrt{{n\over k}} 矩形中的所有量子比特上,而不是使用WDBy,y−kkWDB{y,y−k\atop k} 的连续应用。该策略还允许我们最终处理非整数的平方根值。
定理2的完整证明。在前面的证明背后的构造中,非整数平方根值的主要问题是,直接的自适应可能导致包含几个未使用的量子比特的矩形。虽然这些不是我们在电路设计中使用的副量子位,但它们会阻碍量子位在电路中相互作用,因此需要交换,这增加了我们必须处理的不必要的副量子位。
基于上面的观察,有一种优雅的方法来处理这个问题:我们只构造k个量子比特的蛇形集合,在最左边的列中占据(部分)大小的矩形Ω(ks)×O(ks)\Omega\left(\sqrt{{k\over s}}\right)×O\left(\sqrt{ks}\right) 。我们不使用矩形的其他列,而是使用nk\sqrt{{n\over k}} 个Θ(nk)Θ\left(\sqrt{nk}\right) 个量子比特的蛇形集合,每个量子比特占据一行的空间,并连接到最左边列对应的矩形中的蛇的头或尾巴。
然后我们的方案首先将输入汉明权重 l≤k 从顶部矩形向下分配到最左侧列中的其他矩形,门数与之前相同。 紧随其后的是 nk\sqrt{{n\over k}} 许多 Dicke 状态酉UO(nk)kU{O\left(\sqrt{n}k\right)\atop k} 在每对 (i) 最左边一列矩形中的一条短量子比特蛇和 (ii) 到它的行中的一条长量子比特蛇 正确的。 (如果蛇以错误的顺序粘在一起,我们首先在短蛇上使用 SWAP 网络来反转其量子位的顺序。)所有行都可以并行执行,总共使用O(nkknk)=O(kn)O(\sqrt{{n\over k}}k\sqrt{nk})=O\left(kn\right) 门,从而得到O(nk)=O(knk)O\left(\sqrt{nk}\right)=O\left(k\sqrt{{n\over k}}\right) 的电路深度,而不需要(不必要的)辅助量子比特。
我们注意到,对于大小为Θ(nk)×Θ(nk)Θ\left(\sqrt{{n\over k}}\right)×Θ\left(\sqrt{nk}\right) 的网格拓扑,我们的电路深度渐近地对应于网格拓扑的图直径。因此,我们推测,对于这些网格,我们的电路深度是最佳的常数因子。然而,使用中间电路测量的隐形传态和对遥远量子比特的经典前馈控制等技术,可以用来规避这些连接限制,尽管有人可能会说,这些技术有效地降低了图的直径本身。
6.结论
我们分别为全对全和网格拓扑提出了深度为O(klognk)O\left(k\log{n\over k}\right) 和O(knk)O\left(k\sqrt{{n\over k}}\right) 的 Dicke 状态准备电路,这显著改进和扩展了先前最先进的电路深度。 对于某些参数组合,对于某些参数组合,例如全对全连接上的常数kk 或nk×nk\sqrt{{n\over k}}×\sqrt{nk} 网格拓扑上的任意kk ,仅依赖量子门(即不依赖状态或门隐形传态),并没有进一步的改进。
另一方面,渐进的改进并不是故事的结束:我们观察到,与现有工作相比,该技术还可以产生特定Dicke状态的门计数显著降低。例如,在图6和图7中,我们展示了∣D82⟩|D{8\atop 2}\rangle 制备的全对全和网格连接电路,CNOT门总数分别为27和31。据我们所知,这两个值都很容易降低制备∣D82⟩|D{8\atop 2}\rangle 所需的2量子比特门数的记录。电路也可以从以下链接中打开,以实现全连接和网格连接。然而,这些电路依赖于手动调整的不可扩展的重量分布块的实现。这为后者的可扩展但资源高效的实现留下了进一步改进的空间。
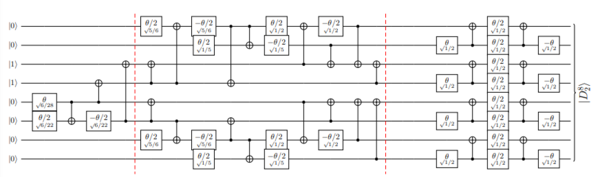
图 6:全对全连接上的Dicke 态∣D82⟩|D{8\atop 2}\rangle 的制备:最左边的权重分布块WDB8,42WDB{8,4\atop 2} 只接受输入汉明权重 2。后面是两个递归权重分布块WDB4,22WDB{4,2\atop 2} ,和 最后由四个 Dicke 状态单元U22U{2\atop 2} 。总 CNOT 计数为 27。这比以前的工作有所改进,明确的 CNOT 门计数为 44 。
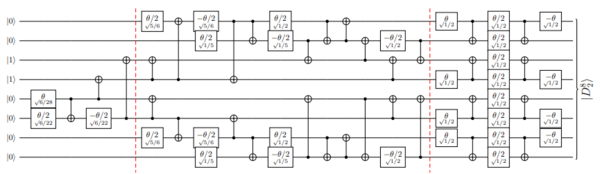
图7:网格连接上Dicke态∣D82⟩|D{8\atop 2}\rangle 的制备:最左边的重量分布块WDB8,42WDB{8,4\atop 2} 只接受输入汉明权重2。其次是两个与两根导线的反转相结合的递归权值分配块WDB4,22WDB{4,2\atop 2} ,最后是四个Dicke态单位U22U{2\atop 2} (其中两个方向相反)。总的 CNOT 计数为 31。这改进了基于 [1] 中方案的网格的 35 个 CNOT 门的外推下限。
我们重复第1节和第3节的观察结果:(i)我们对Dicke状态的结果∣Dnk⟩|D{n\atop k}\rangle 也适用于Dicke状态∣Dnn−k⟩=X⊗n∣Dnk⟩|D{n\atop n-k}\rangle=X^{⊗n}|D{n\atop k}\rangle ,(ii)由于变量输入结构的Dicke国家统一的UnkU{n\atop k} 结果扩展到对称状态组成的计算基础与汉明重量l≤kl≤k 的计算基状态组成的对称状态。 将两者结合起来,我们还得到了准备对称状态的电路,该对称状态仅由具有汉明权重l≥n−kl≥n-k 的计算基状态组成。
最后,使用我们的电路反向使用一些电路添加负责实现编码更改,我们得到O(klognk)O\left(k\log{n\over k}\right) 深度电路,用于将讨论的汉明权重受限对称状态类型从nn 压缩到[log(k+1)]\lbrack log\left(k+1\right)\rbrack 多个量子比特。
原文链接:https://arxiv.org/pdf/2207.09998.pdf
---煤油灯科技victorlamp.com翻译整理---