IBM在今年的IEDM会议上提交的新研究表明,我们在高能效的模拟硬件上训练和运行人工智能(AI)系统的时机即将到来。
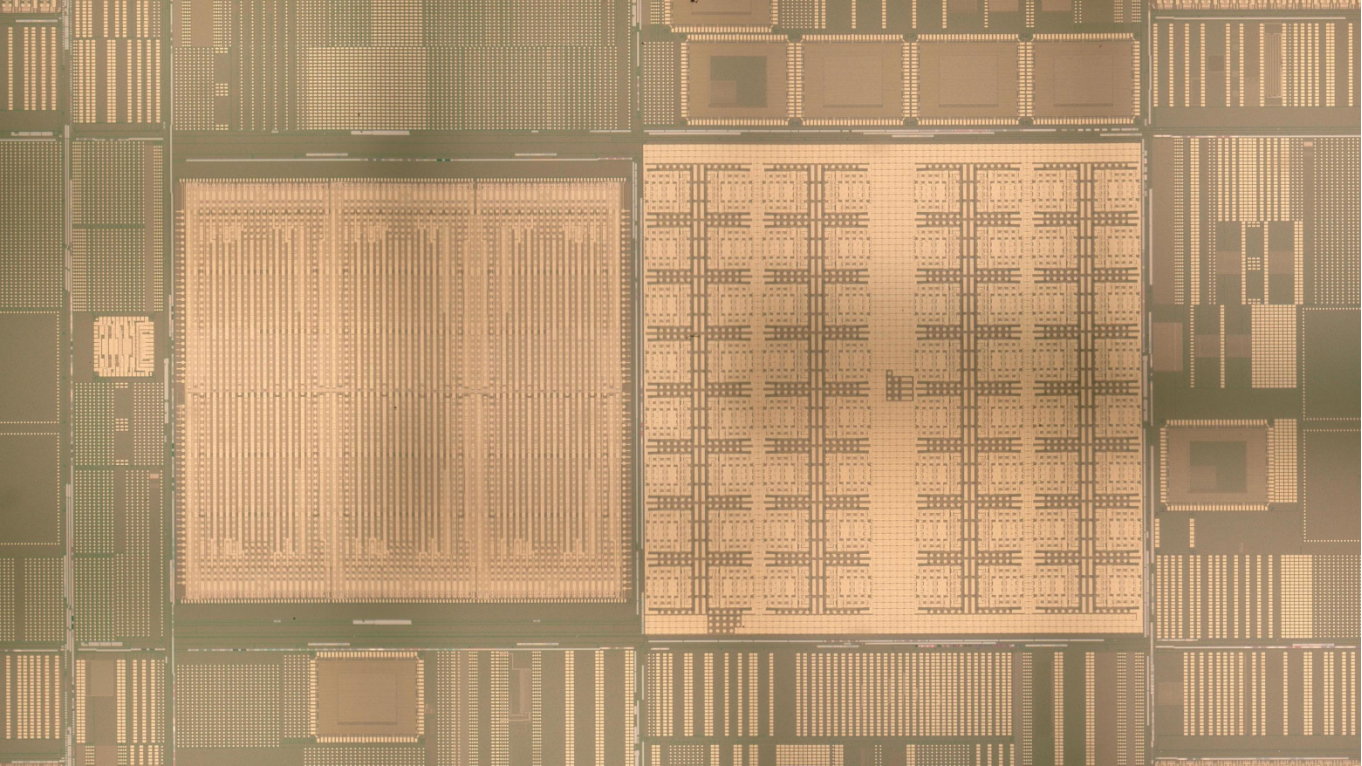
IBM使用的模拟AI研究芯片。
自从计算机时代开始以来,全世界都在研究精确的计算机芯片。正如我们所知,数字世界是无数个1和0组成的结果,是芯片上处理的有明确答案的常数之和。但是,在精度不那么重要的地方,可以进行什么样的计算呢?
再计算中,与处理有关的大量时间和精力都消耗在处理器和内存之间来回转移电子上。多年来,IBM的研究人员一直致力于开发模拟内存计算机芯片,其中的计算是在内存本身进行的。这些芯片的目标是节省能源,并建立可用于AI训练和推断的器件。
我们用计算机计算的东西总是需要精确。你无法猜测火箭的飞行路线,也不能指望你的税务软件会计算出那一年你应该缴纳多少税款。但是生活中有些事情不一定要那么精确。举例来说,如果你在一个国家学习如何开车,你很可能猜出另一个国家的停车标志是什么样子,即使你从未见过。
在今年的IEEE国际电子器件会议(IEDM 2022)上,IBM的研究人员详细介绍了未来高效模拟芯片如何用于深度学习的工作,包括训练和推理。
构建AI推理系统
当建立AI系统时,你必须在数据上训练一个模型。当第一次训练模型时,模型推断你在寻找什么的能力很差,无论是识别猫的照片还是寻找新的药物想法。您可能需要运行模型,根据您的结果调整它的权重,然后再次运行模型,重复直到它达到您想要的精确度。因此,毫不奇怪,在已经训练好的模型上运行推理比从头开始训练一个模型要容易一些。
但这不是一项没有挑战的任务。研究员Julian Buechel在IEDM提交了一篇论文,IBM的一个研究小组一直在研究如何将模型的权重准确地映射到模拟存储芯片上,以执行推理任务。
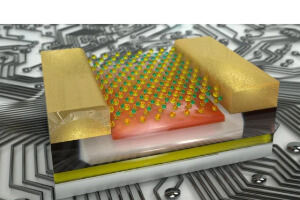
该团队的工作表明,相变存储器(Phase-change memory,PCM)是一种新兴的非易失性存储器技术,最近已经作为计算机系统中的存储器商业化。相变存储器件有可能用于将神经网络的突触权重映射为模拟导电器件值。这些电导值需要精确,在过去,研究人员必须向器件的每个细胞发送电脉冲,以计算它是如何加权的,这可能很耗时。回读时,每个电池不会输出很多电流,这也意味着在试图确定它们的权重时,出现错误的可能性很高。
该团队没有读取每个细胞,而是测试了是否有可能一次读取一个神经网络层中的所有细胞。毕竟,重要的是矩阵向量乘法运算的整体精度是否与每一层相对应,而不是单个电池的唯一精度,单个电池的精度可能会在测量一个器件和下一个器件之间的时间上有所波动,或者在一个电池和下一个电池之间的电阻上有微小的偏差。通过该方法,可以并行测试模型的每一层,而且测试神经网络(如CIFAR10上的ResNet9)时,在该模拟硬件上运行模型的准确性比过去在模拟硬件上获得的结果更高、更精确。该方法技术上也是不可知的。
虽然这种方法还远非完美,但在将模拟内存计算芯片商业化的道路上,这是推理精度更接近数字加速器的关键一步。
构建AI培训系统
创建AI训练系统比构建推断系统更具挑战性。由Takashi Ando领导的IBM研究人员与合作伙伴Tokyo Electron(TEL)合作,一直在研究如何在模拟硬件上训练AI。当训练AI模型时,你将数据输入网络,对其进行分类,然后通过网络反向传播误差来微调权重。这个推理实际上是培训的一个子集,只需使用培训过程中的分类部分。
使用传统算法的微调模型来精确地更新权重时,需要一个具有完全对称的电导变化器件,但目前还没有这样的器件。该领域的研究人员倾向于使用现有技术,如传统的ReRAM器件,但IBM团队尝试了一些不同的东西。该团队采用了全栈方法,共同优化算法和硬件。这是第一个用最先进的CMOS技术为AI训练定制算法和硬件的工作。
当用模拟硬件训练神经网络时,你要寻找误差函数的梯度;如果它们很陡,你就大量更新权重。传统上,梯度和权重信息存储在同一模拟器件中,导致对器件对称性要求很严格。该团队一直在研究一种叫做Tiki-Taka(是的,就像不断来回传球的足球风格)的算法,旨在通过将梯度和权重信息分离到两个不同的系统中来放松对称要求。
对于实验,该团队已经定制了一个基于14纳米CMOS的ReRAM阵列来测试他们的想法。使用基于ReRAM阵列统计数据的模拟,研究人员发现,通过同时优化ReRAM材料和Tiki-Taka算法,他们可以在MNIST数据上获得三层全连接深度神经网络(DNN)97%的精度(浮点精度98.2%)。TEL正在利用其制造能力和与位于Albany的IBM研究所的长期密切合作关系,帮助开发用于新型ReRAM材料的沉积和蚀刻工艺。
要实现大型DNNs浮点精度,还需要做更多工作,但在IEDM展示这项工作的Nanbo Gong表示,该团队已经找到了实现这一目标的途径。有了这两方面的努力,IBM的研究越来越接近这样一个未来:可以在高能效的模拟硬件上训练和运行AI系统。
原文链接:
https://research.ibm.com/blog/why-we-need-analog-AI-hardware