AI模型正日益渗透到我们生活和工作的方方面面。年复一年,更复杂的模型、新技术和新用例需要更多的计算能力来满足对AI不断增长的需求。
最近最相关的一个例子是基础模型的出现,这些AI模型基于一组广泛的未标记数据进行训练,可以用于许多不同的任务——只需进行最少的微调。但是这类模型是巨大的,在某些情况下超过数十亿个参数。为了训练这种规模的模型,你需要超级计算机,这是由许多强大的计算元素组成的系统,需要协同工作以高性能解决大问题。
传统上,构建超级计算机意味着裸机节点、高性能网络硬件(如InfiniBand、Omnipath和Slingshot)、并行文件系统和其他通常与高性能计算(HPC)相关的项目。但是传统的超级计算机不是为AI设计的;它们设计为在建模或模拟任务中表现良好,如美国国家实验室定义的任务,或其他寻求满足特定需求的客户。
虽然这些系统在AI方面表现良好,并且许多“AI超级计算机”(如为OpenAI构建的计算机)继续遵循这种模式,但传统的设计点在历史上一直推动着技术选择,从而增加了成本并限制了部署灵活性。我们最近一直在问自己:如果我们只专注于大规模AI,我们会设计什么系统?
这让我们建造了IBM的第一台AI优化的云原生超级计算机Vela。它于2022年5月上线,位于IBM Cloud中,目前仅供IBM研究社区使用。我们在这种设计中做出的选择让我们能够灵活地随意扩展,并随时将类似的基础设施部署到全球任何一个IBM云数据中心。Vela现在是IBM研究人员创造最先进AI能力的首选环境,包括在基础模型上的工作,也是IBM与合作伙伴合作训练多种模型的地方。
为什么要在云端建造一台AI超级计算机?
IBM在超级计算领域有着深厚的根基,设计了几代名列世界500强的高性能系统。这包括当今世界上最强大的超级计算机Summit和Sierra。对于我们设计的每个系统,都会发现新的方法来提高相关工作负载的性能、弹性和成本,提高研究人员的工作效率,并更好地满足客户和合作伙伴的需求。
去年,我们的目标是尽最大可能压缩构建和部署世界级AI模型的时间。这个看似简单的目标引发了一场内部辩论:我们是使用传统的超级计算模型在内部构建我们的系统,还是将这个系统构建到云中,本质上是构建一台也是云的超级计算机。在后一种模式中,我们可能会在性能上有所妥协,但我们会在生产率上获得相当大的收益。在云中,通过软件配置需要的所有资源,使用一个健壮的已建立的API接口,并获得对更广泛的服务生态系统的访问权并与之集成。我们可以利用驻留在IBM云的数据集,而不是构建自己的存储后端。我们可以利用IBM Cloud的VPC功能,与使用高级安全实践的合作伙伴进行协作。对我们生产力的潜在优势不胜枚举。随着辩论的展开,很明显我们需要建立一个云原生AI超级计算机。我们是这样做的。
关键设计选择和创新机会
当谈到以AI为中心的基础设施时,一个不妥协的要求是需要有许多GPU或AI加速器的节点。要配置这些节点,我们有两种选择:要么将每个节点配置为裸机,要么将节点配置为虚拟机(VM)。裸机是实现AI性能最大化的途径,这一点已被普遍接受,但虚拟机提供了更大的灵活性。走虚拟机路线将使我们的服务团队能够为基础设施提供和重新提供不同AI用户所需的不同软件堆栈。例如,当该系统上线时,我们的一些研究人员正在使用HPC软件和调度程序,如Spectrum LSF。我们还知道,许多研究人员已经迁移到我们基于OpenShift的云原生软件堆栈。虚拟机将使我们的支持团队能够在几分钟内灵活地动态扩展AI集群,并在各种工作负载之间转移资源。传统HPC软件堆栈和云原生AI堆栈的比较如图1所示。但是,从历史上看,采用虚拟化的云原生堆栈的缺点会降低节点性能。
因此,我们问自己:如何在虚拟机内部提供裸机性能?经过大量的研究发现,我们设计了一种方法来将节点上的所有功能芯片(GPU、CPU、网络和存储)暴露给虚拟机,以便虚拟化开销不到5%,这是我们所知的业界最低水平。这项工作包括为虚拟化配置裸机主机,支持虚拟机扩展(VMX)、单根IO虚拟化(SR-IOV)和大页面。我们还需要如实地描述虚拟机中的所有设备及其连接,例如哪些网卡连接到哪些CPU和GPU,GPU如何连接到CPU插槽,以及GPU如何相互连接。这些,加上其他硬件和软件配置,使我们的系统达到接近裸机的性能。
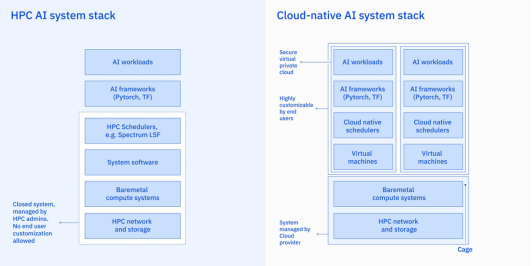
HPC AI系统堆栈和云原生AI系统堆栈的比较。
第二个重要的选择是AI节点的设计。鉴于使用Vela训练大型模型的愿望,我们选择了大GPU内存(80GB),以及节点上的大量内存和本地存储(1.5TB的DRAM和四个3.2TB的NVMe驱动器)。我们预计,大内存和存储配置对于缓存AI训练数据、模型和其他相关工件,以及向GPU提供数据以使其保持忙碌非常重要。
影响系统性能的第三个重要方面是网络设计。考虑到我们希望将Vela作为云的一部分来运行,构建一个单独的类似Infiniband网络——仅仅是为了这个系统——将会违背这个训练的目的。我们需要坚持标准的基于以太网的网络,这种网络通常部署在云中。但是传统的超级计算智慧表明,你需要一个高度专业化的网络。因此,问题变成了“我们需要做些什么来防止基于以太网的标准网络成为一个严重的瓶颈?”
我们首先在每个节点上为网络接口卡启用SR-IOV,从而通过虚拟功能将每个100G链路直接暴露给虚拟机。在此过程中,我们还能够使用IBM Cloud的所有VPC网络功能,例如安全组、网络访问控制列表、自定义路由、对IBM Cloud的PaaS服务的私有访问、对直接链接和中转网关服务的访问。
我们最近用PyTorch发布的结果表明,通过优化工作负载通信模式(可在PyTorch级别控制),我们可以将网络上的通信时间隐藏在GPU中发生的计算时间之后。这种方法得益于我们选择了80GB内存的GPU芯片(如上所述),这允许我们使用更大的批量(与40GB模型相比),并更有效地利用完全共享数据并行(FSDP)训练策略。通过这种方式,我们可以在分布式训练运行中高效地使用GPU,对于具有100多亿个参数的模型,效率高达90%甚至更高。接下来,我们将在规模化融合以太网(RoCE)和GPU直接RDMA(GDR)上推出远程直接内存访问(RDMA)的实施,以提供RDMA和GDR的性能优势,同时最大限度地减少对其他流量的负面影响。我们的实验室测量表明,这将减少一半的延迟。
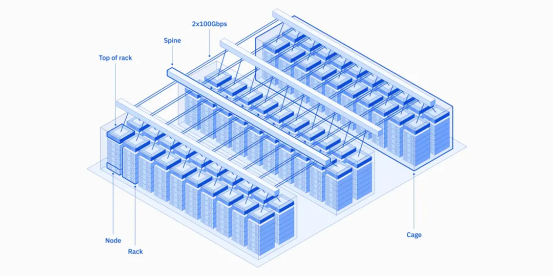
Vela架构细节
Vela每个节点都有八个80GB的A100 GPUs,它们通过NVLink和NVSwitch相互连接。此外,每个节点都有两个第二代英特尔至强可扩展处理器(Cascade Lake)、1.5TB DRAM和四个3.2TB NVMe驱动器。为了支持分布式培训,计算节点通过多个100G网络接口进行连接,这些接口以无超额预订的两级Clos结构进行连接。为了支持高可用性,我们在系统中构建了冗余:网络接口卡(NIC)的每个端口都连接到不同的架顶式(TOR)交换机,每个TOR交换机都通过两条100G链路连接到四个主干交换机,提供1.6TB的跨机架带宽,并确保系统可以在任何给定NIC、TOR或主干交换机出现故障的情况下继续运行。包括iperf和NVIDIA Collective Communication Library(NCCL)在内的多项微基准测试表明,这些应用可以驱动节点到节点TCP通信。
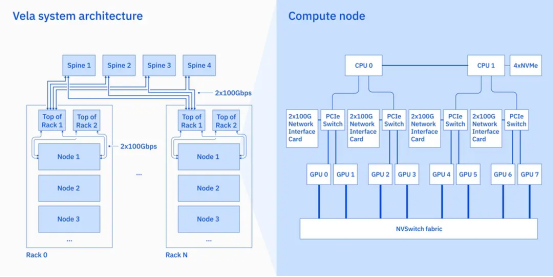
Vela系统架构
虽然这项工作旨在为大规模AI工作负载提供性能和灵活性,但该基础架构旨在可部署在我们全球任何规模的数据中心。它还被原生集成到IBM Cloud的VPC环境中,这意味着AI工作负载可以使用目前可用的200多种IBM云服务中的任何一种。虽然这项工作是在公共云的环境中完成的,但该架构也可以用于内部AI系统设计。
云原生AI超算刚刚开始
拥有合适的工具和基础设施是R&D生产力的关键因素。许多团队选择遵循为AI构建传统超级计算机的“屡试不爽”的道路。虽然这种方法显然没有任何问题,但我们一直在努力开发一种更好的解决方案,通过混合云开发体验来提供高性能计算和高终端用户工作效率的双重优势。
Vela自2022年5月以来一直在线,并由IBM Research的数十名AI研究人员进行生产性使用,他们正在用数百亿个参数训练模型。我们也对AI优化处理器IBM AIU带来的机遇感到兴奋,云原生AI超级计算的时代才刚刚开始。
原文链接:
https://research.ibm.com/blog/AI-supercomputer-Vela-GPU-cluster