摘要
文档检索是标准网络搜索引擎的关键阶段。现有的双编码器密集检索器独立地获取问题和文档的表示,只允许它们之间的浅层交互。为了克服这一限制,最近的自回归搜索引擎通过直接生成候选池中相关文档的标识符来替换双编码器架构。然而,随着候选文档数量的增加,这种自回归搜索引擎的训练成本急剧上升。在本文中,我们发现大型语言模型(LLM)可以按照人类指示直接生成用于文档检索的URL。
令人惊讶的是,当提供几个查询-URL对作为上下文演示时,LLM可以生成Web URL,其中近90%的相应文档包含对开放域问题的正确答案。这样,LLM可以被视为内置搜索引擎,因为它们并没有被明确训练来将问题映射到文档标识符。实验证明,我们的方法在三个开放域问答基准测试中,无论是在零样本还是少样本设置下,都能始终取得比现有检索方法显著更好的检索性能。本文的代码可以在https://github.com/Ziems/llm-url 找到。
1.介绍
随着深度学习的成功,基于双编码器的检索器已成为网络搜索的主要方法。例如,DPR采用两个独立的编码器分别对问题和文档进行编码,然后通过计算两个表示之间的单一相似度得分来估计它们的相关性。
然而,这些方法存在两个主要缺点。首先,在现代双编码器密集检索模型中,通常独立地获取问题和文档的表示,只允许它们之间的浅层交互。其次,问题或文档表示被嵌入到单个密集向量中,这在计算两个向量表示之间的相似度时可能会丢失细粒度信息。
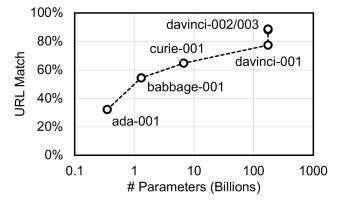
图1:不同规模的GPT-3作为URL生成器成功重构的URL。
模型以维基百科页面的前100个单词作为提示,然后任务是生成它们来自的页面的URL,在从前100,000个最常见的维基百科实体中抽样的10,000个维基百科页面上进行测试。
自回归搜索引擎的方法是不计算问题和文档嵌入的相似度,而是直接生成文档标识符,然后将其映射到预先确定的候选文档池中的完整文档。这种方法在信息检索(IR)和相关领域中越来越受到关注。与双编码器密集检索方法相比,自回归搜索引擎具有许多优势。首先,自回归生成模型通过执行深度的标记级交叉注意力生成文档标识符,从而比密集检索器中的浅层交互获得更好的估计。其次,已经证明自回归搜索引擎具有强大的泛化能力,在零样本设置下优于BM25。虽然从理论上讲,可以将自回归搜索引擎扩展到大型语言模型(LLM)的规模,例如具有1750亿参数的GPT-3,但实际上由于从头开始训练这样一个大型自回归搜索引擎的计算开销过高,这是不可行的(Tay等,2022年)。为了降低自回归搜索引擎的高训练成本,更小的模型尺寸更受欢迎。然而,我们在图1中的初步研究结果显示,较小的语言模型在将段落映射到文档标识符方面明显不如较大的模型。此外,不同的检索任务可能具有独特的检索要求。一个任务可能需要模型检索事实证据来支持或反驳一个主张(即事实检查),而另一个任务可能需要模型检索关于实体的特定琐事信息(即实体链接)。如果检索器能够通过少量示例进行泛化以适应新的检索任务,将会更好。
在这项工作中,我们探索了使用上下文演示来促使大型语言模型(LLM)直接生成用于文档检索的Web URL,即LLM-URL。令人惊讶的是,我们发现通过提供一些(查询,URL)对作为上下文演示,大型语言模型(例如GPT-3)生成的Web URL几乎有90%的相应文档包含对开放领域问题的答案。通过这种方式,可以将LLM视为内置的搜索引擎,因为它们没有被明确地训练以将问题或文档映射到标识符。LLM-URL不使用新创建的文档标识符,而是直接利用现有和广泛使用的文档标识符,即URL。我们将我们的方法与现有的文档检索方法在三个不同的开放领域问题回答(QA)数据集上进行了比较:WebQ,NQ和TriviaQA。此外,为了避免超过LLM的输入令牌数量限制,我们使用了一个无监督的段落过滤模块来删除支持文档中的无关部分。总结我们的主要贡献如下:
- 我们揭示了LLMs是内置的自回归搜索引擎,在零样本和少样本情况下通过直接生成Web页面URL来进行文档检索。
- 我们展示了使用LLMs通过生成URL进行文档检索明显优于现有的文档检索方法,这通过Recall@K指标进行衡量。此外,我们还展示了将检索到的文档分为段落,然后使用排序器对段落进行过滤,显著减少了支持段落的数量,同时保持了较高的召回率。
- 我们展示了与基线方法相比,通过检索到的文档可以提高下游的问答(QA)性能,这通过EM指标进行衡量。
2 相关工作
2.1传统文档检索器
传统方法如TF-IDF和BM25通过匹配问题和段落之间的重叠内容来探索稀疏的检索策略 。DPR通过利用密集的上下文化向量进行段落索引,对该领域进行了革命性的改进。它首先作为预训练的BERT模型进行初始化,然后使用查询和相关文档的成对数据进行有区分性的训练,其中包括来自BM25的困难负例。最近的研究通过改进的训练策略和段落重新排序来改进DPR。然而,在现代的双编码器密集检索模型中,问题和文档的表示通常是独立获得的,从而仅允许它们之间的浅层交互。
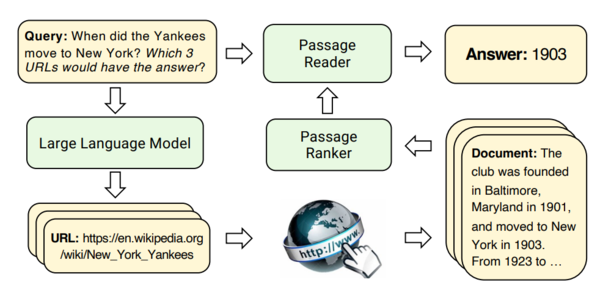
图2:我们提出的LLM-URL的总体流程。
给定一个问题,LLM-URL首先生成一组URL,这些URL从生成的文本中提取出来。然后从互联网中检索这些URL,将其分解为段落,然后对这些段落进行排序和过滤,只保留最相关的部分。最后,将这些段落与原始问题一起作为输入提供给阅读器模型,生成最终的答案。
2.2 自回归搜索引擎
最近的研究工作探讨了使用自回归语言模型生成文档的标识符字符串作为检索的中间目标,例如维基百科页面标题,层次聚类树中的根到叶子路径,或可映射到完整段落的独特n-gram。由于这一系列工作几乎同时由不同的研究团队进行,因此在文献中通常以多个不同的名称来引用,例如自回归搜索引擎、差分搜索索引(DSI)和神经文档索引器(NDI)。与传统的稠密文档检索器相比,这些方法利用生成模型来生成文档索引。通过强制生成模型使用交叉注意力来解释问题和文档中的每个标记,模型的生成能力显著提高。我们的工作与这些工作密切相关,实验证明适当引导预训练的大型语言模型可以实现比传统的稠密检索模型更好的性能。
3 提出的方法
在本节中,我们介绍一种新方法,称为LLM-URL,它利用大型语言模型(LLM)为开放领域问答(ODQA)等知识密集型自然语言处理任务执行高效且有效的网络文档检索。
ODQA是一个包含检索器和阅读器的两步过程。给定一个问题q,检索器的目标是找到与回答q相关的前n个段落Pn。给定q和前n个相关段落Pn,阅读器的目标是使用内部知识和Pn来生成问题q的正确答案a。段落检索器在此过程中起着重要作用。当Pn包含更多具有正确答案的段落时,阅读器更有可能找到答案。与大量训练专门的检索器不同,我们的LLM-URL以图2所示的不同方式解决了这个问题。
给定问题q,我们的LLM-URL应该找到一组与Pn相关的段落并将其提供给阅读器。首先,它提示一个LLM(例如GPT-3)直接为q生成m个URL。默认情况下,它使用“哪些m个维基百科URL会有答案?”作为指示,并将其追加到每个输入问题作为提示。我们还将维基百科URL的开头(https://en.wikipedia.org/wiki)追加到提示的末尾,以鼓励生成URL并限制生成为维基百科文章URL格式。由于LLM具有上下文学习的能力,我们利用这一优势来在提示中启用少样本设置。上述描述的提示还包括一系列的上下文演示。每个演示包含一个从训练集中随机抽取的问题,遵循上述提示。在每个演示的末尾,列出了指向金标记文档的m个URL。在零样本设置中,使用原始提示而没有任何演示。在少样本设置中,将原始提示追加到一系列d个演示(本文中d=10)中。
根据提示,LLM返回一个生成的标记序列。理想情况下,这些标记应构成一个由m个独立的URL组成的序列。实际上,生成的序列通常包含额外的信息,例如一个不可靠的提议答案,需要进行过滤。我们使用正则表达式从序列中提取所有的URL并丢弃所有的额外信息。这也会过滤掉许多格式不正确的URL。提取后,使用提取的URL进行GET请求,每个检索的内容用于创建一组获取的文档Df。通常情况下,|Df| < m,因为一些生成的URL不符合正确的格式或者指向互联网上的真实网页。
获取的文档集合Df如果m的值较小,或者所使用的阅读器能够处理许多大型文档,那么可以直接将其传递给阅读器。然而,通常情况下并非如此。通常需要对Df进行过滤,只选择最相关的一小部分段落传递给阅读器。为此,我们的LLM-URL首先将Df中的每个文档d划分为一组小段落。来自每个文档的段落被收集到一个新的集合Pf中。使用一个评分函数来衡量每个段落与问题q的相关性,高分值表示与q的相关性高,低分值表示相关性低。可以使用简单的评分函数如BM25,或者更复杂的评分函数如DPR。然后,对Pf中的段落按照从高到低进行排序,并保留前n个作为Pn。最后,将Pn与q一起提供给阅读器以生成答案。
LLM-URL的优势: 现有的自回归检索方法,如DSI和SEAL,使用预训练的大型语言模型,然后对其进行微调,将问题作为输入生成相关的文档标识符作为输出。DSI和SEAL在各种文档标识符上进行了大量的实验,这些标识符是由经过大量训练的语言模型生成的。这些标识符的示例包括非结构化的原子标识符、简单的结构化字符串标识符、分层文档聚类等等。相比之下,LLM-URL使用现有的互联网上存在的文档标识符,即URL。使用URL而不是前面提到的标识符具有多个优势。URL通常包含与其链接信息相关的词语,可以将主题与其URL强烈关联起来。例如,每个维基百科页面的标题都用于其URL,这使得LLM能够通过利用问题中的语义信息直接生成URL。为了验证URL本身的重要性,我们还尝试提示LLM生成维基百科标题而不是URL,并发现与提示URL生成相比,Recall@1显著降低。我们认为这是因为URL格式本身有助于提示模型以特定格式获取特定信息。此外,使用URL使我们可以通过HTTP请求简单地获取证据文档,而无需训练模型或构建索引来找到标识符和文档之间的映射。
4 实验
在本节中,我们展示和讨论了我们的实验结果,以“直接”证明我们的LLM-URL是一个强大的检索器,并“间接”展示它在ODQA任务上与最先进的解决方案相比具有竞争力的性能。
大型语言模型: 根据图1,我们在实验中使用的大型语言模型是GPT-3 text-davinci-003,使用解码和温度为0。我们尝试了各种不同的提示来生成URL,但观察到性能的差异很小,因此我们简单地使用在第3节中讨论的表现最好的提示。
数据集: 我们使用三个ODQA数据集,包括Web Questions、Natural Questions和Trivia QA。我们使用它们来对文档或段落检索任务以及ODQA本身进行评估。
4.1 检索
我们期望检索器能够找到最相关的文档和/或段落,我们对文档检索和段落检索进行了实验。
评价指标:通过计算在前k个文档或段落中包含至少一个正确答案的文档或段落的百分比来计算召回率(Recall@k,其中k=1、10、100)。精确匹配率(exact match)是预测答案与正确答案之间匹配的百分比。虽然LLM-URL在生成用于文档检索的URL时没有限制,但为了公平比较,我们将所有生成限制为仅使用维基百科的URL,如第3节所讨论的。所有基准模型也使用维基百科进行检索,有些从实时获取文档,而其他模型从离线语料库中获取。
文档检索
基线模型: 在段落检索中,通常使用Contriever和BM25作为基线模型。Contriever是一个双编码器,它使用问题和段落的稠密表示之间的点积来计算相关性。BM25是一个稀疏检索器,它使用问题和段落之间的重叠内容来计算相关性。由于我们使用相同的段落大小来分块维基百科文档,我们可以将它们检索到的段落映射回原始文档。我们使用谷歌API限定在维基百科上作为第三个基线模型,用于根据问题检索相关文档。
现有的工作,如DSI和SEAL,研究了使用自回归语言模型生成文档标识字符串作为检索的中间目标。DSI是一个Transformer模型,通过记忆整个语料库的内容,训练将问题直接映射到文档标识符。SEAL是DSI的一种变种,使用ngram作为文档标识符以提高检索性能。DSI和SEAL都没有报告关于完整文档的检索结果,并且没有公开可用的实现,因此它们在表3和第4.1.2节中被忽略并进行了讨论。
与基线模型不同,我们的LLM-URL使用了一个大型语言模型(LLM)。它有两种设置:零样本和少样本。在零样本设置中,没有提供上下文演示,而在少样本设置中,几个演示示例被附加到提示中。
结果: 我们的文档检索实验结果如表1所示。在这个设置中,文档检索完成后直接计算Recall@ k ,没有中间步骤。LLM-URL在所有数据集上的Recall@1和Recall@10都显著优于基线方法。具体而言,零样本的LLM-URL相对于WebQ、NQ和TriviaQA上最强的基线方法,分别将文档的Recall@1提高了20.4%、11.2%和13.2%。而少样本的LLM-URL进一步将这一改进扩大到24.9%、12.8%和16.7%。从LLM的大规模参数中可以提取URL,这些URL可以导致比现有方法检索到的文档更准确的结果。LLM的参数和上下文演示在文档检索中都发挥了显著的作用。
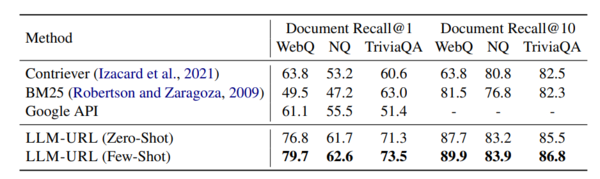
表1:根据Recall@k测量的文档检索结果。由于成本较高,省略了Google API Recall@10的结果。
图3显示了当生成的URL数量 m 增加时,Recall分数趋于稳定。由于增加 m 的收益递减,我们的实验没有探索大于10的 m 值。
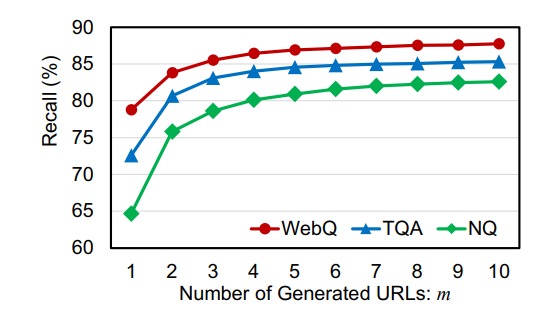
图3:我们提示LLM-URL生成m个文档,并随着m的增加测量召回率。当m较小时,可以看到显著的召回率改善,但随着m的增加,边际收益递减。
生成的url是否有效? 生成的URL并不总是有效的。一些生成的URL没有有效的URL语法,而一些URL指向不存在的维基百科页面。偶尔,URL也可能生成到维基百科之外的域。为了公平比较,所有这些错误的URL都被丢弃,只保留来自有效维基百科文章的文档。
进一步进行了分析,以测量在生成的URL总数m从1增加到10时有效维基百科URL的比例,结果显示在图4中。可以观察到,有效URL生成的比例随着m从1增加到10仍然相对较高(高于68%)。然而,随着m的增加,有效生成的比例似乎逐渐降低,表明每次m的边际增加带来的收益递减。
图4:随着生成的URL总数m从1增加到10,LLM-URL生成的有效URL的百分比。随着m的增加,无效的URL生成变得更加频繁。
段落检索
基线方法: 在4.1.1节中介绍了四种方法,包括Contriever、BM25、DSI 和SEAL。谷歌API用于文档检索,而不用于段落。
结果: 我们的段落检索实验结果如表2所示。在这种设置下,Recall@k是基于排名器排名的前k个段落计算的,而不仅仅是表1中显示的原始文档。LLM-URL在Recall@1和Recall@10上表现略好于基线方法,对于Recall@100与基线方法表现相当。在零次训练设置中,LLM-URL相对于最强的基线方法在WebQ、NQ和TriviaA上提高了16.2%、5.3%和1.1%的相对Recall@1。LLM-URL的少量训练设置将这一改进扩大到16.8%、11.8%和6.3%。类似的改进也可以在Recall@10上看到。
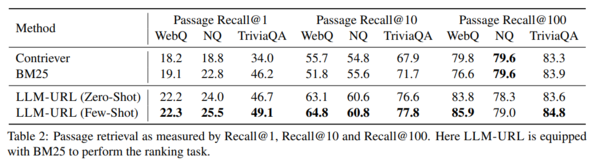
对于Recall@100,在除了NQ之外的所有数据集上,LLM-URL的性能相对于基线模型更好。在零次训练设置中,LLM-URL将相对Recall@100在WebQ上提高了5.0%,在NQ和TriviaQA上略低于最佳基线方法分别为1.7%和0.4%。LLM-URL的少量训练设置在Recall@100上在WebQ和TriviaQA上略有改进,但在NQ上略低于最强的基线方法。
尽管仅限于来自10个文档的段落,LLM-URL在较小的k值上优于基线方法,并在较高的k值上与基线方法表现相当。
LLM-URL与现有的基于文档标识符的方法(如DSI和SEAL)之间的比较如表3所示。在Recall@1上,零次训练的LLM-URL相对于最佳基线方法略低8.8%。在少量训练设置中,LLM-URL的表现比零次训练稍差,相对于最佳基线方法表现差3.1%。在Recall@10上,零次训练的LLM-URL相对于最佳基线方法表现差18.7%。少量训练的LLM-URL仅略好于零次训练设置,在Recall@10上相对于最佳基线方法表现差18.4%。
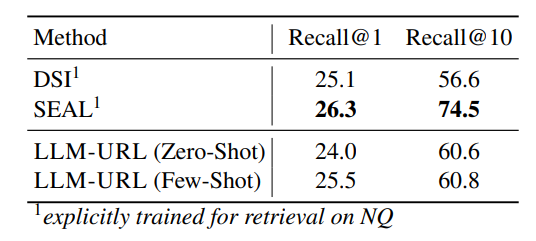
表3:通过Recall@1和Recall@10测量的传代检索。LLM-URL采用BM25进行文章排序。其他数据集由于没有在两篇论文中报告,也没有公开实现而被遗漏。
4.2 开放域问答
评估指标: 我们使用精确匹配(EM)作为评估指标,即答案与正确答案完全匹配的字符串,因为开放域问答的目标是在维基百科文章中找到一个准确的答案。
结果: 在这里,我们讨论LLM-URL在下游问答任务中的表现。在这个设置中,只有当生成的文本被规范化后在问题的可接受答案列表中时,答案才算完全匹配。与InstructGPT作为阅读器结合使用时,LLM-URL在WebQ上表现显著优于基线方法,并在TriviaQA上略优于最佳基线方法。在NQ上,LLM-URL+InstructGPT的表现不如基线NDI,并且仅略逊于最佳剩余基线方法。在零次训练设置中,LLM-URL+InstructGPT在WebQ上相对于最佳基线方法提高了13.3%,在TriviaQA上提高了1.3%。LLM-URL+InstructGPT在NQ上相对于最佳基线方法下降了39.5%。在少量训练设置中,LLM-URL+InstructGPT在WebQ上相对于最佳基线方法提高了16.9%,在TriviaQA上提高了2.3%。LLM-URL+InstructGPT在NQ上相对于最佳基线方法下降了37.4%。
尽管LLM-URL+InstructGPT并没有针对检索进行明确训练,但它在WebQ上的表现明显优于基线方法,在TriviaQA上达到现有方法的水平,在NQ上略逊于现有方法。
我们的结果表明,LLM-URL可能是一种有前途的解决方案,可用于各种知识密集型任务的检索,几乎不需要训练数据。
4.3 讨论
时间敏感查询
LLM-URL相比现有方法具有许多额外的定性优势。LLM-URL的一个重要优点是可以实时从源中检索文档。只要源保持更新而URL本身不改变,我们提出的方法就能够回答时间敏感的查询,无需任何额外的修改。
相比之下,现有的双编码器方法(如Contriever)需要在每次文档更改时重新编码文档。现有的方法,如SEAL和DSI,也很难对时间敏感的查询进行及时更新,因为LLM需要重新训练以学习更新的文档内容。
根据Mallen等人的研究,我们分析了LLM-URL在常见实体和非常见实体情况下的检索性能。对于给定数据集中的每个问题-答案对,我们检查标记的实体是否存在于维基百科前一百万个常见实体之中。基于此,我们将数据集分成两个不同的子集:包含常见实体的问题-答案对和不包含常见实体的问题-答案对。通过对Web Questions、Natural Questions和TriviaQA数据集上的这两个不同集合上的模型性能进行测量,我们发现LLM-URL在常见实体的问题-答案对上的性能明显优于其他集合。我们的分析结果如图5所示。在这三个数据集中,常见实体问题-答案对的召回率远远高于其他数据集的召回率。
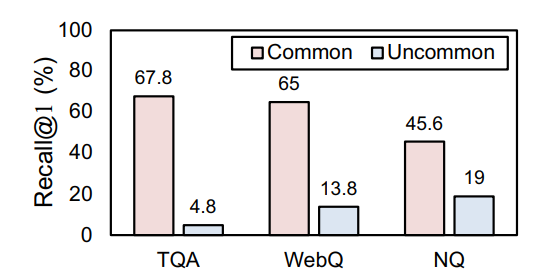
图5:常见实体与不常见实体recall@1.Common被定义为包含维基百科上最常见的前100万个实体中的实体的问题。LLM-URL在检索有关公共实体的信息时性能要好得多。
先前的研究已经表明,在封闭书设置中,模型必须仅依靠其权重中包含的信息时,LLM在常见实体和非常见实体上表现更好。我们的结果显示,这个问题不仅限于封闭书设置,当使用LLM-URL进行检索时也存在这个问题。这也可以解释我们在评估LLM-URL时发现的文档字数很高的原因。平均而言,维基百科文章有644个词,但通过LLM-URL检索得到的维基百科文档的平均字数为1万字。我们认为,这种差异是由于常见实体的维基百科文章具有更多细节,因此字数更多所致。
案例研究
在表5中,我们展示了一个案例研究,比较了LLM-URL与两种基线检索方法在TriviaQA测试集上的问题“‘smack’是哪种海洋生物的集体名词?”上的表现。这个问题的金标答案是“水母”。
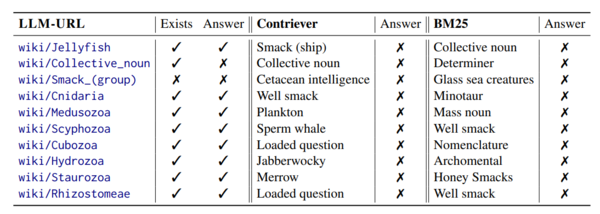
表5:从问题“A ' smack '是一组海洋生物的集合名词?”中检索到的文档的案例研究。“存在”意味着URL是否指向一个有效的Wiki页面。“答案”是指该文件是否包含答案。为简洁起见,我们省略了生成url的前缀(https://en.wikipedia.org/)。对于BM25和Contriever,我们分别显示了前10个检索文章的文档标题。正确答案是“水母”。
在封闭书设置中,InstructGPT错误地预测答案为“海豚”。当使用Contriever根据查询从维基百科检索10个段落时,没有一个段落包含金标答案。例如,Contriever检索到关于“smack”的段落,这是一种渔船,以及其他关于抹香鲸、浮游生物和其他无关主题的段落。使用BM25作为检索器时也得到类似的结果。
相比之下,LLM-URL在这种情况下表现得更好,检索到包含答案的7个文档。排名最靠前的文档正好是关于金标答案“水母”的文档。第四到第十个文档都是关于不同类型的水母。在被切分成段落并由排名器排序后,前10个段落被连接在一起。其中包含“一群水母被称为smack”,其中包含了问题的答案,并直接来自第一个检索到的文档,标题为“jellyfish”。然后,在将这10个段落与问题一起提供给InstructGPT之后,正确地生成了金标答案“水母”。
这个案例研究突出了LLM-URL的多个优点。首先,LLM-URL找到了与问题和答案相关的文档。它直接找到了关于“水母”的文档,而BM25和Contriever只找到与问题相关的文档,而不是答案。其次,LLM-URL比BM25或Contriever更精确。在这种情况下,LLM-URL生成的10个URL中有7个指向包含答案的维基百科文档。然而,BM25和Contriever都未能检索到包含答案的文档。第三,LLM-URL检索到的文档彼此之间是互补的,而在BM25或Contriever中,前10个文档是独立选择的。这是因为LLM能够在生成下一个URL之前参考先前生成的URL,使得每个新生成的URL能够以所有先前的URL为条件,这导致在开放领域的问题回答中具有更丰富的证据上下文。
5 结论与未来工作
在本文中,我们探讨了大型语言模型是否能够根据人类指令生成用于文档检索的URL。令人惊讶的是,我们发现通过提供一些(查询,URL)对作为上下文示范,大型语言模型(例如GPT-3)生成的Web URL中,接近90%的相应文档包含了对于WebQ中开放领域问题的正确答案。此外,通过将检索到的文档划分为段落并使用BM25对其进行排序,我们展示了可以过滤掉大量不必要的段落,同时保持高召回率,这比基线方法表现出显著优势。
未来工作有许多令人兴奋的方向。虽然存在一些广泛的检索基准数据集,如BIER,但还需要进一步研究是否可以针对特定的检索任务进一步调整本文中展示的少样本示范。类似的,Promptagator展示了通过类似的方式调整提示可以实现显著的性能提升。
此外,还有待研究是否对每个问题进一步微调提示可以进一步提高检索性能。与Promptagator类似,先前的工作已经表明,使用聚类来选择给定问题的多样化示范还可以进一步提高检索性能以及下游的问题回答性能。
