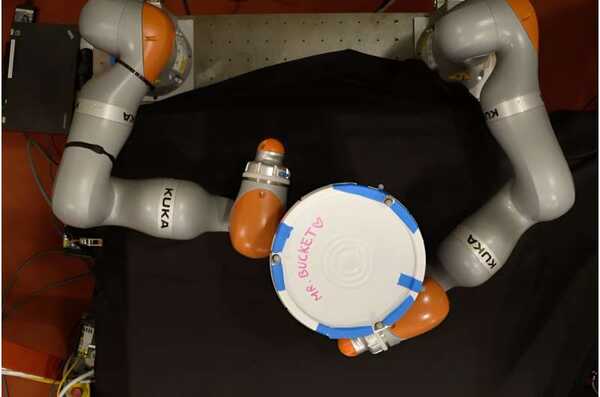
想象一下,你想要将一个又大又重的箱子拿上一段楼梯。你可能会伸开手指,用双手举起那个箱子,然后将它放在前臂上平衡在胸前,利用整个身体来操纵箱子。
人类通常擅长整体身体操纵,但机器人在这样的任务中很困难。对于机器人来说,箱子可能接触到搬运者的手指、手臂和躯干的每一个点都代表着一个需要进行推理的接触事件。由于可能存在数十亿个潜在的接触事件,规划这样的任务很快变得难以处理。
麻省理工学院的研究人员现在找到了简化这个过程的方法,称为富有接触的操纵规划。他们使用一种称为平滑的人工智能技术,将许多接触事件总结为较少的决策,使得即使是简单的算法也能够快速识别出机器人的有效操纵计划。
尽管还处于早期阶段,这种方法有可能使工厂能够使用体积更小、移动灵活的机器人,这些机器人可以用整个手臂或身体来操纵物体,而不是只能用指尖抓取的大型机器人臂。这有助于降低能源消耗和成本。此外,这种技术还可以用于发送到火星或其他太阳系天体的探测器上,因为它们可以仅使用机载计算机快速适应环境。
电气工程和计算机科学专业的研究生、该技术论文的合作者之一H.J. Terry Suh表示:“如果我们可以利用这种机器人系统的结构来使用模型,而不是将其视为一个黑盒子系统,那么我们就有机会加速整个决策过程,提出富有接触的规划。”
除了Suh之外,论文的合著作者还有波士顿动力人工智能研究所的机器人学家Tao Pang和电气工程和计算机科学专业的研究生Lujie Yang,以及资深作者Russ Tedrake,他是电气工程、航空航天学、机械工程的丰田教授,也是计算机科学与人工智能实验室(CSAIL)的成员。该研究本周发表在《IEEE机器人学交易》杂志上。
学习关于学习的知识
强化学习是一种机器学习技术,通过试错来使机器人等智能体完成任务,并获得接近目标的奖励。研究人员表示,这种类型的学习采用了黑盒的方法,因为系统必须通过试错来了解世界的一切。
在富有接触的操纵规划中,这种学习方法已经取得了良好的效果,机器人试图学习最佳的方式在指定的方式下移动物体。但是,当机器人确定如何使用手指、手、臂和身体与物体进行交互时,可能存在数十亿个潜在的接触点,这种试错方法需要大量的计算。
Suh和Pang好奇为什么物理建模方法在富有接触的操纵规划中效果不如强化学习。他们进行了详细的分析,并发现一种称为平滑的技术使强化学习取得了如此好的表现。
当决定如何操纵物体时,机器人可能会做出很多不重要的决策。例如,手指的微小调整,无论是否与物体接触,都没有太大关系。平滑将许多这些不重要的中间决策进行平均处理,只留下一些重要的决策。
强化学习通过尝试许多接触点,然后计算结果的加权平均来隐式地进行平滑。鉴于这一发现,麻省理工学院的研究人员设计了一个简单的模型,执行了类似的平滑操作,使其能够专注于核心的机器人-物体交互,并预测长期的行为。他们表明,这种方法在生成复杂计划方面可以与强化学习一样有效。
Pang表示:“如果你对问题有更多的了解,你可以设计更高效的算法。”
取得胜利的组合
尽管平滑极大地简化了决策,但搜索剩下的决策仍然是一个困难的问题。因此,研究人员将他们的模型与能够快速高效地搜索机器人可能做出的所有可能决策的算法相结合。
通过这种组合,计算时间在标准笔记本上减少到约一分钟。
他们首先在模拟环境中测试了他们的方法,机器人手被赋予了如将笔移动到所需位置、打开门或拿起盘子等任务。在每个实例中,他们以模型为基础的方法在同样的时间内达到了与强化学习相同的性能。当他们在实际机器人臂上测试他们的模型时,结果也很相似。
