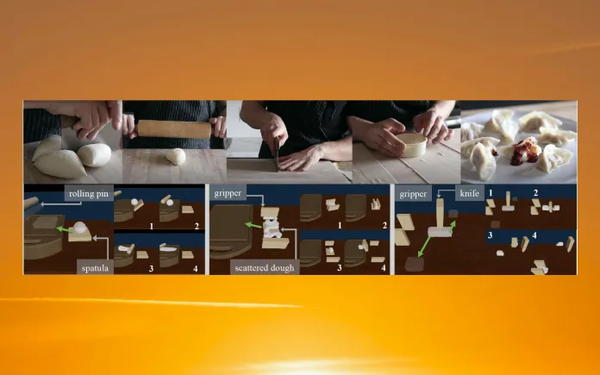
对于人类来说,处理可变形物体并不比处理刚性物体困难多少,因为我们能很自然地学会塑造它们,折叠它们,以不同的方式操纵它们,最后仍然能识别它们。
但对于机器人和人工智能系统来说,操纵可变形物体是一个巨大的挑战。例如机器人必须采取一系列步骤将面团做成披萨饼皮,它必须跟踪面团的形状变化,同时,它必须为每一步的工作选择正确的工具。对于当前的AI系统来说,这些都是具有挑战性的任务,因为它们在处理刚体对象时更稳定,状态更可预测。
现在,麻省理工学院(MIT)、卡内基梅隆大学(Carnegie Mellon University)和加州大学圣地亚哥分校(University of California at San Diego)的研究人员开发了的一种新的深度学习技术,这有望使机器人系统在处理可变形物体时更加稳定。这种技术被称为DiffSkill,它使用深度神经网络学习简单的技能,并使用规划模块结合技能来解决需要多个步骤和工具的任务。
利用强化学习和深度学习处理可变形物体
如果工智能系统想要处理一个物体,它必须能够检测和定义它的状态,并预测它未来的样子。对于刚性物体来说,这个问题已经基本解决了。通过一组良好的训练示例,深度神经网络将能够从不同角度检测刚体。然而,当涉及到可变形物体时,其多种状态空间变得更加复杂。
CMU博士生、DiffSkill论文的主要作者Xingyu Lin说:“对于刚性物体,我们可以用6个数字描述它的状态:3个数字表示它的XYZ坐标,另外3个数字表示它的方向,然而,可变形的物体,如面团或织物,有无限的自由度,这使得精确描述它们的状态变得困难得多。此外,与刚体相比,它们的变形方式也更难用数学方式建模。”
可微物理模拟器的发展使得基于梯度的方法能够应用于解决可变形物体操作任务,这与传统的强化学习方法相反,后者试图通过纯粹的试错交互来学习环境和对象的动态。
DiffSkill的灵感来自于2021年ICLR会议上展示的可微分物理模拟器PlasticineLab,PlasticineLab表明,可微分模拟器可以帮助短期任务。
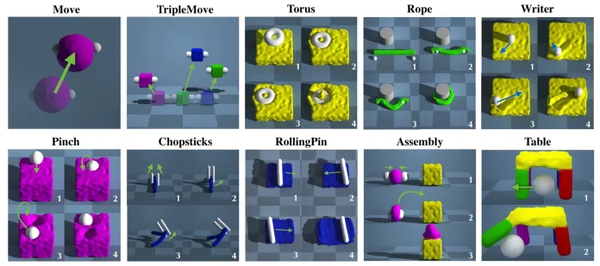
PlasticineLab 是一个基于可微分物理的可变形物体模拟器,它适用于训练基于梯度的模型
但是可微分模拟器仍然需要解决长期的问题,这些问题需要多个步骤和使用不同的工具。基于可微仿真器的AI系统也要求代理知道环境的完整模拟状态和相关物理参数。这对于现实世界的应用尤其有限,在现实世界中,代理通常通过视觉和深度感官数据(RGB-D)感知世界。
Lin教授说:“我们开始思考,是否可以将完成任务所需的步骤提取为技能,并学习这些技能的抽象概念,这样我们就可以将它们串联起来,解决更复杂的任务。”
DiffSkill是一个框架,人工智能代理使用可微物理模型学习技能抽象,并组合它们来完成复杂的操作任务。
Lin过去的工作主要集中在使用强化学习来操纵可变形物体,如布料、绳索和液体。对于DiffSkill,他选择面团操作是因为它带来的挑战。
Lin说:“ 面团的操作特别有趣,因为机器人抓手不容易完成,但需要连续使用不同的工具,这是人类擅长但机器人不太常见的事情。”
经过训练后,DiffSkill仅使用RGB-D输入即可成功完成一组面团操作任务。
利用神经网络学习抽象技能
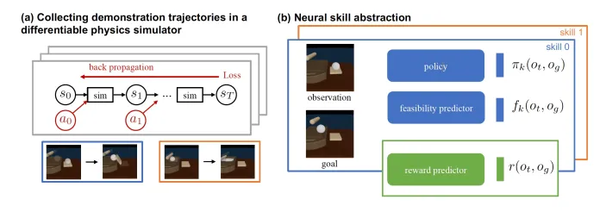
DiffSkill 训练神经网络从可微物理模拟器获得的初始状态和参数预测目标状态的可行性
DiffSkill由两个关键组件组成:1)使用神经网络学习个人技能的“神经技能抽象器”和2)组成解决长期任务技能的“计划器”。
DiffSkill使用可微物理模拟器为技能抽象器生成训练示例,这些示例展示了如何使用单一工具实现短期目标,例如使用滚轮来铺开面团或用铲子来置换面团。
这些例子以RGB-D视频的形式呈现给技能抽象者。给定一个图像观察,技能抽象者必须预测期望的目标是否可行。该模型通过将预测结果与物理模拟器的实际结果进行比较来学习和调整其参数。
于此同时,DiffSkill训练一个变分自编码器(VAE)来学习物理模拟器生成的示例的潜在空间表示。VAE在低维空间中对图像进行编码,保留重要特征并丢弃与任务无关的信息,通过将高维图像空间转移到潜在空间,VAE在使DiffSkill能够通过观察感官数据进行长期规划和预测结果方面发挥着重要作用。
训练VAE的一个重要挑战是确保它学习正确的特征,并将其推广到现实世界中,因为在现实世界中,视觉数据的组成与物理模拟器生成的数据不同。例如,擀面杖或砧板的颜色与任务无关,但擀面杖的位置和角度与面团的位置是相关的。
目前,研究人员正在使用一种名为“域随机化”的技术,它将训练环境的无关属性(如背景和照明)随机化,并保留重要特征(如工具的位置和方向),这使得VAE在实际应用时更加稳定。
Lin说:“做到这一点并不容易,因为我们需要涵盖模拟和现实世界之间的所有可能的变化(被称为模拟差距),更好的方法是使用3D点云作为场景的表示,这更容易从模拟世界转移到现实世界。事实上,我们正在进行一个后续项目,使用点云作为输入。”
规划可变形物体的长期任务
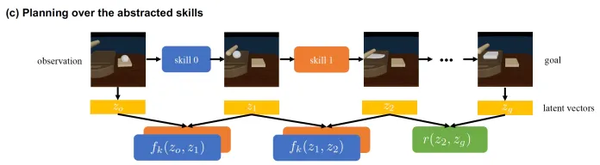
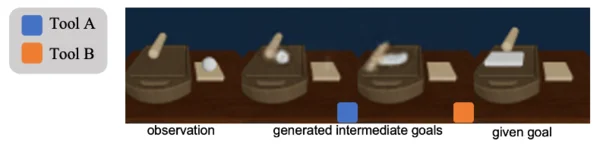
DiffSkill使用规划模块来评估可以实现目标的不同技能组合和序列
一旦技能抽象器经过训练,DiffSkill将使用规划器模块来解决长期任务,计划者必须确定从初始状态到目的地所需技能的数量和顺序。
这个计划迭代可能的技能组合和他们产生的中间结果,变分自动编码器在这里会派上用场。DiffSkill不预测完整图像结果,而是使用VAE预测中间步骤的潜在空间结果,以达到最终目标。
抽象技能和潜在空间表示的结合使得绘制从初始状态到目标的轨迹更加高效。事实上,研究人员不需要优化搜索函数,而是对所有组合进行了彻底搜索。
Lin说:“由于我们正在规划技能,计算工作也不会太多,而且时间也不长。这种详尽的搜索消除了为规划师设计草图的需要,并可能导致设计师没有以更普遍的方式考虑的新颖解决方案,尽管我们在有限的任务中没有观察到这一点。此外,还可以应用更复杂的搜索技术。”
根据DiffSkill的论文指出,“在单个NVIDIA 2080Ti GPU上,每个技能组合的优化可以在大约10秒内高效完成。”
使用 DiffSkill 准备披萨面团
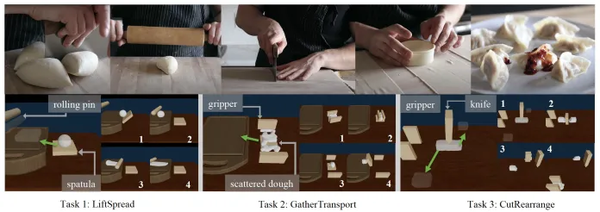
研究人员将DiffSkill的性能与几种应用于可变形物体的基线方法进行了测试,包括两种无模型强化学习算法和一种只使用物理模拟器的轨迹优化器。
模型在多个任务上进行了测试,这些任务需要多个步骤和工具。例如,在其中一个任务中,AI代理必须用铲子把面团举起来,放在砧板上,然后用滚轮把面团铺好。
结果表明,在仅利用感官信息解决长视距多工具任务时,DiffSkill明显优于其他技术。实验表明,经过良好的训练,DiffSkill规划器可以在初始状态和目标状态之间找到良好的中间状态,并找到合适的技能序列来解决任务。
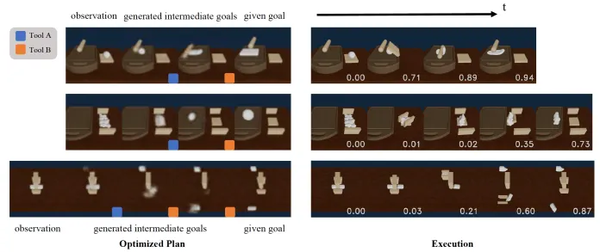
DiffSkill 的规划器可以很准确度预测中间步骤
Lin说:“一个结论是,一组技能可以提供非常重要的时间抽象,使我们能够进行长期的推理。这也类似于人类处理不同任务的方式:在不同的时间抽象中思考,而不是思考下一秒要做什么。”
然而,DiffSkill的能力也有限制。例如,当执行一个需要三阶段计划的任务时,DiffSkill的性能会显著下降(尽管它仍然比其他技术好)。Lin还提到,在某些情况下,可行性预测器会产生误报。研究人员认为,学习一个更好的潜在空间可以帮助解决这个问题。
研究人员还在探索改善DiffSkill的其他方向,包括一种更有效的规划算法,可以用于更长跨度的任务。
Lin表示,希望有一天,他可以在真正的披萨制作机器人上使用DiffSkill。“我们离这个目标还很远。各种各样的挑战出现在控制、同实传输和安全方面,但我们现在更有信心尝试一些长远的任务。”
原文链接:https://bdtechtalks.com/2022/05/09/diffskill-robotics-deformable-object-manipulation/
