概要
Block-STM是最近宣布的用于加速智能合约执行的技术,源自Diem项目。加速方法与现有区块链兼容,无需矿工/验证节点修改或采用,并且在验证(块)交易时可以独立地使任何节点受益。
这篇文章用简单的英语解释了Block-STM,并附有一个运行场景。
背景
Calvin 2012和Bohm 2014项目在分布式数据库的背景下开创了一种方法,它是以下大部分内容的基础。在这些项目中,有见地的想法是通过分发预先订购的交易批次(类似于块)以及对其读写集的预估计来简化并发管理。然后,每个数据库分区都可以根据块预顺序自主执行交易,每个交易只等待对块中较早交易的读取依赖。第一个DiemVM并行执行器实现了这种方法,但它依赖于静态交易分析器来预测读/写集,这既费时又不准确。
Dickerson等人的另一项工作。2017年提供了从传统数据库并发到智能合约并行的链接。在这项工作中,共识领导者(或矿工)通过利用乐观软件交易内存(STM)预先计算并行执行序列化,并将执行前调度指南传播给所有验证者节点。后来的工作,包括ParBlockchain和OptSmart 2021,在预执行期间添加了读/写集依赖跟踪,并传播此信息以增加并行性。这些方法消除了对静态交易分析的依赖,但需要领导者预先执行区块。
Block-STM并行执行器将预排序块思想与乐观STM相结合,即时执行交易的块预排序,完全无需预先分发执行计划或预先计算交易依赖项,同时保证可重复性。
技术概述
Block-STM是一个智能合约的并行执行引擎,围绕软件交易内存的原则构建。交易按块分组,每个块包含交易TX、TX 、...、TX的预排序序列。交易由读取和写入共享内存的智能合约代码组成,它们的执行导致读取集和写入集:读取集由对、内存位置和写入它的交易组成;write-set由对、一个内存位置和一个值组成,如果交易提交,交易将记录它们。
块预序
块的并行执行必须产生与保留块预序相同的确定性结果,即它产生与顺序执行完全相同的读/写集。如果在顺序执行中,TX读取 TX写入的值,即 TX是 TX之前写入该特定内存位置的最高交易,我们将其表示为:
TX → TX
运行示例
本文将使用以下场景来说明并行执行策略及其效果。
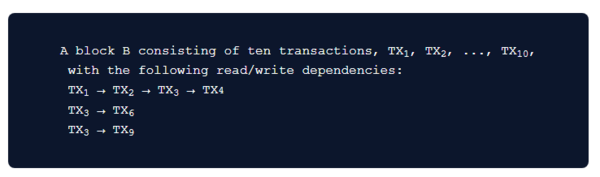
为了说明执行时间线,我们将假设一个具有四个并行线程的系统,并且为简单起见,每个事务只需要一个时间单位来处理。
如果我们事先知道上述块依赖关系,我们可以按照以下时间步长安排块B的理想执行:
- TX、TX、TX、TX的并行执行
- TX、TX的并行执行
- TX 的并行执行
- TX、TX、TX的并行执行
乐观调度
如果事先不知道依赖关系怎么办? 正确的并行执行必须保证所有事务确实读取了遵循块依赖关系的值。即TX从内存中读取时,如果存在依赖,则必须获取TX写入的值,TX → TX;或块执行开始时该内存位置的初始值,如果没有。
Block-STM通过采用乐观的“推测-验证-重做”方法来确保这一点,贪婪和乐观地并行执行交易,然后验证,如果验证失败则重复。TX的验证重新读取TX的读取集,并与TX在其最近执行中获得的原始读取集进行比较。如果比较失败,TX中止并重新执行。
关键的见解是,预购大大简化了乐观!
- 如果验证失败,则只有更高的交易需要重新验证(VALIDAFTER)
- 读取获取由前一个交易写入的最高值,而不是最后写入的值(READHIGH)
有了这个见解,我们首先考虑一个简单的稻草人方法。稻草人算法使用一个集中的调度程序来协调并行线程的工作。
Strawman (S-1) 算法
// Phase 1:
    dispatch all TX’s for execution in parallel ; wait for completion

   // Phase 2:
    repeat {
        dispatch all TX's higher than the last failed for read-set validation in parallel ; wait for completion
    } until all read-set validations pass

    read-set validation of TXj {
        re-read TXj read-set
        if read-set differs from original read-set of the latest TXj execution
            re-execute TXj
    }

    execution of TXj {
        (re-)process TXj, generating a read-set and write-set
    }
S-1 在两个主协调阶段运行。 阶段 1 乐观地并行执行所有事务。 阶段 2 以并行乐观的方式重复验证所有高于上次失败的事务,重新执行那些失败的事务,直到没有更多的读取集验证失败。
回想一下我们的运行示例,一个具有依赖关系的块B TX → TX → TX → {TX, TX, TX}),使用四个线程运行,每个交易占用一个时间单位(并忽略所有其他计算时间)。S-1在块B上的可能执行将按照以下时间步长进行:
- 阶段1开始。TX、TX、TX、TX并行执行
- TX、TX、TX、TX并行执行
- TX、TX并行执行
- 第2阶段开始。在第一次循环迭代中,对TX、TX、TX、TX失败并重新执行的所有交易进行并行读取集验证
- 对TX失败并重新执行的所有交易进行持续并行读取集验证
- 在下一阶段2循环迭代,TX、TX、TX失败并重新执行的所有交易的并行读取集验证
- 在下一个阶段2循环迭代中,TX、TX、TX失败和重新执行的所有交易的并行读取集验证
- 重新执行在最后一个阶段2循环迭代中,所有交易的并行读取集验证成功
Block-STM算法
在完整的Block-STM解决方案中,对上述稻草人进行了两项基本改进。
- 任务窃取。第一个改进是用线程的并行任务窃取替换这两个阶段。它遵循S-1的见解,区分初步执行(对应于阶段1)和重新执行(在验证中止之后)。窃取通过两个同步计数器进行协调,每个任务类型一个,nextPrelimExecution(最初为1)和 nextValidation(最初为n+1)。
窃取使较高交易的验证在完成或较低交易验证失败时立即开始。TXj的每次(重新)执行保证所有更高交易的读取集验证将通过将nextValidation减小回j+1来分派。
- 原始依赖跟踪。第二个改进是一个非常简单的依赖跟踪(没有图表或偏序),它大大减少了中止。当TX中止时,其最新调用的写入集被标记为ABORTED。更高的交易只是在读取ABORTED标记时暂停,等待重新执行TX覆盖它。这是交易预购大大简化交易的又一例证。
具有任务窃取的高级线程循环如下:
- 如果可用,则窃取下一个验证任务TX
- 否则,窃取下一个预执行任务TX
通过ABORTED标记和早期重新验证中止任务的支持依赖管理如下完成:
- 如果验证失败,标记write-set ABORTED并立即减少nextValidation
- 如果重新执行write-set与原始不同,再次减少nextValidation下面的伪代码(少于20行)给出了更精确的描述。
Block-STM算法
 // per thread main loop:
    repeat {
        task := "NA"
        // if available, steal next read-set validation task
        atomic {
            if nextValidation < nextPrelimExecution
                (task, j) := ("validate", nextValidation)
                nextValidation.increment();
        }
        if task = "validate"
            validate TXj

        // if available, steal next execution task
        else atomic {
            if nextPrelimExecution <= n
                (task, j) := ("execute", nextPrelimExecution)
                nextPrelimExecution.increment();
        }
        if task = "execute"
            execute TXj
            validate TXj
    } until nextPrelimExecution > n, nextValidation > n, and no task is still running

    read-set validation of TXj {
        re-read TXj read-set

        if read-set differs from original read-set of the latest TXj execution
            mark the TXj write-set ABORTED
            atomic { nextValidation := min(nextValidation, j+1) }
            re-execute TXj
    }

    execution of TXj {
        (re-)process TXj, generating a read-set and write-set
        resume any TX waiting for TXj's ABORTED write-set
        if the new TXj write-set contains locations not marked ABORTED
            atomic { nextValidation := min(nextValidation, j+1) }
    }
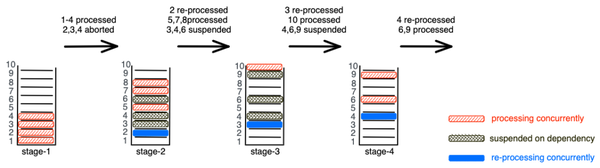
Block-STM通过使用ABORTED标签的简单、即时的依赖管理来提高效率。对于我们运行的块B示例,具有四个线程的执行可能能够通过等待ABORTED标记来避免在稻草人场景中发生的几次重新执行。尽管存在高竞争B场景,Block-STM的可能执行可能会非常接近最优调度,如下所示。块B上的可能执行(召回,TX → TX → TX → {TX, TX, TX})将按照以下时间步长进行(如图所示):
- TX、TX、TX 、TX的并行执行;TX、TX 、TX的读集验证失败;nextValidation设置为3
- 并行执行TX、TX、TX、TX;TX、TX4、TX6 的执行在 ABORTED 时暂停; nextValidation设置为6
- 并行执行TX、TX;TX、TX、TX的执行在ABORTED时暂停;所有读取集验证成功(目前)
- TX、TX、TX的并行执行;所有读取集验证成功
正确性
正确的乐观主义围绕着维护两个原则:
- READHIGH(k):每当 TXk 执行时(推测性地),TX的读取获得迄今为止由它之前的最高交易TX记录的值,即j < k。较高的交易TX,其中 l > k,不会干扰TX。
- VALIDAFTER(j, k):对于每个j,k,使得j < k,每次TX执行(或重新执行)时都会对TX的读取集进行验证。
无论交易如何安排,这两个原则都足以保证安全性和活跃性。简而言之,安全性紧随其后,因为在所有TX,j < k,最终确定之后,TX得到验证。活力源于归纳。最初交易1保证成功通过读取集验证并且不需要重新执行。在从TX到 TX的所有事务都成功验证后,交易j+1的(重新)执行将成功通过读取集验证,不需要重新执行。
READHIGH(k) 在Block-STM中通过一个简单的多版本内存数据结构实现,该结构保持版本化的写入集。TX的写入记录在版本j中。TX的一次读取获得了最近一次调用TX记录的值,其中j < k最高。
当最新的TX调用中止时,特殊值ABORTED可以存储在版本j中。 如果TX读取该值,它将暂停并在该值被设置时恢复。
VALIDAFTER(j, k) 是通过为每个TX调度一个TX的读取集验证来实现的,对于每个k > j,在TX完成(重新)执行之后。与早期重新验证的交互有点微妙。假设TX → TX。回想一下,当TX失败时,Block-STM在TX完成重新执行之前立即安排(重新)验证TX,k > j。有两种可能的情况。如果TX-validation读取到TX的ABORTED值,它将等待TX完成;如果它读取了一个没有标记为ABORTED的值并且TX重新执行有一个新的写入集,那么TX将被强制再次重新验证。
结论
简单性是Block-STM的优点,而不是失败,它能够实现健壮和稳定的实现。通过仔细组合简单的已知技术并将它们应用于批量提交的预排序交易块,Block-STM:
- 实现智能合约并行处理的有效加速
- 实现可重复执行(必需)
- 由于线性依赖/验证,STM变得实用
- 每个块批量提交(而不是每个交易)
- 让客户独立受益
- 可以与/在现有区块链上工作,而无需所有/其他验证节点采用
Block-STM已集成在Diem区块链核心 (https://github.com/diem/) 中,并在合成交易工作负载上进行了评估,在低/适度竞争的32个核心上产生了超过17倍的加速。
原文链接:https://blog.chain.link/block-stm/
---煤油灯科技victorlamp.com翻译整理---
