吴恩达(Andrew Ng)是当今 AI 领域的杰出影响力人物,他是AI和机器学习领域国际最权威学者之一,他将自己的新认识带到了 AI 领域,即“以数据为中心的 AI ”方法,他和他的企业经常传播这个词。
吴恩达多次解释实施这种方法的重要性。在本文中,我们将了解他所说的“以数据为中心的 AI ”是什么意思,以及如何在NLP任务中实现它。
吴恩达(Andrew Ng)
吴恩达视频链接:https://youtu.be/TU6u_T-s68Y,https://youtu.be/06-AZXmwHjo,https://youtu.be/Yqj7Kyjznh4
本文安排如下:
- 数据中心AI的定义
- 以数据为中心的AI vs以模型为中心的AI
- 以数据为中心的AI应用程序
- 在NLP中实现以数据为中心的AI
- 结论
以数据为中心的AI的定义
“以数据为中心的AI是一门系统地设计用于构建AI系统的数据的学科。”------(datacentricai.org/)
正如上面的定义所述,简单地说一个“以数据为中心的AI”,就表明了开发ML模型的不同方法。许多人倾向于保持训练集固定,然后设计/调优模型,以实现预定义的目标。但是,在“以数据为中心的AI”中,你要考虑模型消耗的数据的本质。因此,您需要实现许多技术来尽可能完美地创建数据。
以数据为中心的AI vs 以模型为中心的AI
下图清楚地显示了以模型为中心和以数据为中心之间的区别。当您实现前者时,您坚持思考“我如何调优模型以获得更好的结果?”
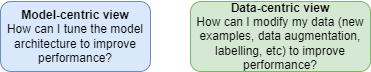
以模型为中心与以数据为中心的比较
吴恩达表示,目前大约99%的AI研究都实现了以模型为中心的视图。由于没有全球通用的公认标准来创建大型数据集,研究人员倾向于认为以模型为中心的方法是当今人工智能的解决方案,在深入关注模型改进之前,数据提供常常被低估,数据收集只执行一次。
另一方面,应用数据中心观点的人工智能研究仍然很少。在视图中,您先固定架构,然后修改数据集。因为数据是模型的食物,所以它应该被喂给最好的“食物”。吴恩达还说,我们必须更全面地看待人工智能系统,人工智能系统不仅仅是一个模型,数据也发挥着至关重要的作用。
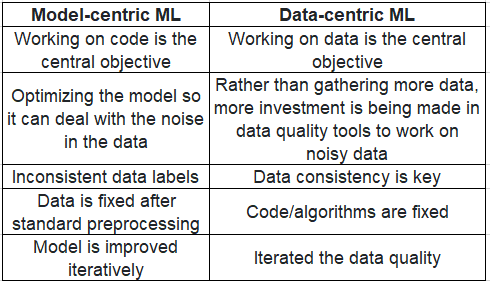
以模型为中心和以数据为中心的特点
吴恩达的一些以数据为中心的 AI 应用程序
- Steel inspection 钢材检验
这是吴恩达在Landing AI的一个项目,他和他的团队开发了一个物体检测模型来检测给定的钢铁是否有缺陷,他陈述了在制造公司收集更多数据是多么困难。
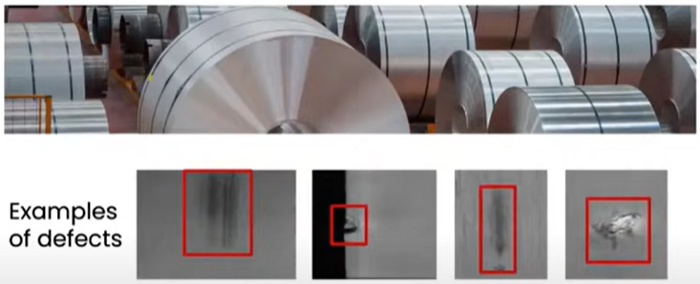
用物体探测器检测钢材
吴恩达和他的团队尝试了两种方法:以模型为中心和以数据为中心。他们对每个探测器(钢铁缺陷探测器,太阳能电池板探测器,表面检测器)都有基线评分。当他们实现以模型为中心的方法时,试图调优模型超参数(甚至获得最佳的模型体系结构),结果几乎没有增加。同时,当他们决定修正输入到模型中的数据时,他们得到了非常有希望的结果,即分别为+16.9%、3.06%和0.4%。
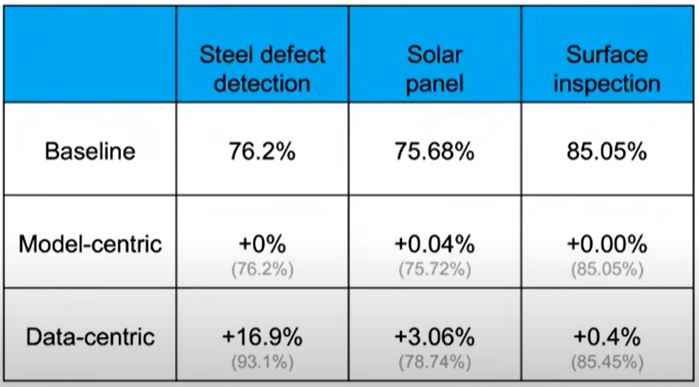
实施以模型为中心和以数据为中心时的结果
- Labelling inconsistency 标签不一致
吴恩达举了一个例子,说明注释者通常不同意彼此的标签标准。这种现象被称为标签不一致,即模型以多种标签方式提供数据。这个问题将使模型难以捕获数据及其标签背后的模式,并导致模型的性能下降。
为了克服标签的不一致性,吴恩达建议注释者必须坐在一起,并确定一种合适的方式来标记数据,以使所有人都同意。换句话说,他们必须在标签数据上达成一种约定。
吴恩达分享的一些标签不一致的案例如下:
1.鬣蜥(Iguana)检测
如下图所示,有三种标签情况:
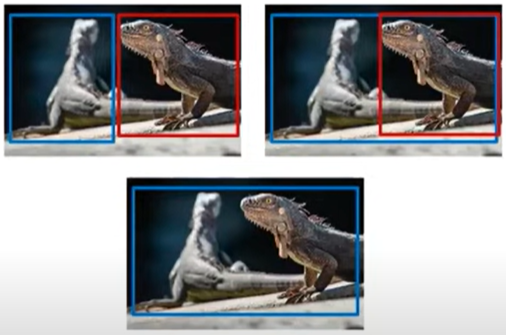
Iguana 示例说明注释者如何不一致
左上角的图片显示了注释器如何为两只平分的鬣蜥绘制两个边界框。在右上角的图片中,另一个注释者有他/她自己的规则来标记鬣蜥。他/她可能认为左边鬣蜥的尾巴延伸到右边,所以他/她决定沿着尾巴画一个边界框。最后一张图,也就是下面这张图,再次描绘了另一个注释器。他/她可能会认为,因为两只鬣蜥几乎互相重叠,他/她决定只画一个边界框来覆盖它们。
任何标签方法都是可以的,但是注释者必须在所有数据中使用一种单一的标签约定。
2. 钢材缺陷检测
吴恩达讲的另一个例子是钢材缺陷的检测,给贴标员图片贴标。在下面的图片中,两个标签匠在如何标签的问题上意见不一致。标签师1可能认为每个缺陷只是一个小点,然后他/她在每个点标签上画一个小边界框。与此同时,“标签者2号”可能认为这些小点可以组合成两组。
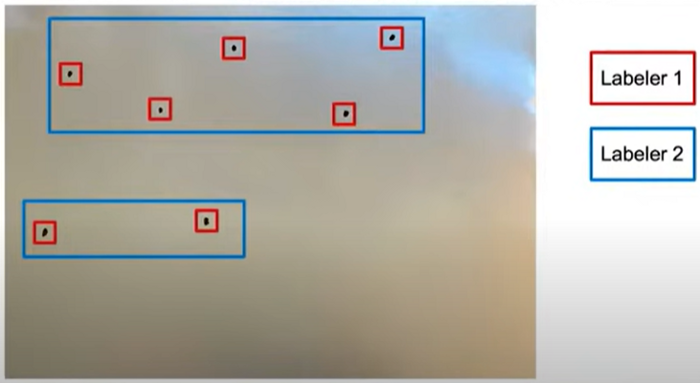
注释者如何不一致的钢缺陷示例
同样,任何标记方式都可以。但是两个标注者必须就所有数据的单一约定标签达成一致。
在NLP中实现以数据为中心的AI
在吴恩达的讲解中,他主要分享以数据为中心的AI在计算机视觉或语音识别领域的应用。所以,一个问题可能会出现:“我现在同意你的数据中心概念,但我如何在NLP领域实现以数据为中心的AI,因为我在我的工作中有很多NLP任务?”
根据吴恩达在Coursera上的一门在线课程,即《生产中的机器学习导论》(面向生产专业化的机器学习工程的第一门课程),在鬣蜥蜴的例子中(我们刚刚讨论过),我们可以认为不同的标签策略是由不同的标签规则和不同的注释器所导致的。这就是为什么,用同样的概念,我们也可以为NLP任务引入一个“鬣蜥”的例子。例如,我们可以创建一个标签规则来标记文本数据集,以表示一种标签策略。
数据的理解
让我们以YouTube视频评论的数据集为例,我们将区分给定的评论是否是垃圾邮件(标签1)或不是(标签0),下图显示了我们整个数据集的头部。
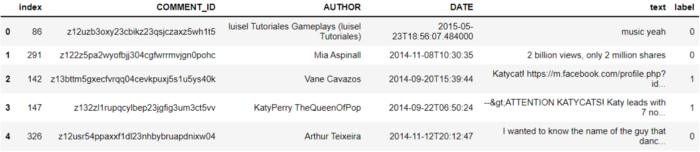
数据帧头
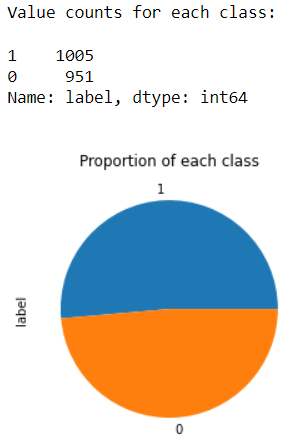
数据集非常平衡,如下图所示:
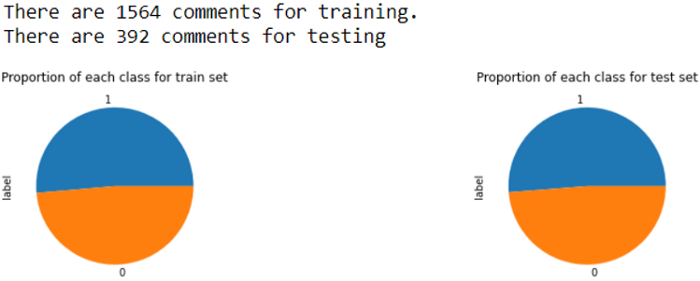
在应用train_test_split后,我们使用分层参数来确保sklearn保持比例分割。下图显示了结果:
模型定义
我们可以使用scikit-learn的CountVectorizer对数据集进行向量化。对于主模型,为了简单起见,我们可以使用scikit-learn的多项朴素贝叶斯分类器。正如我们前面所讨论的,在以数据为中心的视图中,我们保持模型固定,我们可以让CountVectorizer和multimialnb使用它们的默认超参数。对于结果度量,由于本例只是一个二元分类,而且两个标签都相对平衡,所以我们只使用精度评分。
实施不同的标签策略
在正确定义矢量器和模型之后,我们可以尝试不同的标签规则。通过观察这些策略,我们将知道标签是提高模型性能的关键步骤。
- 正确的标签
首先,让我们看看如果从数据集中使用正确的标签会得到什么。
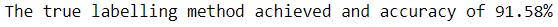
正确标签策略的准确性
仅仅通过使用一个简单的矢量器和一个具有默认设置的简单模型,我们就可以实现如此高的结果。但是,这并不奇怪,因为这种标记策略清楚地完美地标记了数据集,使模型容易捕获模式,从而在垃圾邮件和非垃圾邮件之间进行分类。
这个结果就是我们的上界,表示最好的结果。
- 随机标签
建立下界的自然方法是使用随机生成来标记数据集。在我们运行10次随机迭代后,所有结果的平均值如下:
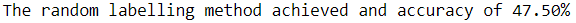
因为本例是一个具有相对平衡类的二元分类,您可以预期精确度在50%左右。如果你有更多的类和不平衡的其他数据集,你可能会得到更多样化的随机结果。
不管怎样,这个结果是我们的下限,表示最坏结果。
- 标签策略
让我们假设,由于某种原因,我们无法访问与数据集中每个数据点相关的真实标签。人们很自然地认为,数据中的模式会提供哪些是正确标签的线索。当然,这非常依赖于我们正在处理的数据类型,甚至假设存在哪些模式都需要大量的领域知识。
对于许多人来说,提出一些规则来帮助识别YouTube视频的垃圾评论和非垃圾评论是合理的。在下一节中,我们将使用这些规则执行自动标记。我们可以把这个过程的每一次迭代看作具有不同标记标准的标记器。
首先,让我们来定义如何对标签进行编码:
—SPAM用1表示
—NOT_SPAM为0
—NO_LABEL为-1
您可能想知道NO_LABEL关键字。根据我们提出的规则,这些可能不适用于某些数据点。在这种情况下,最好是拒绝给出标签,而不是猜测,我们已经看到猜测产生了不好的结果。
您可能想知道NO_LABEL关键字。根据我们提出的规则,这些可能不适用于某些数据点。在这种情况下,最好是拒绝给出标签,而不是猜测,我们已经看到猜测产生了不好的结果。
1. 第一次迭代
在第一次迭代中,我们将尝试一个简单的规则来指示是否给定的评论是垃圾邮件或不是。如果给定的comment包含以下字符串之一,则将其标记为SPAM或NO_LABEL:
—“free”:通常垃圾评论通过推广免费内容来戏弄用户
—“subs”:垃圾评论通常要求用户订阅某个网站或频道
—“http”:垃圾评论通常包含链接
第一次迭代的问题是我们没有NOT_SPAM标签。换句话说,我们在训练集中只有一个类,而我们的测试集实际上包含两个标签。因此,我们只保留24.23%的训练集数据(见下图)。当我们使用标签数据(使用这个规则进行标记)来训练模型时,我们得到的结果比随机标签略好,如下图所示:
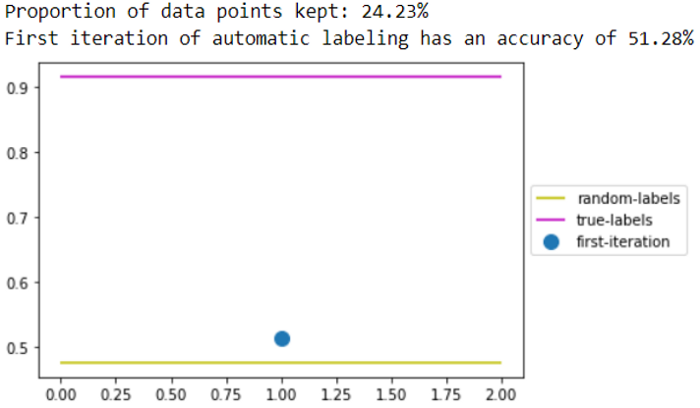
第一次迭代——标签策略
2. 第二次迭代
在第二个迭代中,我们将尝试添加更多的规则。当我们稍微深入检查注释时,我们会发现NOT_SPAM注释倾向于包含单词“view”或“song”。因为我们使用的数据集是来自YouTube上观看最多的视频的评论,所以人们评论“view”或“song”是很常见的。对于垃圾邮件评论,我们还增加了两个词,即“gift”和“follow”。否则,我们将它标记为NO_LABEL。
通过应用第二次迭代,我们可以保留44%的总训练集,而且现在我们对两个类都有了标签——这是我们在第一次迭代中无法得到的条件。这两个类的标签确实帮助模型比第一次迭代执行得更好,如下图所示。然而,我们离上限还很远。
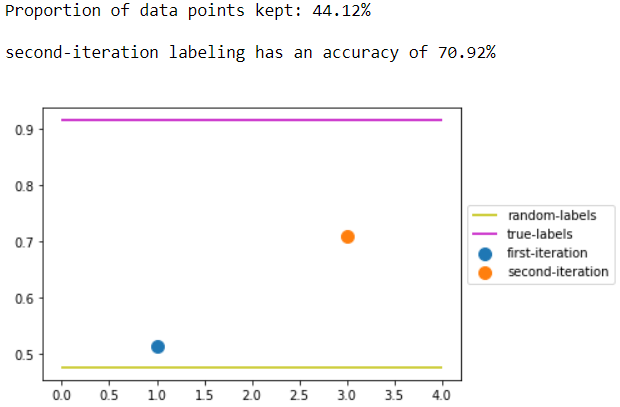
第二次迭代——标注策略
3.第三次迭代
在第三次迭代中,我们将添加另一种方法。如果我们看一下NOT_SPAM注释,它们比SPAM注释相对更短。它们的平均长度说明了它们的区别。
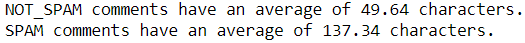
接下来,我们可以确定要在NOT_SPAM和SPAM之间切割的长度阈值。一种简单的方法是查看NOT_SPAM注释长度的直方图,如下图所示:
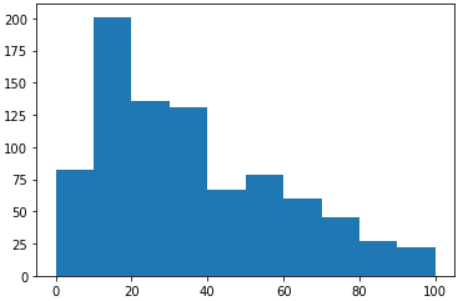
NOT_SPAM评论长度直方图
我们可以看到,大多数NOT_SPAM注释的字符不超过30个。因此,我们设置了一个规则,如果给定的评论长度小于30个字符,那么它将被标记为NOT_SPAM。另一方面,我们还为SPAM规则添加了另一个词,即“check out”。
第三次迭代的结果如下所示。到目前为止,我们所有的规则都在保持78%的数据和给予模型大于86%的准确性方面产生了有希望的结果!也许,我们定义的规则越多,我们就越接近上限(希望如此)。
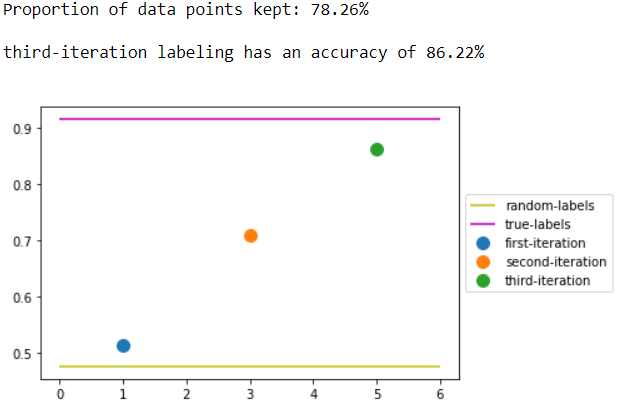
第三次迭代——标签策略
4. 第四次迭代
在第四次迭代中,我们修改了前面实现的“http”字。如果我们关注数据集,我们可以看到大多数SPAM评论包含一个具有各种形式的URL。因此,我们将不只是搜索文本中是否有“http”,而是实现RegEx将评论文本与URL模式相匹配。
我们还发现,垃圾邮件评论通常使用一些词来提供他们的产品,如“money”和“app”。对于NON_SPAM注释,我们将尝试插入“omg”单词。
迭代的结果如下图所示。我们看到,这次迭代可以保持82%以上的数据,比第三次迭代提高了约4%。然而,不幸的是,即使我们有足够的数据比例的提高,我们不能得到同样的提高模型的准确性,因为它只提高了约1%。
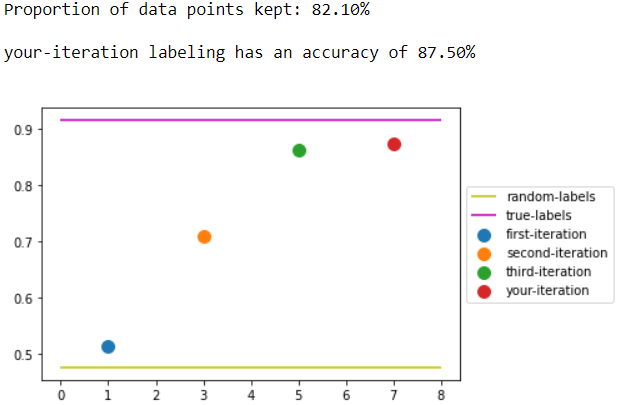
第四次迭代——标注策略
到目前为止,我们已经发现,为了越来越接近上限(真正的标签),我们会有更复杂的规则。但是,通过达到这一点,我们明白了不同的标签策略明显会影响模型的性能。
结论
到目前为止,我们学到了很多东西。总结一下我们一开始讨论的内容:
由吴恩达和他的同事发起的以数据为中心的观点,为我们应该如何对待AI系统带来了一个全新的想法。
以模型为中心的视图关注如何调优模型架构以提高性能,而以数据为中心的视图关注如何修改数据以提高性能。
几乎所有的人工智能研究都实现了以模型为中心的视图。
我们可以做很多事情来实现以数据为中心的视图,例如标签一致性,带来高质量的数据,专注于干净的数据等等。
数据中心视图也可以在NLP中实现。例如,文本数据的标签一致性和质量确实会影响模型的性能,你的品牌越好,你的模型就会越好。
吴恩达视频链接:https://youtu.be/TU6u_T-s68Y,https://youtu.be/06-AZXmwHjo,https://youtu.be/Yqj7Kyjznh4
原文链接:https://utomorezadwi.medium.com/how-to-implement-data-centric-ai-in-nlp-512972a5676b
