自然语言处理、深度学习、语音识别和模式识别只是近年来不断进步的几种人工智能技术,这些技术帮助聊天机器人大幅增长。
越来越多的聊天机器人被应用于教育、电子商务客户支持、公共场所服务、智能设备等领域,而不仅仅是娱乐设备,因为大多数人仍然认为它们是娱乐设备。我相信你知道谷歌助手,你有没有想过这些聊天机器人和谷歌助手是如何工作的?它们是使用Seq2Seq模型构建的。在本文中,我们将看到Seq2Seq(sequence-to-sequence)模型。
什么是Seq2Seq模型?
在许多任务中,深度学习模型与人类相比具有相似的准确性。这些模型可以更高效、准确地映射输入和输出。但其中一个挑战是将一个序列映射到另一个序列,并具有与人相似的准确性,这被称为机器翻译,在语音或语言翻译中被发现。
深度学习模型对于机器翻译以适当的顺序和顺序生成结果至关重要。翻译一个句子的主要困难之一,比如从英语翻译到汉语,是输出序列可能在字数或句子长度方面与输入序列不同。
简单地说,seq2seq是机器学习中的一个模型,用于翻译任务。它接受一系列称为输入的项,并给出另一系列称为输出的项,该模型最初由谷歌引入用于机器翻译。在这个模型被引入之前,它被用来翻译,输出有语法错误,没有正确的句子结构,该模型为机器翻译任务带来了巨大的变革。以前,当一个句子被翻译成另一种语言时,只考虑一个特定的单词,但是seq2seq模型考虑它的相邻单词以进行翻译。这为结果提供了一个逻辑结构。该模型使用循环神经网络(RNN)。循环神经网络(RNN)是一种人工神经网络,其中节点之间的连接可以形成一个循环,允许一些节点的输出影响网络中其他节点接收的输入。因此,它可以以动态的方式运行。
Seq2seq模型的应用
如今,在这个人工智能发展的世界中,seq2seq模型有许多应用。谷歌翻译、聊天机器人和语音嵌入式系统都使用这个模型来构建。其中一些应用如下:
1. 机器翻译:seq2seq模型最著名的应用是机器翻译。在没有人工翻译的情况下,机器翻译使用人工智能将文本从一种语言翻译成另一种语言。谷歌、微软甚至Netflix等公司都使用机器翻译来达到自己的目的。
2. 语音识别:机器或程序理解大声说出的单词并将其翻译成可读文本的能力称为语音识别,通常称为语音到文本。
Uniphore专注于对话式人工智能技术,并通过多个接触点帮助企业提供变革性客户服务。它使用语音识别技术。Nuance Communications提供语音识别和人工智能产品,专注于服务器和嵌入式语音识别。
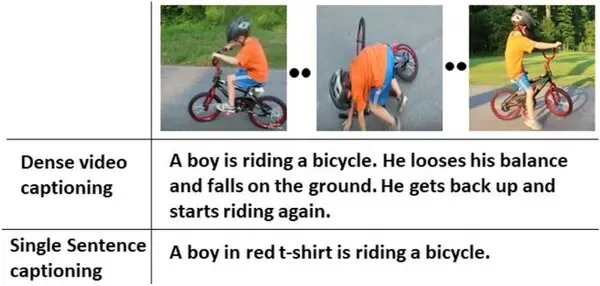
3.视频字幕:在理解视频动作和事件的同时,自动为视频配字幕的过程,可以提高通过文本对视频的有效检索。
许多公司,如Netflix、Youtube和亚马逊,都使用视频字幕技术为视频生成字幕。
Seq2seq模型的工作
现在让我们看看实际模型的工作情况。模型主要采用编码器-解码器结构,顾名思义,Seq2seq从输入的单词序列(句子或句子)中创建单词序列。利用循环神经网络(RNN)实现了这一点。LSTM或GRU是RNN的更高级变体,比很少使用的更基本的版本使用得更频繁。这是由于RNN存在消失梯度问题,谷歌推荐的版本使用了LSTM。每个时刻都需要两个输入,这就创造了单词的上下文。循环指的是两个输出,一个来自用户,另一个来自过去的输出(输出作为输入)。
因为它主要由一个编码器和一个解码器组成,所以有时也被称为编码器-解码器网络。
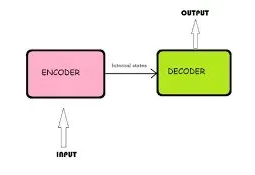
编码器将从输入序列(隐藏向量)创建一个一维向量,隐藏向量将由解码器传入输出序列。编码器可以通过堆叠许多RNN单元来创建,RNN依次读取每个输入,模型的最终隐藏状态表示编码器模型读取所有输入后整个输入序列的上下文/摘要,在编码器模型的末尾获得的最终隐藏向量作为解码器的输入,解码器使用隐藏状态作为输入,通过预测结果来创建输出序列。
Seq2Seq模型的类型
有两种模型:
- Original 或 Vanilla Seq2Seq模型
- 基于注意力的Seq2Seq模型
Original 或 Vanilla Seq2Seq模型
基本架构被描述为Sutskever等人建议的原始Seq2Seq的多个LSTM。编码器和解码器都采用了这种结构。但是,您也可以使用GRU、LSTM和RNN。我们将使用RNN来更好地说明Seq2Seq模型中发生了什么。
RNN体系结构通常很简单。它需要两个输入:一个来自输入序列的单词和一个上下文向量或任何隐藏在输入中的东西。
基于注意力的Seq2Seq模型
在这里,在基于注意力的Seq2Seq中,我们构建了许多对应于序列中的每个元素的隐藏状态,与原始的Seq2Seq模型相反,在原始的Seq2Seq模型中,我们只有来自编码器的一个最终隐藏状态,这使得在上下文向量中存储更多数据成为可能。因为考虑了每个输入元素的隐藏状态,所以我们需要一个上下文向量,它不仅可以从这些隐藏状态中提取最相关的信息,还可以删除任何无用的信息。换句话说,我们希望我们的模型专注于关键的表示和特征。
在基于注意力的Seq2Seq模型中,上下文向量充当解码器的起点。然而,与基本的Seq2Seq模型相反,解码器的隐藏状态被传递回全连接层以创建一个新的上下文向量。因此,与传统Seq2Seq模型的固定上下文向量相比,基于注意的Seq2Seq模型的上下文向量更具动态性和可调性。
Seq2Seq模型面临的挑战
- Seq2Seq模型的优化具有挑战性,需要大量的计算机培训资源。
- 如果Seq2Seq模型没有正确正则化,它们可能会过度拟合训练数据,并且在新数据上表现不佳。
- Seq2Seq模型的内部工作原理很难理解,因此很难理解模型为什么要采取特定的操作。
- 对于Seq2Seq模型来说,训练集中不存在的不常见术语的处理可能具有挑战性。
- 由于上下文向量可能无法捕获输入序列中的所有信息,因此Seq2Seq模型在处理非常长的输入序列时可能会遇到问题。
结论
您每天使用的许多技术都是基于序列到序列模型的,例如,声控设备、在线聊天机器人和谷歌翻译等服务都是由seq2seq架构提供支持的。Seq2Seq模型能够执行各种任务,包括变长输入和输出序列、文本摘要和图像字幕。
- 需要序列数据的应用程序,如时间序列数据、语音和自然语言,非常适合Seq2Seq模型。
- 如今,这些模型是最有用和最流行的。许多大公司使用这些模型来构建他们的系统。
- Seq2Seq模型能够表现良好,因为它们可以在大量数据上进行训练。
- 任何基于序列的问题都可以使用该技术解决,特别是当输入和输出的大小不同时。
