摘要
我们描述了一个点对点的分布式哈希表,在易出错的环境中具有可证明的一致性和性能。我们的系统使用一种新颖的基于XOR的度量拓扑来路由查询和定位节点,该拓扑简化了算法并促进了我们的证明。拓扑具有这样的特性:每条交换的消息都传达或强化了有用的联系信息。系统利用此信息发送并行、异步查询消息,这些消息可以容忍节点故障,而不会对用户造成超时延迟。
1 引言
本文描述了Kademlia,一种点对点分布式哈希表 (DHT) Kademlia具有许多以前的DHT无法同时提供的理想特性。它最大限度地减少了节点必须发送以相互了解的配置消息的数量。 配置信息作为键查找的副作用自动传播。节点有足够的知识和灵活性通过低延迟路径路由查询。Kademlia使用并行、异步查询来避免来自故障节点的超时延迟。节点记录彼此存在的算法可以抵抗某些基本的拒绝服务攻击。
最后,可以仅使用对正常运行时间分布的弱假设(我们通过现有对等系统的测量验证的假设)正式证明Kademlia的几个重要属性,Kademlia采用许多DHT的基本方法。密钥是不透明的160位数量(例如,一些较大数据的SHA-1哈希)。参与的计算机在160位密钥空间中都有一个节点ID。 (key,value) 对存储在 ID 与键“接近”的节点上,以实现某种接近性概念。最后,基于节点ID的路由算法可以让任何人有效地定位任何给定目标键附近的服务器。
Kademlia的许多好处来自于它使用一种新颖的XOR度量来衡量关键空间中点之间的距离。XOR是对称的,允许Kademlia参与者接收来自完全相同分布的查找查询包含在其路由表中的节点。如果没有这个属性,像Chord [5]这样的系统就不会从它们收到的查询中学习有用的路由信息。
更糟糕的是,不对称会导致死板的路由表。Chord节点的手指表中的每个条目都必须存储ID空间中某个区间之前的精确节点,任何实际在该区间中的节点都会与同一区间中它之前的节点相距太远。相比之下,Kademlia可以在一个时间间隔内向任何节点发送查询,允许它根据延迟选择路由,甚至向几个同样合适的节点发送并行、异步查询。
为了定位特定ID附近的节点,Kademlia 从头到尾使用单一路由算法。相比之下,其他系统使用一种算法来接近目标ID,而在最后几跳使用另一种算法。在现有系统中,Kademlia最类似于Pastry的 [1] 第一阶段,它(尽管作者没有这样描述)通过Kademlia的XOR度量连续找到距离目标ID大约一半的节点。然而,在第二阶段,Pastry将距离度量转换为 ID 之间的数字差异。它还在复制中使用第二个数字差异度量。不幸的是,靠近第二个指标的节点可能与第一个指标相距甚远,从而在特定节点 ID 值处产生不连续性,降低性能,并使对最坏情况行为的正式分析尝试变得复杂。
2 系统描述
我们的系统采用与其他DHT相同的通用方法,将160位的不透明ID分配给节点,并提供一种查找算法,该算法将连续“更接近”的节点定位到任何目标ID,以对数多步收敛到查找目标。
Kademlia有效地将节点视为二叉树中的叶子,每个节点的位置由其ID的最短唯一前缀确定。图1显示了示例树中具有唯一前缀0011的节点的位置。对于任何给定的节点,我们将二叉树划分为一系列不包含该节点的连续较低的子树。最高子树由不包含节点的二叉树的一半组成,下一个子树由不包含节点的剩余树的一半组成,依此类推。 在节点0011的示例中,子树被圈起来,由前缀分别为1、01、000和0010的所有节点组成,“Kademlia协议确保每个节点都知道其每个子树中的至少一个节点,如果 子树包含一个节点,有了这个保证,任何节点都可以通过它的 ID 定位到任何其他节点,图 2 显示了一个节点0011定位节点1110的示例,通过依次查询它所知道的最佳节点来查找更低和更低的子树中的联系人; 最终查找收敛到目标节点,'本节的其余部分填充细节并使查找算法更加具体,我们首先定义一个精确的 ID 接近度概念,允许我们谈论存储和查找(关键 , value) 对在离键最近的 k 个节点上,然后我们给出一个查找协议,即使在没有节点与一个键共享一个唯一的前缀,或者与某一节点相关的一些子树是空的。
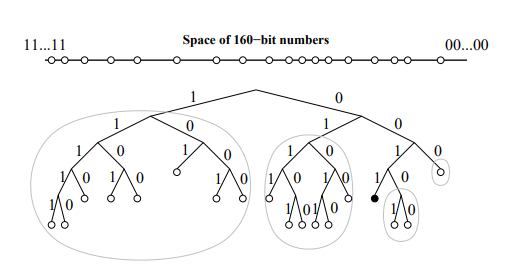
图1:Kademlia二叉树。 黑点显示节点 0011... 在树中的位置。灰色椭圆显示节点0011--- 必须有一个联系人的子树。
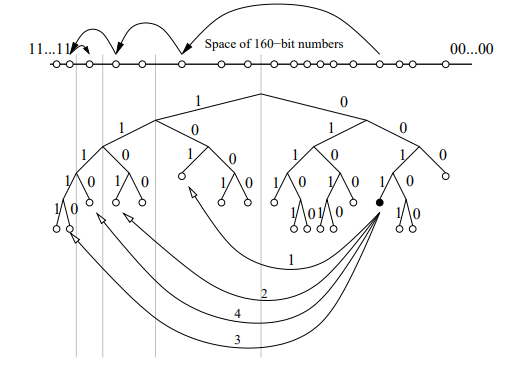
图2:通过ID定位一个节点。在这里,前缀为0011的节点通过连续学习和查询较近和较远的节点,找到前缀为1110的节点,通过连续学习和查询越来越近的节点。上面的线段代表160位ID的空间 ,并显示了查询是如何收敛到目标节点的。下面我们说明 由1110发出的RPC消息。第一个RPC是给节点101的,1110已经知道 。后续的RPC是指向由前一个RPC返回的节点。
2.1 XOR度量
每个Kademlia节点都有一个160位的节点ID。节点ID目前只是随机的160位的标识符,尽管它们也可以像Chord一样被构建。
节点发送的每条信息都包括其节点ID,允许接收者在必要时记录发送者的存在。
密钥也是160位的标识符。为了将(key,value)对分配给特定的节点,Kademlia依靠的是两个标识符之间的距离概念。给定 两个160位的标识符,x和y,Kademlia将它们之间的距离定义为它们的按位异或(XOR)解释为一个整数,d(x,y)=2 ® y。
我们首先注意到,XOR是一个有效的,尽管是非欧几里得的度量,很明显 d(x,x) =0, d(x, y) > Oif x #y, and Vz,y : d(z,y) = d(y,2) 。XOR 也提供了三角形属性:d(x,y) +d(y,2) > d(z,z)。三角形属性源于这样一个事实:d(x,y) @ d(y, 2) = d(x, 2) 和Va > 0,b>0:a+d> aed。
接下来我们注意到,XOR捕捉到了我们基于二叉树的系统简图中隐含的距离概念。在一个由160位ID组成的完全填充的二进制树中。两个ID之间的距离的大小是包含它们的最小的子树的高度。当一棵树没有被完全填充时,离一个ID x最近的 的叶子是其ID共享最长的共同前缀2的那个叶子。如果树上有空的分支,可能会有不止一个叶子具有最长的共同前缀的叶子。在这种情况下,与x最接近的叶子将是通过翻转x中对应于树的空分支所产生的最接近ID的叶子。
与Chord的顺时针圆周度量一样,XOR是单向的。对于任何给定的点x和距离A > 0,只有一个点y使得 d(z,y) = A沿着查找路径缓存(键,值)对可以缓解热点。与Pastry和Chord不同,XOR 拓扑也是对称的(对于所有x和y,d(x, y) = d(y,2))
2.2 节点状态
Kademlia节点存储彼此的联系信息以路由查询消息。对于每个0 < i < 160,每个节点都会为距离在2'和2'*之间的节点保留一个(IP 地址、UDP端口、节点ID)三元组列表!从自身出发,我们称这些列表为k-bucket,每个k-bucket都按上次看到的时间排序——最近最少看到的节点位于头部,最近看到的节点位于尾部。对于较小的i值,k-bucket通常是空的(a5不存在适当的节点),对于较大的i值,列表可以增长到大小k,其中k是系统范围的复制参数 kis 选择这样任何给定的k个节点都不太可能在一个小时内彼此发生故障(例如 k = 20)。
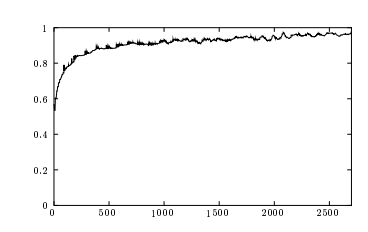
图3:作为正常运行时间的函数,再在线一小时的概率。x轴代表分钟,y轴显示在线至少x分钟且在线至少x +60分钟的节点比例。
当Kademlia节点接收到来自另一个节点的任何消息(请求或回复)时,它会为发送者的节点ID更新相应的k-bucket,如果发送节点已经存在于接收者的k-bucket 中,则接收者将其移动到尾部 名单。如果节点还没有在合适的k-bucket中并且存储桶中的条目少于k个,那么接收者只需将新的发送者插入到列表的尾部。但是,如果适当的k-bucket已满,则接收者ping k-bucket的最近最少看到的节点来决定要做什么,如果最近最少看到的节点未能响应,则将其从k-bucket中逐出,并在尾部插入新的发送者。否则,如果最近看到的节点做出响应,则将其移动到列表的尾部,并丢弃新发件人的联系人。
k-buckets有效地实现了最近最少看到的驱逐策略,除了活动节点永远不会从列表中删除。这种对旧联系人的偏好是由我们对Sarou等人收集的Gnutella跟踪数据的分析驱动的。图3显示了作为当前正常运行时间函数的Gnutella节点的百分比,该百分比作为当前正常运行时间的函数。阳极运行的时间越长,它继续运行一个小时的可能性就越大。通过保留最旧的实时联系人,k-buckets最大限度地提高了它们包含的节点保持在线的可能性。k-buckets 的第二个好处是它们可以抵抗某些DoS攻击,不能通过淹没系统来刷新节点的路由状态 对于新节点,Kademlia节点只会在旧节点离开系统时将新节点插入k-buckets。
2.3 Kademlia协议
Kademlia协议由四个RPC组成:PING、STORE、FIND-NODE 和 FIND.VALUB,PING RPC探测节点是否在线,STORE指示节点存储(键,值)对,为了以后的检索,FIND.NODE将160位ID作为参数。RPC的接收者为它知道的k个节点返回(IP 地址、UDP 端口、节点 ID)三元组最接近目标ID。这些三元组可以来自一个k-bucket,或者它们可以来自多个k-bucket,如果最近的k-bucket没有满的话。在任何情况下 RPC接收者必须返回k个项目(除非其所有k-buckets中的节点总数少于k,在这种情况下,它会返回它所知道的每个节点) 。
FIND.VALUE的行为类似于FIND_NODE——返回(IP地址、UDP端口、节点ID)三倍。除了一个例外,如果RPC接收者已经收到了密钥的STORE RPC,它只是返回存储的值。
在所有的RPC中,接收者必须呼应一个160位的随机RPC ID,这可以在一定程度上防止地址伪造的能力。PINGS也可以在RPC回复中附带使用,以便RPC接收者获得发件人的额外保证的网络地址。
Kademlia参与者必须执行的最重要的程序是找到离某个给定节点ID最近的k个节点,我们称这个程序为节点查找。Kademlia采用了一种递归算法来进行节点查找。查询开始时,从最近的非空k-bucket中挑选个节点(或者,如果 桶中的条目少于,它就从它知道的最接近的节点中选取)。然后,发起者向它所选择的个节点发送平行的、异步的FIND_NODE RPC,是一个系统范围内的并发参数,比如说3。
在递归步骤中,发起者向它从以前的RPC中了解到的节点重新发送FIND-NODE。(这个递归可以在所有 RPC已经返回之前开始)。在发起者听说过的最接近目标的k个节点中 ,它选择一个它还没有查询过的节点,并重新发送 FIND-NODE RPC给它们。未能快速响应的节点将被从考虑中删除,直到它们做出响应。如果一轮FIND_NODES未能返回比已经看到的节点更近的时候,发起者会重新发送FIND.NODE RPC给所有的节点。当发起者已经查询并得到了它所看到的最接近的k个节点的响应时,查询就结束了。当=1时,查找算法与Chord的算法相似,在信息成本和延迟方面都是如此,然而,Kademlia 可以以更低的延迟进行路由,因为它可以灵活地选择k个节点中的任何一个来转发请求。
大多数操作都是通过上述查找程序来实现的。为了存储一个(key,value)对,参与者要找到离key最近的k个节点并向它们发送sTORE RPC。此外,每个节点在必要时重新发布(key,value) 对,以保持它们的活力,如后面的第2.5节所述。这确保了(key,value)对的持久性(正如我们在证明草图中所显示的),而且概率极高。对于Kademlia目前的应用(文件共享),我们还要求(key,value)对的原始发布者每24小时重新发布一次。否则,(key,value)对在发布24小时后失效,以限制系统中陈旧的索引信息。对于其他应用,如数字证书或加密哈希值映射,更长的过期时间可能是合适的。
为了找到(key,value)对,节点首先执行查找以找到 ID 最接近键的k个节点。但是,值查找使用FIND-VALUE而不是FIND-NODE RPC。此外,当任何节点返回值时,该过程会立即停止。出于缓存目的,一旦查找成功,请求节点将 (key,value) 对存储在它观察到的与未返回值的键最近的节点处。
由于拓扑的单向性,未来对相同键的搜索可能会在查询最近的节点之前命中缓存条目。在某个密钥非常受欢迎的时期,系统可能最终会在许多节点上缓存它。为了避免“过度缓存”,我们使任何节点数据库中的(key,value)对的过期时间与当前节点和ID最接近键ID的节点之间的节点数成指数反比。虽然简单的LRU驱逐会导致类似的生命周期分布,但没有自然的方法来选择缓存大小,因为节点没有先验知识系统将存储多少值。
存储桶通常通过通过节点传输的请求流量来保持新鲜。为了处理对特定ID范围没有查找的病态情况,每个节点都会刷新在过去一小时内没有执行节点查找的任何存储桶。刷新意味着在存储桶的范围内选择一个随机ID并执行该ID的节点搜索。
要加入网络,节点u必须与已经参与的节点w有联系。 u将w插入到适当的k-bucket中。 然后,u对其自己的节点 ID 执行节点查找,最后,u刷新比其最近邻居更远的所有k-bucket。在刷新期间,u都填充自己的k-buckets,并根据需要将自己插入其他节点的k-buckets。
2.4 路由表
Kademlia的基本路由表结构在给定协议的情况下是相当简单的,尽管需要稍微巧妙地处理高度不平衡的树。 路由表是一棵二叉树,其叶子是k-buckets。每个k-bucket包含具有其ID的一些公共前缀的节点。前缀是k-bucket在二叉树中的位置。因此,每个k-bucket覆盖了ID空间的某个范围,并且这些k-bucket一起覆盖了整个160位ID空间,没有重叠。
路由树中的节点是根据需要动态分配的。图4说明了该过程。最初,节点u的路由树只有一个节点——一个覆盖整个ID空间的k-bucket。当你得知一个新的联系人时,它会尝试将联系人插入到适当的k-bucket中。 如果该桶未满,则只需插入新联系人。 否则,如果k-bucket的范围包括u自己的节点ID,则将该桶拆分为两个新的桶,旧的内容在两者之间划分,并重复插入尝试。 如果具有不同范围的k-bucket已满,则简单地丢弃新联系人。
一种复杂情况出现在高度不平衡的树中。假设节点u加入系统并且是唯一ID以000开头的节点。进一步假设系统已经有超过k个前缀为001的节点。每个前缀为001的节点都有一个空的 k-bucket,u应该插入其中,但u的存储桶刷新只会通知k个节点。为了避免这个问题,Kademlia节点将所有有效联系人保存在一个大小至少为k个节点的子树中,即使这需要拆分不包含节点自己ID的桶。图5说明了这些额外的拆分。当 wu 刷新拆分桶时,所有前缀为001的节点都会知道它。
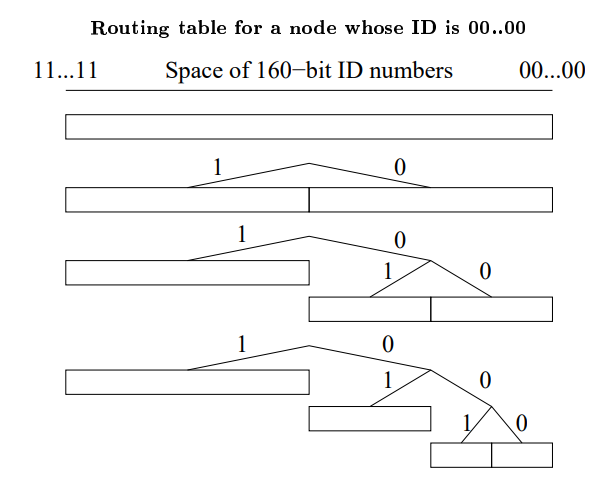
图4:路由表随时间的演变。最初,一个节点只有一个k-bucket,如顶部路由表所示。随着k-buckets的填满,范围覆盖节点ID的bucket反复分裂成两个k个bucket。
2.5 高效的密钥重新发布
为了确保键值对的持久性,节点必须定期重新发布密钥。否则,两种现象可能会导致查找有效键失败。首先,在发布时最初获得键值对的k个节点中的一些可能会离开网络。其次,新节点可能会以比最初发布键值对的节点更接近某个已发布键的ID加入网络。在这两种情况下,具有键值对的节点都必须重新发布它,以再次确保它在最接近键的k个节点上可用。
为了补偿离开网络的节点,Kademlia每小时重新发布一次每个键值对。这种策略的简单实现将需要许多消息——每个存储键值对的最多k个节点中的每个节点都会执行一次节点查找,然后每小时执行k-1个STORE RPC。幸运的是,重新发布过程可以进行大量优化。首先,当一个节点接收到一个给定键值对的STORE RPC时,它假设RPC也被发送到其他k - 1个最近的节点,因此接收者将不会在下一小时内重新发布键值对。这确保了只要重新发布间隔不完全同步,每小时只有一个节点重新发布给定的键值对。
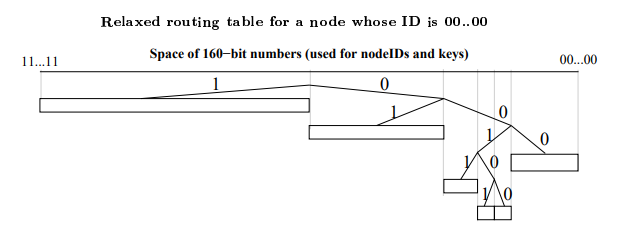
图5:该图举例说明了ID为 00...00的节点的宽松路由表。松弛表在其分支中可能具有小的(预期的恒定大小)不规则性,以确保它知道节点周围最小子树中的所有联系人,该节点至少具有k个联系人。
第二个优化避免在重新发布密钥之前执行节点查找。如第2.4节所述,为了处理不平衡树,节点根据需要拆分k-桶,以确保它们完全了解具有至少k个节点的周围子树,如果在重新发布键值对之前,节点w刷新了所有k-在这个k个节点的子树中的桶中,它将自动找出与给定键最近的k个节点。 这些存储桶刷新可以通过重新发布许多密钥进行摊销。
要了解为什么在u刷新大小>k的子树中的桶后不需要进行节点查找,有必要考虑两种情况。如果被重新发布的键落在子树的 ID 范围内,那么由于子树的大小至少为k并且u完全了解子树,显然u必须知道离键最近的k个节点。另一方面,如果键位于子树之外,而u是离键最近的k个节点之一,则它必须遵循u的k桶,因为它比子树更靠近键的间隔都具有少于k个条目。因此,将知道这些k桶中的所有节点,这些节点连同子树的知识将包括离键最近的k个节点。
当一个新节点加入系统时,它必须存储与它最近的k个键值对之一,现有节点通过类似地利用其周围子树的完整知识,将知道新节点应该使用哪些键值对存储,因此任何节点学习新节点都会发出STORE RPC将相关的键值对传输到新节点,以避免冗余,然而,一个节点只传输一个键值对,如果它自己的ID比其他节点的ID更接近键。
3 证明草图
为了证明我们系统的正确功能,我们需要证明对于一些小的常数c,大多数操作需要 时间,并且 (key,value) 查找返回存储在系统中的键,具有压倒性的优势 可能性。
我们从一些定义开始。 对于覆盖距离范围[ , )的k-bucket,将bucket的索引定义为i。将节点的深度h定义为160-i,其中i是非空桶的最小索引。将节点y在节点x中的桶高度定义为x将插入y的桶的索引减去2的最低有效空桶的索引。由于节点ID是随机选择的,因此不太可能出现高度不均匀的分布。因此,对于具有n个节点的系统,任何给定节点的高度以压倒性的概率将在log n常数内。此外,与第k个最近节点中的ID最近的节点的桶高度可能在log k的常数内。
我们的下一步将假设一个不变量,即如果一个节点存在于适当的范围内,每个节点的每个k-bucket都至少包含一个联系人。给定这个假设,我们证明节点查找过程是正确的并且需要对数时间。假设离目标ID最近的节点的深度为h。如果该节点的h个最重要的k-buckets中没有一个是空的,则查找过程将在每一步中找到一个接近一半的节点(或者更确切地说,其距离短一点),从而在h - logk步中找到该节点。 如果某个节点的k-buckets是空的,则可能是目标节点位于空bucket的范围内,在这种情况下,最后的步骤不会将距离减少一半,但是会继续搜索 就好像与空桶相对应的密钥中的位已被翻转。 因此,查找算法将始终返回h - log k中最近的节点。 此外,一旦找到最近的节点,并发从a切换到k。找到剩余的k-1个最近节点的步数可以不超过第k个最近节点中最近节点的桶高度,这不太可能超过一个常数加上log k。
在实践中,失败的概率远小于k节点在一小时内离开的概率,因为每个传入或传出的请求都会更新节点的桶。这是由XOR度量的对称性造成的,因为给定节点在传入期间与之通信的节点的ID或传出请求的分布与节点的存储桶范围完全兼容。
此外,即使单个节点中的单个桶的不变量确实失败,这只会影响运行时间(通过在某些查找中添加一跳),而不影响节点查找的正确性。对于查找失败,查找路径上的 k 个节点必须每个都丢失同一个桶中的 k 个节点,并且没有干预查找或刷新。如果不同节点的存储桶没有重叠,则发生这种情况的概率为 2-* 否则,出现在多个其他节点的存储桶中的节点可能会有更长的正常运行时间,从而降低失败的概率。
现在我们考虑一个(键,值)对的恢复。 当一个 (key,value) 对被发布时,它会被填充到最接近key的k个节点上。它也每小时重新发布一次。 由于即使是新节点(最不可靠)也有 1/2 的概率持续一小时,一小时后,(键,值)对仍将出现在最接近键的k节点之一上,概率为 。插入靠近键的新节点不会违反此属性,因为一旦插入此类节点,它们就会联系其最近的节点以填充其存储桶,从而接收它们附近的任何(键,值)对应该存储。 当然,如果离某个键最近的k个节点发生故障并且 (key,value) 对没有缓存在其他地方,Kademlia将无法存储该对并因此丢失该键。
4 实施说明
在本节中,我们描述了用于提高Kademlia实施性能的两种重要技术。
4.1 优化的联系人记帐
k-buckets的基本期望属性是提供LRU检查和无效联系人的驱逐,而不会丢弃任何有效的联系人。如2.2节所述,如果k-bucket已满,则每次从该bucket范围内的未知节点接收到消息时,都需要发送PING RPC。 viNG 检查k-bucket中最近最少使用的联系人是否仍然有效。如果不是,则新联系人将替换旧联系人。不幸的是,所描述的算法将需要大量网络消息用于这些PIN。
为了减少流量,Kademlia会延迟探测联系人,直到它有有用的消息发送。当Kademlia节点接收到来自未知联系人的RPC并且该联系人的k-bueket已经充满&条目时,该节点会将新联系人放入有资格替换陈旧k-bucket条目的节点的替换缓存中,下一次 节点查询k-bucket中的联系人,任何无响应的联系人都可以被驱逐并替换为替换缓存中的条目,替换缓存按上次看到的时间排序,最近看到的条目具有最高优先级作为替换候选 .
一个相关的问题是,由于Kademlia使用UDP,当网络数据包被丢弃时,有效的联系人有时会无法响应。由于丢包通常表明网络拥塞,因此Kademlia会锁定无响应的联系人并避免向它们发送任何进一步的 RPC 以实现指数级增加的退避间隔。 因为在大多数阶段 Kademlia 的查找只需要从 k 个节点之一接收消息,因此系统通常不会将丢弃的 RPC 重新传输到同一节点。
当一个联系人连续5个RPC都没有响应时,它被认为是陈旧的。如果k-bucket未满或其替换缓存为空,Kademlia只会标记陈旧的联系人而不是删除它们。除其他外,这确保了如果节点自己的网络连接暂时中断,该节点不会完全取消其所有k-buckets。
4.2. 加速查找
实现中的另一个优化是通过增加路由表大小来减少每次查找的跳数。 从概念上讲,这是通过一次考虑 b 位而不是一次只考虑一个位来完成的。 如前所述,每次查找的预期跳数是 。通过将路由表的大小增加到预期的 k桶,我们可以将预期的跳数减少到 logyn。
第2.4节描述了 Kademlia 节点如何在桶已满且其范围包括节点自己的ID时拆分k桶。 然而,该实现也将不包含节点 ID 的范围拆分为b-1级。 例如,如果b = 2,则不包含节点ID的一半ID空间被拆分一次(分成两个范围); 如果b=3,它会在两个级别上拆分为最多四个范围,等等。一般的拆分规则是,如果桶的范围包含节点自己的ID或k的深度d,则节点拆分完整的k桶 路由树中的-bucket满足d0 (mod b)。 (深度只是 k-bucket 范围内所有节点共享的前缀长度。)当前实现使用b=5。
尽管基于XOR的路由类似于Pastry [1]、Tapestry [2]和Plaxton的分布式搜索算法 (3]的第一阶段路由算法,但是当推广到b>1时,这三个算法都变得更加复杂。没有XOR拓扑,需要额外的算法结构来发现目标。在共享相同前缀但下一个 b 位数字不同的节点内。这三种算法都以不同的方式解决了这个问题,每一种都有自己的缺点。除了大小为( ) 的主表之外,它们都需要大小为() 的辅助路由表。这增加了引导和维护的成本,使协议复杂化,并且对于 Pastry 和 Tapestry 来说,使正确性和一致性的正式分析变得复杂或无法进行。Plaxton有一个证明,但该系统不太适合像点对点网络这样的高度容易出错的环境。
5 总结
Kademlia凭借其新颖的基于XOR的度量拓扑,是第一个将可证明的一致性和性能、延迟最小化相结合的点对点系统路由和对称的单向拓扑。Kademlia 还引入了一个并发参数a,它允许人们用带宽中的一个常数因子来换取异步最低延迟跳数选择和无延迟故障恢复。最后,Kademlia是第一个利用节点故障与正常运行时间成反比这一事实的点对点系统。
参考
1.A. Rowstron and P. Druschel. Pastry: Scalable, distributed object location and routing for large-scale peer-to-peer systems. Accepted for Middleware, 2001, 2001 http: //research.microsoft .com/~antr/pastry/
2.Ben Y. Zhao, John Kubiatowicz, and Anthony Joseph. Tapestry: an infrastructure for fault-tolerant wide-area location and routing. Technical Report UCB/CSD-01- 1141, U.C. Berkeley, April 2001
3.Andréa W. Richa C. Greg Plaxton, Rajmohan Rajaraman. Accessing nearby copies of replicated objects in a distributed environment. In Proceedings of the ACM SPAA, pages 311-320, June 1997
4.Stefan Saroiu, P. Krishna Gummadi and Steven D. Gribble. A Measurement Study of Peer-to-Peer File Sharing Systems. Technical Report UW-CSE-01-06-02, Univer- sity of Washington, Department of Computer Science and Engineering, July 2001
5.Ion Stoica, Robert Morris, David Karger, M. Frans Kaashoek, and Hari Balakrish- nan. Chord: A scalable peer-to-peer lookup service for internet applications, In Proceedings of the ACM SIGCOMM ‘01 Conference, San Diego, California, August 2001。
---煤油灯科技victorlamp.com翻译整理---
