摘要
任务规划可能需要定义关于机器人需要在其中行动的世界的无数领域知识。为了改善这项工作,大型语言模型 (LLM) 可用于在任务规划期间对潜在的下一步行动进行评分,甚至在没有额外领域信息的自然语言指令下直接生成行动序列。但是,此类方法要么需要枚举所有可能的后续步骤以进行评分,要么生成自由格式的文本,其中可能包含给定机器人在当前上下文中不可能执行的操作。我们提出了一个程序化的 LLM 提示结构,该结构可以跨环境、机器人能力和任务生成计划功能。我们的主要见解是通过类似程序的环境中可用操作和对象的规范来提示 LLM,以及可以执行的示例程序。我们通过消融实验对即时结构和生成约束提出了具体建议,展示了 VirtualHome 家庭任务中最先进的成功率,并将我们的方法部署在物理机器人手臂上以执行桌面任务。
1 引言
日常家务既需要对世界的常识理解,也需要对当前环境的实际知识。要为“做饭”创建任务计划,智能体需要常识:1.对象可见性,比如炉子和微波炉可以用来加热;2.有逻辑的动作顺序,比如在加入食物之前必须预热烤箱;3.物体和动作的任务相关性,比如加热和食物,首先是与“晚餐”相关的动作。然而,如果没有状态反馈,这种推理是不可行的。代理需要知道当前环境中有哪些食物可用,比如冰箱里有没有鱼,或者冰箱里有没有鸡肉。
在大型语料库上训练的自回归大语言模型(LLMs)以输入提示为条件生成文本序列,具有显著的多任务泛化能力。这种能力最近被用来在机器人任务计划的背景下生成合理的行动计划,方法是评分下一步或直接生成新步骤。在评分模式中,LLM从可能的空间中评估操作及其参数的枚举。例如,给定一个“做晚餐”的目标,第一个行动是“打开冰箱”,LLM可以列出一系列可能的行动:“拿起鸡肉”,“拿起苏打水”,“关闭冰箱”,“打开电灯开关。”在文本生成模式中,LLM可以生成接下来的几个词,然后需要将它们映射到代理可用的动作和世界对象。例如,如果LLM生成了“伸进去拿起腌黄瓜罐”,那么该字符串就必须整洁地映射到“拿起腌黄瓜罐”这样的可执行动作。基于LLM的任务规划中缺少的一个关键组件是来自环境的状态反馈。家里的冰箱可能没有鸡肉、苏打水或咸菜,但“做晚餐”的高级指令并不能给我们这种世界状态信息。我们的工作在基于LLM的机器人任务规划中引入了情境感知。
我们提出了ProgPrompt,这是一种超越了用自然语言调节LLM的提示方案。ProgPrompt利用编程语言结构,利用LLM在大量web语料库(包括许多编程教程和代码文档)上接受训练的事实(图1)。ProgPrompt为LLM提供了一个python程序头,它导入可用的操作及其预期参数,显示环境对象的列表,然后定义像make_dinner这样的函数,其主体是操作对象的操作序列。我们通过断言我们计划的前提条件来合并来自环境的情境状态反馈,例如在试图打开冰箱之前要靠近冰箱,并且用恢复操作来响应失败的断言。更重要的是,我们证明在ProgPrompt程序中包含自然语言注释,来解释即将到来的操作的目标,可以提高生成计划程序的任务成功度。
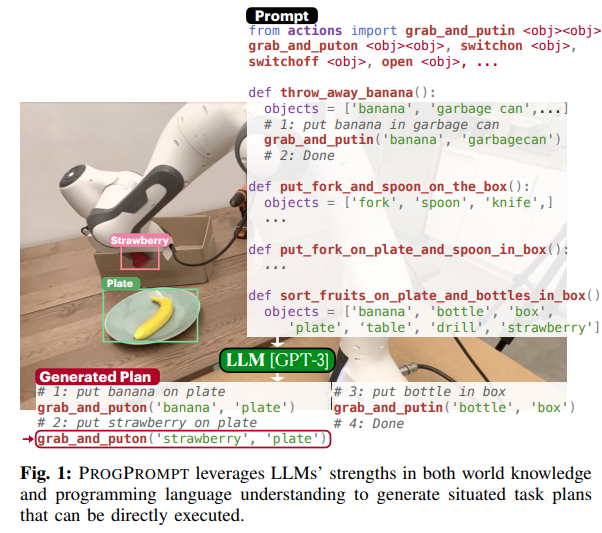
图 1:ProgPrompt利用 LLM 在世界知识和编程语言理解方面的优势来生成可以直接执行的定位任务计划。
2 背景及相关工作
任务计划。对于高层次的规划,机器人领域的大多数工作都在预定义的领域使用搜索。由于分支因素很大,无条件搜索在具有许多可行动作和对象的环境中很难扩展,启发式通常用于指导搜索。最近的研究探索了基于学习的任务和运动规划,使用了诸如表示学习、分层学习、语言作为规划空间、学习作文技能等方法。我们的方法绕过搜索,直接生成一个包含条件推理和错误修正的计划。
我们将任务计划制定为一组⟨ο,ρ,α,τ,i,g,t\omicron,\rho,\alpha,\tau,i,g,t ⟩。O是环境中所有可用对象的集合,P是对象的一组属性,它也通知了对象的可见性,a是一组可执行操作,它根据定义为当前环境状态而更改s∈SS ss。T表示转换模型T:s×a→SS ,I和G是初始状态和目标状态,代理没有访问目标状态的权限g∈G,但只是高级任务描述t。
与LLM规划。大型语言模型(LLM)是一种具有许多参数的神经网络(目前有数千亿个参数),用于训练无监督学习目标,如下一个令牌预测或掩码语言建模。用最大似然损失训练一个自回归LLM来建模一个令牌序列的概率。
LLM 在大型文本语料库上进行训练,并在提供相关提示输入时表现出多任务泛化,提示 LLM 生成对机器人任务规划有用的文本是一个新的话题 。鉴于缺乏具有可执行计划或机器人动作序列的配对自然语言指令文本,提示设计具有挑战性。为任务计划预测设计提示可以分解为提示功能和答案搜索策略。有提示功能进入文字提示。答案搜索是生成步骤,其中 LLM 从整个 LLM 词汇表中输出或对一组预定义的选项进行评分。
与我们的工作最接近的是使用 LLM 生成开放域计划。在这项工作中,计划通过以下方式进行:1)在提示示例中选择类似的任务(Fprompt_{prompt} ); 2)开放式任务计划生成(答案搜索);3) 1:1 预测到动作匹配。整个计划是在没有任何环境交互的情况下开环生成的,然后测试匹配动作的可执行性。但是,基于生成文本的动作匹配并不能确保该动作在当前情况下是可接受的。InnerMonologue 引入了环境反馈和状态监控,但仍然发现 LLM 计划者提出的动作涉及场景中不存在的对象。我们的工作表明,受编程语言启发的提示生成器可以告知 LLM 所处的环境状态和可用的机器人动作,确保输出与机器人动作的兼容性。
相关的SayCan使用带有 LLM 的自然语言提示来生成一组可行的规划步骤,使用学习的价值函数对匹配的可接受动作进行重新评分。SayCan 构建了一组用自然语言表达的所有可接受的动作,并使用 LLM 对它们进行评分。这在具有组合动作空间的环境中具有挑战性。与我们的工作同时进行的是苏格拉底模型,它也使用代码完成来生成机器人计划。我们通过在提示中利用额外的、熟悉的编程语言特性来超越。我们定义一个Fprompt_{prompt}其中包括用于建模机器人功能的导入语句、用于引发常识推理的自然语言注释以及用于跟踪执行状态的断言,我们的答案搜索是通过允许 LLM 直接生成完整的可执行计划程序来执行的。
3 我们的方法:Progprompt
我们将机器人计划表示为Python程序。按照LLM提示的范例,我们创建了一个结构为Python代码的提示,并使用LLM来完成代码(图2)。我们使用Python中可用的特性来构造提示,以自然语言指令为条件,引出LLM来生成情境机器人任务计划。
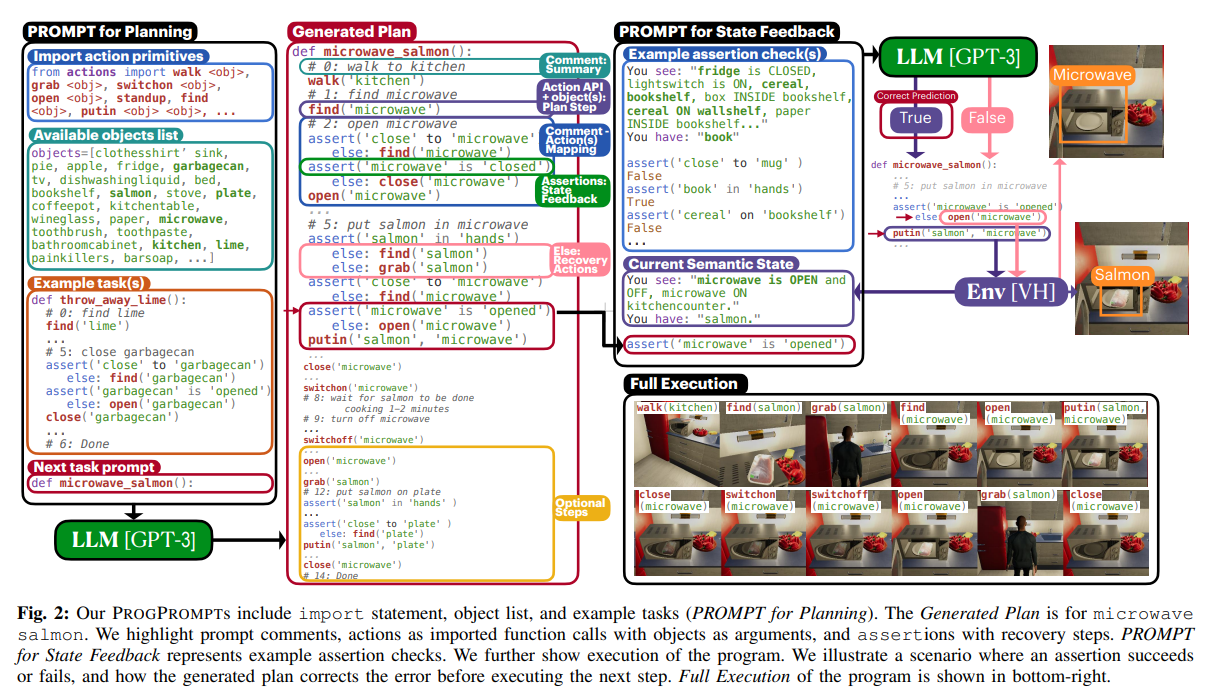
图 2:我们的ProgPrompt包括导入语句、对象列表和示例任务(PROMPT for Planning),生成的计划适用于微波鲑鱼。我们强调提示注释、作为以对象为参数的导入函数调用的动作,以及带有恢复步骤的断言。状态反馈提示表示示例断言检查。我们进一步展示了程序的执行。我们说明了一个断言成功或失败的场景,以及生成的计划如何在执行下一步之前纠正错误。 程序的完全执行显示在右下角。
3.1 将机器人计划表示为python函数
计划函数由对动作原语的API调用、总结动作的注释和跟踪执行的断言组成(图LABEL: Fig:plan_example)。基本操作使用对象作为参数。例如,“将鲑鱼放入微波炉”任务包括像找到(鲑鱼)这样的API调用。
我们利用代码中的注释为后续操作序列提供自然语言摘要,注释有助于将高级任务分解为逻辑子任务。例如,在图标签:无花果:plan_example,“微波把鲑鱼”任务分解成子任务使用评论“#抓鲑鱼”和“#把鲑鱼在微波”。这个分区可以帮助LLM表达其知识在自然语言和援助计划中任务和子任务。注释还告知LLM近期目标,减少不一致、发散或重复输出的可能性。先前的工作也显示了被称为“思维链”的类似中间总结对提高LLM在一系列算术、常识和符号推理任务中的表现的有效性。我们通过经验验证了注释的效用(表1)。
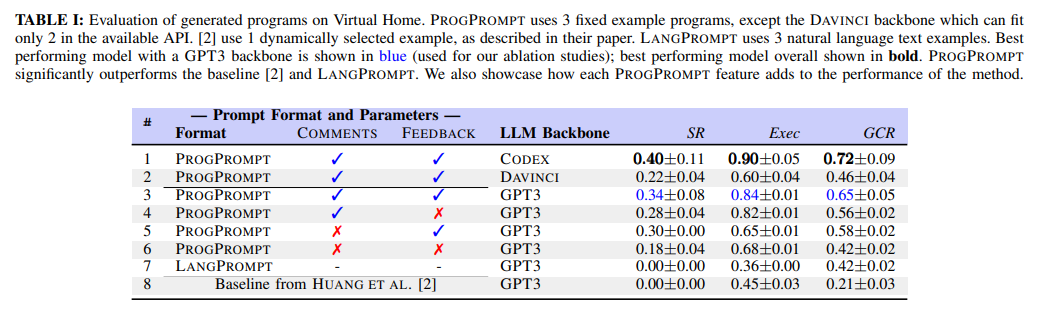
表1:在虚拟家庭中生成的程序的评估。 ProgPrompt使用 3 个固定示例程序,除了Davinci主干,它只能在可用 API 中容纳 2 个。 [ 2 ]使用 1 个动态选择的示例,如他们的论文中所述,LangPrompt使用 3 个自然语言文本示例。具有GPT3主干的最佳性能模型以蓝色显示(用于我们的消融研究);整体表现最佳的模型以粗体显示。 ProgPrompt明显优于基线 [ 2 ]和LangPrompt,我们还展示了每个ProgPrompt功能如何增加方法的性能。
断言提供了一种环境反馈机制,以确保前提条件满足,并在前提条件不满足时启用错误恢复。例如,在图LABEL: Fig:plan_example中,在抓取(鲑鱼)动作之前,计划断言代理接近鲑鱼。如果没有,代理首先执行找到(鲑鱼)。在选项卡,我们展示这样的断言语句(列反馈)效益计划生成。
3.2 构建编程语言提示符
我们通过快速构建向LLM提供关于环境和基本操作的信息。正如在少量的LLM提示中所做的那样,我们还为LLM提供了示例任务和计划的示例。图2显示了我们的提示功能fpromptf_{prompt} 提示它接受所有的信息(观察、操作原语、示例),并为LLM生成一个python的提示符来完成。然后,LLM预测<下一个任务>,比如作为可执行函数(图2中的microwave_salmon)。
在任务微波中的鲑鱼,LLM可以产生的合理的第一步是 take_out(鲑鱼,杂货袋)。但是,负责执行计划的代理可能没有take_out的基本操作。为了将代理的操作原语通知LLM,我们将它们作为python的导入语句提供。这鼓励LLM将其输出限制为仅在当前上下文中可用的函数。要更改代理ProgPrompt只需要一个表示代理操作的导入函数的新列表。环境中也可能不存在杂货袋对象,我们将环境中的可用对象作为字符串列表提供。由于我们的提示方案显式列出了模型可用的函数和对象集,因此生成的计划通常包含代理可以采取的操作和环境中可用的对象。
ProgPrompt还包括一些示例任务——完全可执行的程序计划。每个示例任务演示如何使用给定环境中的可用操作和对象完成给定任务,这些示例演示了任务名称(以函数句柄形式给出)与要执行的操作之间的关系,以及对操作和要涉及的对象的限制。
3.3 任务计划的生成和执行
给定的任务是由LLM根据ProgPrompt提示完全推断出来的。生成的计划通过解释器在虚拟代理或物理机器人系统上执行,解释器针对环境执行每个操作命令。断言检查在执行期间以闭环方式完成,提供当前环境状态反馈。
4 实验
我们通过在虚拟家庭环境和物理机器人操作臂上的实验来评估我们的方法。
4.1 模拟实验
我们在虚拟家庭(VH)环境中评估了我们的方法,在一个典型家庭活动的确定性仿真平台。VH状态S是一组对象O和属性P。P编码信息如(salmon, microwave)和agent_close_to(salmon)这样的信息。动作空间是={抓,放进,放回,走,找,打开,关闭,切换,切换,坐,站}。
我们在3个VH环境中进行实验。每个环境包含115个独特的对象实例(图2),包括类级副本。每个对象都具有与其操作支持度相对应的属性。有些对象还具有加热、洗涤或使用等语义状态。例如,Food类别中的对象可以随时加热。
我们创建了一个包含70个家庭任务的数据集。这些任务都带有诸如“微波鲑鱼”之类的高级指令。我们收集从初始状态完成任务的基本事实动作序列,并记录最终状态gg 定义了一系列象征性的目标条件,gg ∈PP .
在执行生成的程序时,我们将环境状态反馈作为对断言的响应,VH以状态图的形式提供了具有对象属性和关系的观测结果。为了在这种环境中检查断言,我们从状态图中提取有关对象的信息,并提示LLM以文本提示的形式返回给定状态图和断言的断言是否存在(图2状态反馈提示)。
4.2 真实的机器人实验
我们使用带有平行爪抓手的 Franka-Emika Panda 机器人。我们假设访问一个拾取和放置策略,该策略将目标对象和目标容器的两个点云作为输入,并执行拾取和放置操作以将对象放置在容器上或容器内。我们使用的系统来实现策略,并使用 MPPI 进行运动生成,使用 SceneCollisionNet来避免碰撞,并使用 Contact-GraspNet生成抓取姿势。
我们为ProgPrompt的动作grab_and_putin指定一个导入语句。我们使用开放词汇对象检测模型 ViLD]来识别和分割场景中的对象,并为提示构建可用的对象列表。与在虚拟环境中对象列表是所有任务通用的全局变量不同,这里的对象列表是每个计划函数的局部变量,这允许更大的灵活性以适应新对象。LLM 输出一个计划,其中包含格式为grab_and_putin的函数调用。这里,对象obj1和obj2是我们使用 ViLD 分割掩码和深度图像映射到点云的文本字符串。由于现实世界的不确定性,我们不会在桌面计划上实施基于断言的闭环选项。
4.3 评估指标
我们使用三个指标来评估系统性能:成功率(SR)、目标条件召回率(GCR)和可执行性(Exec)。与任务相关的目标条件是在演示的初始和最终状态之间变化的目标条件集,SR是实现所有与任务相关的目标条件的执行的比例。Exec是计划中可在环境中执行的动作的一部分,即使它们与任务无关。GCR是用基真值最终状态条件之间的设置差来测量的。
5 结果
ProgPrompt 成功地提示基于 LLM 的任务计划者执行虚拟和物理代理任务。
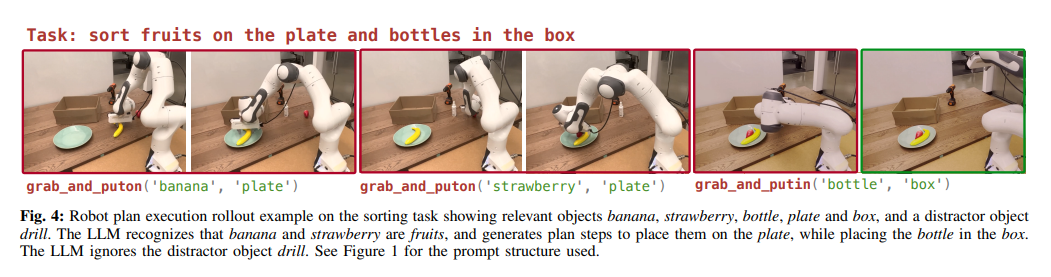
图 4:分拣任务上的机器人计划执行推出示例,显示相关对象香蕉、草莓、瓶子、盘子和盒子,以及一个牵引对象钻头。LLM 认识到香蕉和草莓是水果,并生成将它们放在盘子上的计划步骤,同时将瓶子放在盒子里。LLM 忽略了干扰物训练。
5.1 虚拟实验结果
表1总结了我们的任务计划生成和执行系统在VirtualHome环境下的性能。我们使用GPT3作为语言模型主干来接收ProgPrompt提示并生成计划。每个结果在单个VH环境中运行5次,跨越10个任务,不同运行的性能差异来自于LLM输出的采样。在VH上评估了1到7个提示的性能后,我们为每个提示包含了3个Pythonic任务计划示例,并发现2个或更多提示对GPT3的性能大致相同。计划的例子被固定为:“把酒杯放在厨房橱柜里”,“扔掉酸橙”,“洗杯子”。
我们可以从表中得出几个结论:I.首先,使用相同的大型语言模型主干,ProgPrompt(第3-6行)在所有指标上都比前面的工作(第8行)有很大的优势。其次,我们观察到,Codex和Davinci模型,本身是GPT3变体——在这项任务中表现出好坏参半的成功。特别是,Davinci不匹配基本的GPT3性能(第2行与第3行),可能是因为它的提示长度限制将其限制为2个任务示例,而其他行有3个任务示例。此外,Codex在每个指标上的性能都超过了GPT3(第1行与第3行),这可能是因为Codex显式地训练了编程语言数据。然而,Codex每分钟查询的数量有限,所以我们继续在接下来的消融实验中使用GPT3作为我们的主要LLM主干。我们给社区的建议是利用一个类似程序的提示来进行基于LLM的任务规划和执行,在这方面基础GPT3工作得很好,我们注意到进一步对编程语言数据(如Codex)进行微调的LLM可以做得更好。
我们探讨了ProgPrompt的几种消融方法。首先,我们发现示例程序中的反馈机制,即断言和恢复操作,可以跨指标提高性能(第3行与第4行、第5行与第6行),唯一的例外是,当提示示例代码中没有注释时,没有反馈的Exec会提高一点。其次,我们观察到从提示代码中删除注释大大降低了所有指标的性能(第3行vs .第5行和第4行vs .第6行),突出了编程语言结构中自然语言指导的有用性。
我们还评估了LangPrompt,它是ProgPrompt的替代方案,从可用对象的自然语言文本描述和示例任务计划(第7行)构建提示。LangPrompt类似于构建的提示。LangPrompt的输出是生成的动作序列,而不是我们提出的类程序结构。因此,我们微调GPT2来学习策略P将那些生成的序列映射到模拟环境中的可执行动作。我们使用训练集中的35个任务,并注释文本步骤和相应的动作序列,以获得400个数据点用于训练和验证该策略。我们发现,虽然该方法通过GCR实现了合理的部分成功,但它并不匹配的程序可执行性Exec,也没有生成任何完全成功的任务执行。
Task-by-Task Performance 表II显示了测试集中每个任务的ProgPrompt性能。我们观察到,类似于提示例子的任务,比如扔掉苹果和洗盘子,有更高的GCR,因为事实提示例子暗示了好的停止点。即使使用高Exec,有些任务的GCR也很低,因为有些任务有多个适当的目标状态,但我们只针对单个“真实”目标进行评估。例如,在微波和电镀鲑鱼后,代理人可能把鲑鱼放在桌子或工作台上。
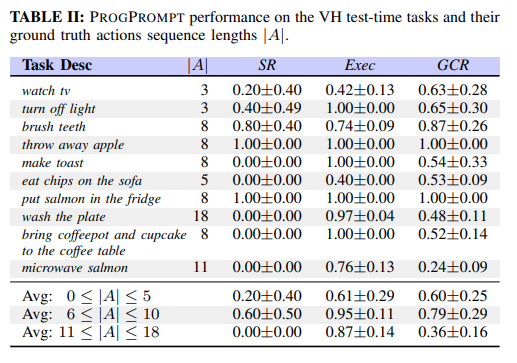
表二: VH 测试时间任务的ProgPrompt 性能及其地面实况动作序列长度
Other Environments 我们在另外两个VH环境中评估ProgPrompt(表3),对于每一个我们在提示符中的示例任务之后附加一个代表新环境的新对象列表,后面是在新场景中要完成的任务。操作原语和其他ProgPrompt设置保持不变。我们评估10个任务,每个任务运行5次。对于像在洗碗机中清洗餐具这样的新任务,ProgPrompt能够推断出在新场景中,餐具指的是勺子和叉子,尽管在示例提示中,餐具总是指的是刀。
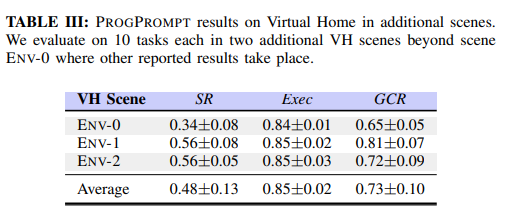
表 3:附加场景中虚拟家庭的ProgPrompt 结果。我们在场景Env-0之外的另外两个 VH 场景中分别评估了 10 个任务,其中发生了其他报告的结果。
5.2 定性分析与局限性
我们从ProgPrompt手动检查生成的程序及其执行轨迹,并描述常见的故障模式。许多失败都源于将ProgPrompt设置为对部署环境及其特性不可知的决定,这可以通过显式通信解决,例如,将目标环境的对象支持作为ProgPrompt提示符的一部分。
- 环境工件:VH代理不能在坐着的时候找到或与附近的对象进行交互,对于对象的一些常识性操作,如打开电视台架的机柜,在VH中是不可用的。
- 环境复杂性:当对象不可访问时,生成的断言可能不够用。例如,如果代理在机柜中发现一个对象,它可能不打算打开机柜来抓取该对象。
- 操作成功反馈没有提供给代理,这可能导致后续操作失败。计划中的断言恢复模块可以提供帮助,但生成的断言恢复模块不能覆盖所有可能性。
- 不完全生成:一些计划被LLM API上限缩短了。一种可能是使用提示和部分生成的计划再次查询LLM。
除了这些失败模式,我们严格的最终状态检查意味着,如果代理完成了任务,我们可能推断失败,因为环境目标状态将不匹配我们预先计算的ground truth最终目标状态。例如,煮好咖啡后,代理可能会把咖啡壶拿到另一张桌子上。类似地,有些任务描述是模糊的,并且有多个貌似正确的程序。例如,“做饭”可以有多个可能的解决方案。ProgPrompt会生成用煎锅和炉子烹饪三文鱼的方案,有时代理会添加甜椒或酸橙,有时会配上水果,或用餐具盛在盘子里。当在不同的VH环境中运行时,代理将烹饪鸡肉。ProgPrompt能够为这些复杂的任务生成计划,同时使用场景中可用的对象,而不是任务中明确提到的对象。然而,这种任务的自动评估需要列举所有有效和无效的可能性,或者引入人工验证。
5.3 物理机器人的实验结果
物理机器人的结果显示在表4中,我们对表中难度递增的4项任务进行评估。对于每个任务,我们执行两个实验:一个在只包含必要对象的场景中,并添加一到三个干扰对象。
所有结果显示使用ProgPrompt注释,但没有反馈。我们的物理机器人设置不允许可靠地跟踪系统状态和检查断言,而且容易由于抓握打滑等原因出现随机故障。现实世界引入了随机性,使系统之间的定量比较复杂化。因此,我们希望通过物理结果来定性地证明我们的提示方法能够轻松地将LLM生成的计划约束和接地到物理机器人系统中。我们报告了一个额外的度量Plan SR,它指的是在没有夹板失效的情况下,在成功的取放执行情况下,计划是否可能成功。
无论是否有分对象d 跨任务,系统几乎总是成功的,只有在排序任务上失败。由于随机夹持器故障,无干扰器下入失败。有两个干扰物的测试失败了,因为模型错误地把汤罐当成了瓶子。生成的计划的可执行性总是Exec=1。
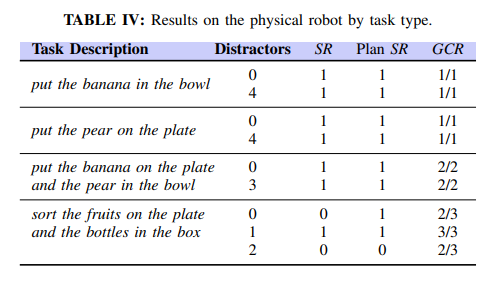
表 4:按任务类型划分的物理机器人的结果。
6 结论和未来的工作
我们提出了一种用于机器人任务规划的LLM提示方案,它综合了LLM的两大优点:常识推理和代码理解。我们构建了包含对世界的情境理解和机器人能力的提示,使LLM能够直接将可执行计划作为程序生成。我们的实验表明,ProgPrompt编程语言特性在一系列指标上提高了任务性能。该方法直观、灵活,可广泛推广到新的场景、代理和任务,包括一个真实的机器人部署。
作为一个社区,我们只触及机器人计划生成和完成的任务规划的表面。我们希望研究编程语言特性的更广泛使用,包括表示度量的实值数、表示场景图的嵌套字典和更复杂的控制流。来自NLP社区的几项研究表明LLM可以做算术和理解数字,但它们在复杂机器人行为生成方面的能力仍有待开发。
原文链接:https://arxiv.org/abs/2209.11302
