深度学习(Deep learning,DL)应用具有独特的架构特征和效率要求。因此,计算系统的选择对用户最终能享受到多大的DL饼有深远的影响。尽管加速器可以提供比通用计算系统(CPU)更高的吞吐量,但在其他一些指标和使用场景中,CPU是首选或更优越的。
CPU有它的长处,加速器不是万能的
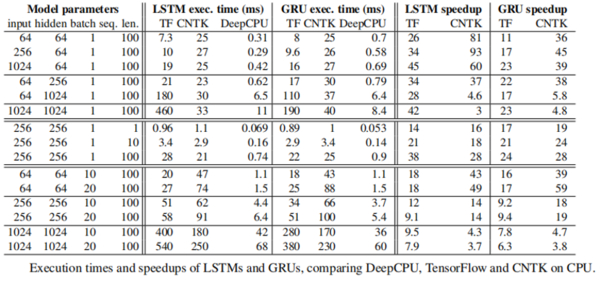
稀疏dnn在大规模并行处理器上效率低下,因为它们的内存访问不规则,并且无法利用缓存切片和矢量化等优化。此外,由于步骤之间的依赖性,rnn难以并行化。类似地,dnn(如InceptionNet变体)具有1×1、3×3、1×3、3×1等滤波器形状,这会导致不规则的内存访问和跨层的可变并行量。
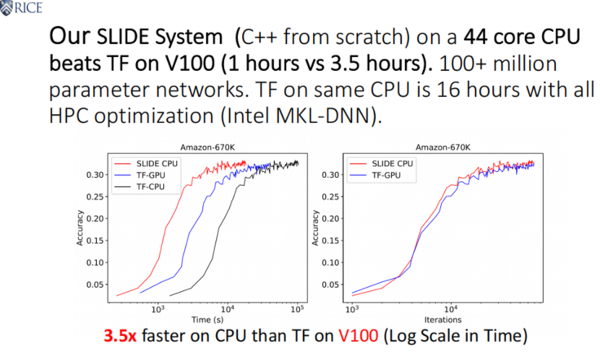
相反,CPU由于其先进的内存管理技术,更适合这种并行性有限的应用。例如,莱斯大学(Rice University)研究人员已经表明,对于稀疏数据集上的全连接网络,如Amazon-670K和Delicious-200K,DL训练问题可以建模为搜索问题。这允许用哈希表(hash tables)代替矩阵乘法操作。他们采用CPU技术,实现了比GPU上基于TensorFlow方案更高的性能。
大批量的3D CNNs甚至3D CNNs都需要大量的存储器。由于云和数据中心场景中由CPU管理的主机具有比加速器大得多的内存容量,因此在CPU上运行内存密集型操作不仅有吸引力,而且通常是必要的。TPU等加速器为大批量生产提供了高产量;但是,对于需要实时推理的应用程序,不建议使用大批量。在小批量的情况下,CPU通常提供有竞争力的延迟。有许多技术可用于进一步调优CPU上的DL应用,例如,硬件感知修剪、矢量化、缓存切片和近似计算。我们的调查报告总结了许多这样的技术。
全面:从小型可穿戴设备到大型数据中心
物联网设备和可穿戴设备具有紧张的电力和面积预算,这排除了过度专业化。例如,智能手表芯片不能为语音/音频/图像/视频处理提供单独的加速器。在运行Android的智能手机中,对于移动GPU或者DSP的编程支持还没有完全成熟。事实上,在一个典型的移动SoC上,移动CPU的理论峰值性能等于移动GPU的峰值性能。此外,随着时间的推移,支持社交网络等web服务的数据中心的计算需求会出现大幅波动。由于CPU对于DL和非DL任务的高可用性和高效率,它们可以满足需求的这种可变性。最后,在国防和医疗等需要安全认证的极端环境中,CPU有时是唯一的选择平台。
不要错过显而易见的:经济和易用性
加速器需要很长的设计周期和大量的投资。将它们整合到现有的生态系统中需要很高的成本和工程工作。相比之下,CPU的硬件/软件栈已经得到了很好的建立和理解。它们可以在广泛的应用程序上提供合理的加速。虽然大型公司有资源来构建和维护他们的定制加速器,但CPU(或GPU)仍然是其他公司最可行的平台。
未来展望:比你想象的更光明
展望未来,仅仅提高峰值性能是不够的;需要更多革命性的改进来提高广泛的DL应用程序的性能,如强化学习和生成式对抗网络。最近的CPU已经开始为低精度计算提供硬件支持。一旦内存计算达到成熟,CPU的大型缓存将变成巨大的计算单元。RISC-V等开源ISA的开发将进一步打破加速器的便携性和专利壁垒。
度量兴趣的标准是多种多样的,最先进的DL模型也是如此。我们相信,未来将不再就“通用处理器 vs加速器”争论,而是出现一种结合两个世界精华的“CPU -加速器”异构计算方法。
原文链接:https://www.hpcwire.com/2021/04/14/the-role-and-potential-of-cpus-in-deep-learning/
