摘要
在本文中,我们探索了针对真实世界机器人任务的各种野外视频图像的自我监督视觉预训练。与之前的工作一样,我们的视觉表示通过掩码自动编码器 (MAE) 进行预训练、冻结,然后传递到可学习的控制模块中。与之前的工作不同,我们表明预训练的表示在一系列现实世界的机器人任务和实施例中是有效的。我们发现我们的编码器始终优于 CLIP(高达 75%)、受监督的 ImageNet 预训练(高达 81%)和从头开始训练(高达 81%)。最后,我们在来自互联网和自我中心视频的大量 450 万张图像集合上训练了一个 307M 参数的视觉变换器,并清楚地展示了缩放视觉预训练对机器人学习的好处。
1.介绍
使用大型神经网络学习表征是现代深度学习的动力源泉,这在计算机视觉、自然语言处理和音频生成方面取得了令人瞩目的成果 。我们如何将表征学习的成功案例转移到机器人技术上?我们可以从两个方面来解决这个问题:感知方面的共享表征或行动方面的共享表征,我们在本文中的重点是共享视觉表征。
当然,细节决定成败。视觉学习领域的最新发展使这变得更加可行:(1)使用来自互联网和以自我为中心的视频的各种真实世界数据,(2)不过度依赖数据增强或其他方法的自我监督目标强大的人工设计先验形式,(3) 可扩展和高容量transformer模型 ,以及 (4) 在冻结视觉表示之上训练控制策略。在我们最近的工作中,我们已经证明这种自我监督视觉预训练方法对于模拟中的电机控制是有效的。
在本文中,我们展示了该框架对现实世界的机器人任务也有效(图 1)。我们以之前的工作为基础,但在数据规模和多样性方面取得了重大进展 (7倍或更大),型号尺寸(15倍或更大)和真实世界的实验(广泛的真实机器人评估)。
特别是,我们在来自互联网和以自我为中心的视频数据集的真实世界图像和视频上训练自我监督的视觉表示。我们利用掩码自动编码器通过掩码预测学习视觉表示。希望通过学习预测真实世界图像中缺失的内容,该模型将学习视觉世界的有用属性,使其能够学习执行真实世界的机器人任务。给定预训练的视觉编码器,我们冻结编码器并在顶部学习控制策略。相同的视觉表示用于所有下游机器人任务和实施例。我们专注于通过行为克隆进行有效的现实世界学习,每个任务有少量人类提供的演示。
我们在广泛的真实世界研究中评估了我们的方法,并报告了 981 个真实世界实验的结果。我们考虑基本的电机控制任务(伸手、推、拾取),以及场景和对象变化的任务(图 1,右)。我们发现我们的方法比 CLIP(高达 75%)、监督预训练(高达 81%)和从头开始训练(高达 81%)实现了更高的性能。此外,我们观察到我们的表示导致样本复杂性的大幅改进,以一半的演示次数达到最强的基线性能。
此外,我们通过在来自 ImageNet、Epic Kitchens、Something Something 的 4.5M 图像的大量集合上 训练 307M 参数视觉编码器,展示了扩展机器人视觉预训练的好处,100 天的动手和 Ego4D 数据集。重要的是,我们观察到单独扩展模型是不够的,更大的模型需要更大的数据集。据我们所知,我们的模型是为机器人技术部署的最大视觉模型,并清楚地展示了视觉预训练规模对机器人学习的好处。
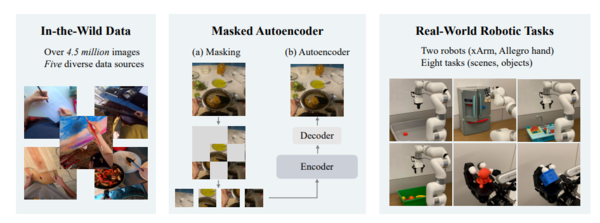
图 1:使用蒙面视觉预训练的真实世界机器人学习。我们从大量互联网和以自我为中心的数据中学习视觉表征,我们使用蒙版图像建模预训练表示,冻结编码器,并在顶部学习机器人任务的控制策略。
2.相关工作
端到端控制:涉及学习直接根据观察预测机器人动作(例如,关节速度、末端执行器姿势等) ,而无需执行显式 3D 姿势估计、把握规划 、运动规划。然而,这些端到端的方法对于现实世界的训练来说往往样本效率太低。一些工作试图在这些显式流水线方法和端到端方法之间找到平衡。
机器人技术的监督预训练:通过强监督学习一个或多个借口任务,然后将表征转移到下游机器人任务。Lin等人从检测和分割等语义任务中学习到的表征与对象操作的可供性图相关。Shridhar等人使用语言监督的 CLIP 模型学习语言条件模仿策略,在并行工作中, Nair等人使用时间对比学习和人类注释者的语言描述来探索预训练视觉表示,这些方法都需要专家标签或跨域监督。
机器人技术中的自我监督学习:已被探索为提高样本效率的一种手段。示例包括:从与环境的交互中学习动态模型;从与环境的交互中学习视觉表征;在自收集轨迹上学习基于视觉 的策略;学习轨迹上的视觉自动编码器;通过视频学习时空表征;学习视觉对应; 利用非参数最近邻检索;并对预先收集的演示进行视觉自监督学习。这些方法需要域内数据收集,因此可能难以扩展到训练环境和任务之外。相比之下,我们的方法使用了大规模和多样化的真实世界图像和视频集合,使其更具通用性。
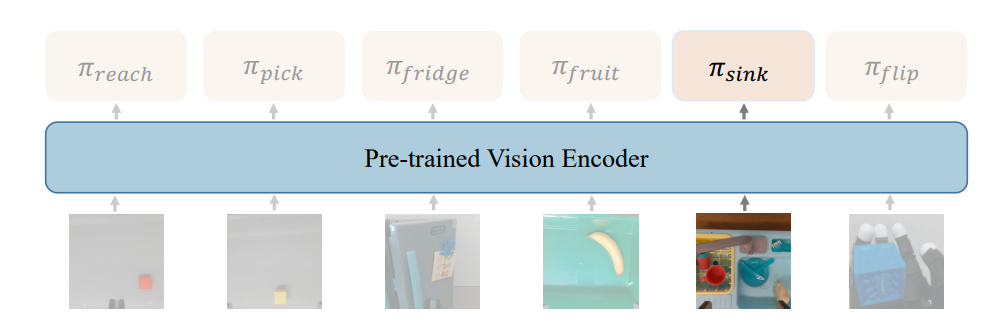
图 2:适用于所有机器人和任务的一个编码器。我们在冻结编码器之上按任务训练控制策略。相同的视觉编码器用于所有下游机器人任务和实施例。
3.真实世界的机器人学习与掩码视觉预训练
3.1掩码视觉预训练
数据采集。我们首先编译一个用于学习视觉表示的大规模数据集。我们主要使用 Ego4D,这是一个来自九个国家的大规模、以自我为中心的数据集,通过便携式设备记录,涵盖超过 3,670 小时的日常生活活动。我们将 Ego4D 数据与 ImageNet 以及使用的手对象交互 (HoI) 数据相结合,其中包括以自我为中心的 Epic Kitchens 数据集、YouTube 100 Days of Hands 数据集和众包 Something-Something 数据集. 我们的训练数据总计 450 万张图像,是 HoI 数据的 6.5 倍。我们发现,一个足够大且多样化的预训练数据集来执行掩模图像建模自监督任务对于扩展真实机器人任务的视觉主干至关重要。
自我监督的目标。我们的自监督表示学习方法的核心是通过掩码自动编码器 (MAE)进行掩码图像建模。MAE 屏蔽掉图像中的随机补丁,并使用视觉转换器 (ViT) 重建缺失的内容 。高掩蔽率(例如75%)和不对称重编码器轻解码器设计对于有效地学习良好的视觉表示很重要。MAE 简单且没有数据集或特定于任务的增强,是计算机视觉领域最先进的自监督 框架,并已被证明在仿真中也适用于电机控制任务]。
建筑学。我们使用 ViT 模型作为我们的视觉编码器。虽然 MAE 训练的 ViT 模型随着模型大小的增加在视觉任务中产生了改进的性能 ,但之前的工作没有显示将ViT-Small 模型切换到 4x 的 ViT-Base 对应物的改进许多参数。在这项工作中,我们将模型扩展到 ViT-Large,并将其部署到真实机器人上。该模型包含 307M 个参数并运行在~输入大小为 224 时为 64 gigaflops×224,大约是普遍采用的 ResNet-50的 15 倍,这是为机器人技术部署的最大视觉模型。正如我们将在实验中展示的那样,在对足够大的数据进行训练的同时缩放模型大小会导致下游机器人任务的性能持续改进。
3.2真实世界的机器人学习
我们学习通过行为克隆 (BC) 执行真实的机器人任务。我们收集了包含来自腕戴式摄像机的 RGB 图像轨迹和机器人在每个时间步的关节状态的演示。对于大多数任务,我们使用运动跟踪的 HTC Vive VR 系统来控制末端执行器。对于一些难以通过运动控制器演示的任务,例如,关闭冰箱门,我们使用动觉教学。给定记录的演示,我们训练一个控制策略,在时间步长接收输入图像特征和本体感受状态(关节位置) 并预测时间步长的动作 +1,我们执行联合头寸控制;我们不使用任何末端执行器信息(例如,6-DoF 姿势)。我们建立在我们的 MVP 管道 上,并在整个策略学习过程中冻结图像编码器,这可以防止大型预训练编码器过度适应特定设置或任务,并大大减少 GPU 内存占用和训练时间。
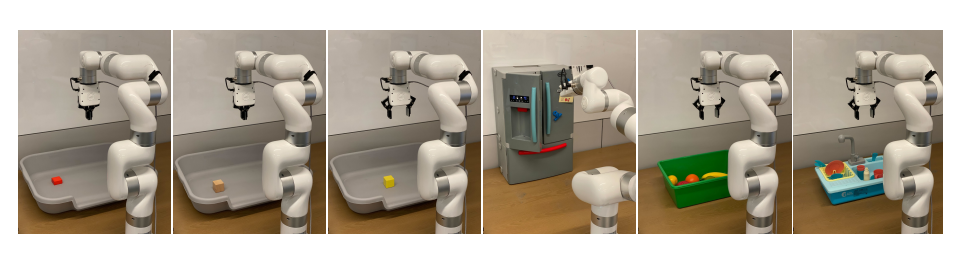
图 3:真实世界的机器人任务。我们使用带有平行钳口夹持器的 7 DoF 机器人手臂进行广泛的真实机器人评估,我们的任务包括基本的电机控制技能(到达红色方块、推动木方块和挑选黄色方块)、场景变化(关闭冰箱)、物体(采摘水果)以及场景和物体(从中挑选洗涤剂瓶)杂乱的水槽)。
4.实验装置
在本节中,我们提供了我们方法的实施细节并描述了我们的评估设置。
数据。我们分别以 0.2 fps、1fps 和 0.3fps 从 Ego4D、Epic Kitchens 和 Something-Something 中提取帧。然后,我们将 Ego4d 与 ImageNet 和 YouTube 100 Days of Hands 数据集结合起来。这个过程从 Ego4D 产生 260 万帧,从 ImageNet 产生 120 万张图像,从其余部分产生 700k HoI 图像,总共 450 万张图像。我们将组合数据集称为“Ego”的缩写。请注意 仅使用 700k HoI 图像,不包括 Ego4D 和 ImageNet。
编码器。我们使用标准的 Vision Transformer (ViT) 架构作为图像编码器。我们使用三种不同尺寸的模型:ViT-Small ]、ViT-Base 和 ViT-Large 模型,参数分别为 22M、86M 和 307M。ViT-Small 模型与 ResNet-50 模型大小大致相同,而 ViT-Large 模型有~参数数量是 ResNet-50 模型的 15 倍。
预训练。我们通过 MAE 框架对模型进行预训练 。训练方法紧跟使用中的数据集特定设置,我们使用辅助虚拟分类标记来转移到下游机器人任务。我们为组合的 Ego 数据集训练了 400 个时期的 MAE 模型;HOI 数据集 1600 个 epoch;ImageNet 数据集有 1600 个 epoch。我们使用中的预训练方法进行涉及 ImageNet 监督模型的研究。
控制器。控制器接收图像特征和机器人的本体感受状态。我们使用关节位置作为本体感受状态,而没有明确地将末端执行器姿势附加到状态。我们不在状态下使用速度,因为我们的低成本手臂不支持真正的速度传感。控制器输出三角关节角度,控制器的设计紧密遵循,即四层 MLP,每个隐藏层后都有一个 SeLU激活。大多数任务的隐藏大小为,而对于PickSink任务。我们将图像特征和本体感受状态线性投影到联合嵌入空间作为控制器的输入。
机器人和机器人任务。我们使用低成本的 UFACTORY xArm7 机器人(一个 7-DoF 手臂)和一个 1-DoF 平行爪夹持器。我们使用手臂的最大控制频率 5 Hz 进行收集演示和控制。我们使用第一人称手腕式 RealSense 摄像头来完成所有任务。我们不使用来自相机的深度信息。我们考虑基本的电机控制任务,即、ReachBlock、PushCube和PickCube,以及更具挑战性的上下文任务,即、CloseFridge、PickFruit和PickSink。这些任务如图3所示 (下一节中有更多详细信息)。
演示。我们为每个任务收集 80 个演示。我们使用运动跟踪 HTC Vive VR 系统来完成大多数任务,除了CloseFridge我们使用运动学教学,我们在机器人上使用轨迹重播来进行轨迹修剪,我们不使用关键帧信息进行学习。
评估。我们系统地扫过 16 种环境变化,例如,移动目标对象。为了研究的一致性和可靠性,我们在单个任务中对所有模型使用相同的16 个变体,并在每个变体中依次评估模型,以便获得相似的光照条件、机器人条件、精确的物体初始位置等。
5.实验结果
我们对一系列视觉主干、真实世界的机器人任务、对象和环境进行了广泛的评估(图 3),我们总共报告了 981 个真实世界实验的结果。
5.1基本电机控制
我们在视觉简单的上下文中评估了三个基本的电机控制任务:到达一个红色方块、推动一个木制立方体和拾取一个黄色立方体(任务可视化请参见图 3 )。这些任务是更复杂任务的垫脚石,而可能成为机器人技术基础的视觉表示应该有效地学习这些任务。在所有情况下,我们随机化初始对象和机器人位置。
与各种视觉编码器的比较。在图 4中,我们将我们的方法与一组最先进的视觉主干进行了比较:CLIP 在 400M 文本图像对上训练,在 ImageNet 上训练的监督模型,以及从头开始训练的模型与域内演示数据。为了公平比较,我们对所有方法都使用 ViT-Base视觉编码器。我们凭经验观察到 CLIP 编码器在基线中表现最好,并且排名顺序在基准任务中是一致的。我们的方法始终以相当大的优势优于基线。
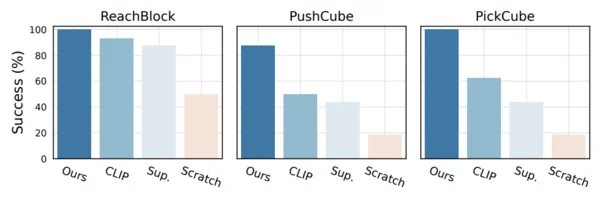
图 4:与视觉编码器的比较。我们将我们的方法与使用 CLIP 训练的视觉编码器、ImageNet 上的监督学习以及手头任务的从头开始进行比较。在所有情况下,我们观察到我们的方法始终以相当大的幅度优于基线。
样本复杂性。在图 5中,我们研究了我们方法的性能,因为演示的数量从 20 到 80 不等。作为参考,我们展示了最具竞争力的基线 CLIP 的性能,它经过 80 次演示(水平虚线)的训练。总的来说,我们观察到我们的方法达到了 CLIP 性能,同时减少了 50% 的演示。这一结果是使用我们的模型学习更复杂的机器人任务的有希望的信号,如下所述:
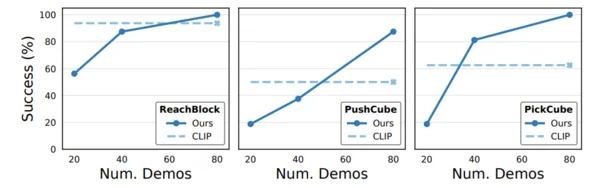
图 5:样本复杂性。我们展示了我们的方法的性能,因为演示的数量从 20 到 80 不等。80 次演示的 CLIP 性能以虚线显示以供参考,我们的方法与 CLIP 相当,仅使用一半的演示次数。
5.2视觉上多样化的场景和物体
我们之前已经表明,我们的方法可以学习基本的电机控制任务,例如伸手、推和拾取,并且比基线视觉主干具有更高的成功率和更好的样本复杂性。为了专注于电机控制方面,我们使用了视觉上简单的环境和基本对象。然而,我们的方法的主要潜在好处之一是,从不同的真实世界图像中学习视觉表示可能有助于解决涉及在更复杂的视觉环境中与日常物体交互的机器人任务。在本小节中,我们评估了我们在机器人任务上的视觉表示,其中场景和对象在更逼真的设置中有所变化。
场景上下文。CloseFridge我们首先通过考虑关闭打开的玩具冰箱门(称为)的任务,在更现实的场景中评估我们的方法。我们将冰箱的位置、门的哪一侧关闭以及门的初始角度随机化。如图6左下角所示 ,冰箱和机器人的初始配置差异很大,这在日常设置中很常见。图 6左上角显示我们的方法优于所有基线。
不同的对象。接下来,我们评估具有各种对象的任务。目标是捡起八种颜色、形状和大小不同的水果(称为PickFruit)。在每次试验中,随机选择一个水果,水果和机器人的位置都是随机的。训练示范次数不变,即我们为每个水果提供10次示范。在图 6的中间,我们展示了评估结果(顶部)和起始配置示例(底部)。我们看到基线在这种情况下挣扎,而我们的方法获得了近乎完美的分数。
上下文中的对象。最后,我们评估了我们在一项任务上的方法,该任务的特点是在日常环境中与对象进行交互。我们让机器人从杂乱的水槽(称为PickSink)中挑选一个洗涤剂瓶。该任务具有挑战性,因为场景的视觉配置(例如玩具盘、马克杯和银器)可以无限变化,如图 6 右侧所示。我们观察到我们的方法大大优于使用 相同ViT- B编码器。
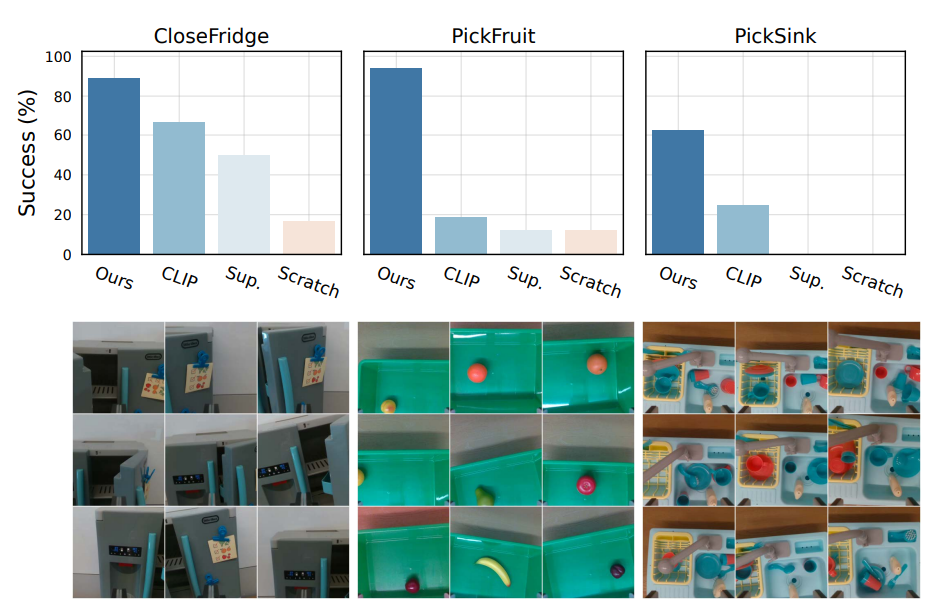
图 6:场景和对象的变化。我们将我们的方法与 CLIP 在场景(关闭冰箱)、对象(采摘水果)以及场景和对象(从杂乱的水槽中挑选对象)的变化的任务上进行比较。这些模型是 ViT-Base。我们的方法大大优于 CLIP,并且差距比更简单的设置更大(参见图 4)。这可能表明我们的表示捕获了更精确的空间结构,这有助于在更现实的环境中完成机器人任务。
5.3缩放模型和数据大小
重要的是,我们的视觉预训练方法使用自我监督目标 ,该目标对数据分布几乎没有做出任何假设,并且不依赖于人为设计的借口任务,例如数据扩充。因此,该框架非常适合从大量未标记和自然视觉数据中进行预训练。在这里,我们研究缩放模型和数据大小。
我们首先考虑增加模型容量。在图 7的左侧,我们看到增加模型大小 (~4.5x) 从 ViT-S 到 ViT-B,同时保持数据大小固定(HOI 图像收集),不会提高性能甚至会造成伤害,这与报告的模拟结果一致 。然而,如果我们还将数据大小从 HOI 扩展到我们大量的自我数据收集,ViT-B 会产生更好的结果。这些结果表明我们必须同时缩放模型和数据。
在图 7中和右侧,我们将性能显示为模型大小的函数。此外,将模型大小从 86M 参数 ViT-B 增加到 307M 参数 ViT-L 会带来进一步的改进。对于视觉上更具挑战性的任务 ,增益更大PickSink。据我们所知,我们的工作是部署到真实机器人任务的最大视觉模型,它清楚地展示了扩展视觉预训练对真实世界机器人学习的好处。
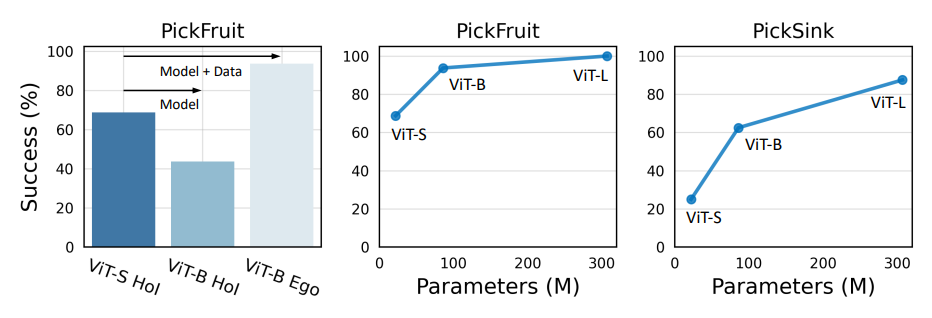
图 7:缩放模型和数据。我们研究了我们方法的缩放特性。我们观察到,在保持数据集固定(HoI 图像收集)的同时,单独将模型大小从 ViT-S 缩放到 ViT-B 不会提高性能,甚至会造成伤害(左)。然而,当我们同时缩放模型和数据(我们大量的 Ego 图像集合)时,我们会从更大的模型中看到明显的好处。从 86M ViT-B 到 307M ViT-L 型号(中间和右侧)时,趋势仍在继续。此外,对于更艰巨的任务,收益更大(右)。
5.4与并行工作的比较
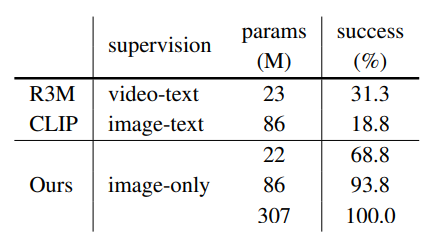
表 1:与并行工作的比较。我们所有的视觉模型都经过纯图像自我监督训练,大大优于 在来自 Ego4D的成对视频语言标签上训练的 最强可用 R3M模型。对于较大的模型,收益更大,在 PickFruit 任务上进行评估。
5.5消融研究
我们对相机设置、输入模式、训练设置、我们和基线的模型架构以及下游微调进行消融研究。结果如图 8所示,接下来将进行讨论。
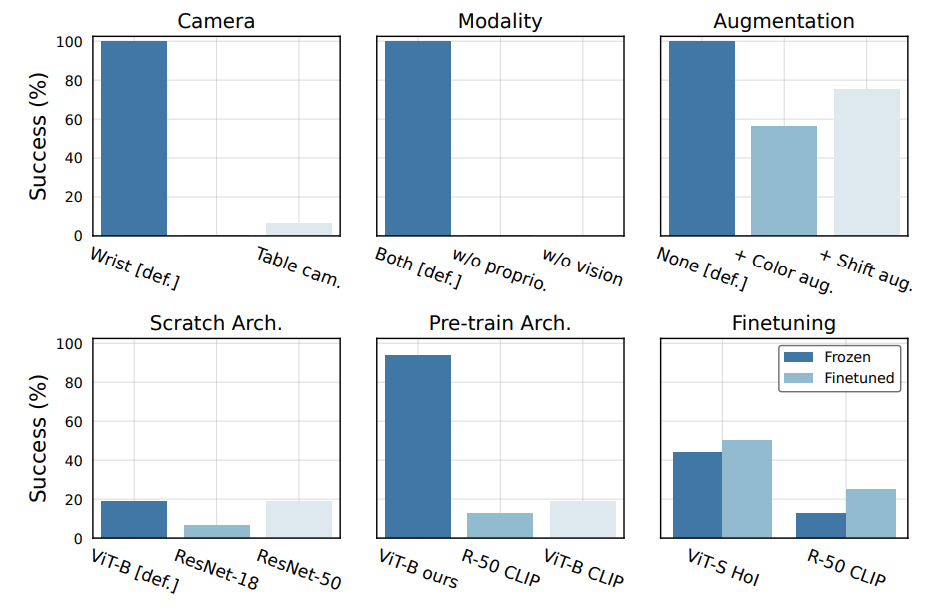
图 8:消融研究。 我们对相机设置进行消融研究;输入方式;常用的图像增强;从头开始的培训架构;CLIP 预训练架构,以及对下游任务的端到端微调。
相机。我们比较了使用第一人称手腕相机和第三人称桌面相机(图 8,左上角)。腕戴式摄像头的效果明显优于第三人称摄像头。在评估试验中,我们观察到第三人称相机模型难以进行细粒度定位,物体离相机越远,预测的轨迹就越差。这表明模型可能会被设置中的尺度(大小)模糊所混淆,因为我们没有使用深度,第三人称观察不会随着机器人的动作而改变。
情态。我们尝试从模型的输入中移除本体感受状态或图像(图 8,中上);两者都产生零成功率,因为都不是任务的完全观察输入。
增强。我们尝试添加常见的数据增强来训练任务策略(图 8,右上角)。我们没有观察到这些增强可能带来的任何好处,因为我们的视觉编码器被冻结并且在有限数据量的训练中过拟合明显减少。
从头开始训练的架构。我们比较了从头开始训练的各种较小尺寸的模型架构(图 8,右下角)。ResNet-18 和 ResNet-50 模型分别占参考 ViT-B 模型(FLOP-wise)的 11% 和 22%,并没有产生更好的结果。
CLIP 预训练架构。我们比较了公开发布的 CLIP ResNet-50 和 ViT-B 模型。CLIP ViT-B 模型为机器人任务提供了更好的性能。该结果与报告的 CLIP 模型计算机视觉任务性能的排名顺序一致 。
微调。我们微调了 ViT-S HoI 模型和 CLIP ResNet-50 模型,因为它们是相对较小的模型,可以在下游任务上实现适度的性能。对这些模型进行微调会略微提高性能,这表明仅对有限数量的演示进行微调并不能缩小与预训练的卓越视觉表示的差距。
5.6 案例研究:多指手
我们的方法不对下游机器人任务或实施例做出任何假设。特别是,我们的策略将像素图像作为输入并预测关节位置角度作为动作(而不是,例如,末端执行器姿势)。在本小节中,我们通过使用多指 Allegro 手将其应用于下游任务来测试我们方法的通用性。
视觉触及。我们设计了一项伸手可及的任务,在该任务中,手学会用食指指尖伸手够到物体的顶部。对象的位置在手掌上随机分布。我们为 8 个不同的对象中的每一个提供 10 个演示。在测试时,我们对 8 个可见对象和 45 个不可见对象评估经过训练的策略(参见图 9),成功率是~两者均为 50%。
视觉翻转。接下来,我们考虑翻转立方体任务,目标是翻转放在手掌中的橡胶立方体。立方体的位置在手掌上是随机的,因此,策略必须依靠视觉提示来完成任务。总的来说,我们观察到 30 次试验的成功率为 50%。有关示例关键帧,请参见图 9,还可以查看项目页面上的视频。
通过行动了解愿景。在冻结的视觉表示之上的训练策略使我们能够进行研究以了解预训练的视觉表示用于下游任务的内容。在这里,我们首先训练一个到达黄色立方体的策略,但用不同形状和颜色的物体进行测试。首先,我们发现当给定相同形状不同颜色(木立方体)或相同颜色不同形状(黄色球)时,策略会达到目标。接下来,当给定黄色立方体和干扰物时,它会伸手去拿黄色立方体。最后,当给定一个不同形状和颜色的物体(蓝色立方体)时,手保持静止。
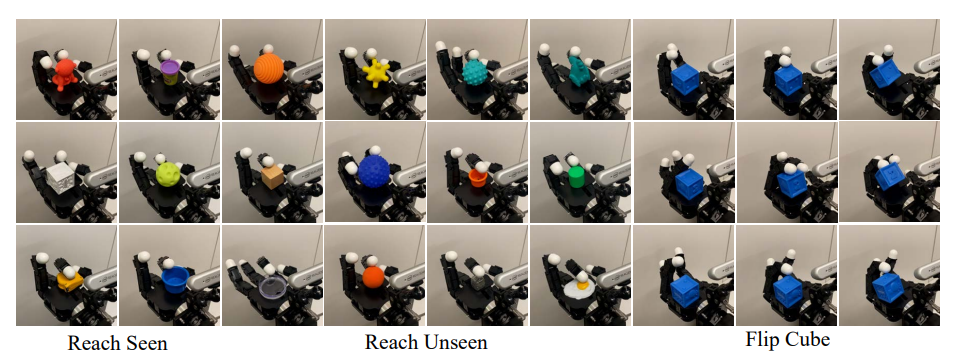
图 9:多指手。我们表明我们的框架很容易推广到不同的机器人形态。我们尝试伸手、使用可见和不可见的物体以及翻转立方体。
6.讨论
限制。虽然我们研究中使用的场景和对象比简单的机器人基准测试更真实,但我们仍然主要在相对干净的实验室环境中使用玩具对象,而不是在真实场景上下文中使用真实对象。我们的任务涉及单个对象,不需要机器人学习反馈控制或学习多步规划,机器人正常运行时间等因素也可能影响结果。随着我们为现实世界的机器人应用程序开发、基准测试和广泛部署预训练模型,克服这些限制至关重要。
结论。我们探索从大量真实世界数据中学习视觉表示,并将它们用于下游机器人任务。我们使用掩码建模预训练表示,冻结编码器,并在顶部学习控制策略。我们在现实世界中进行了广泛的评估,结果表明,在各种机器人任务中,我们的方法比 CLIP、受监督的 ImageNet 预训练和从头开始训练的方法具有更高的成功率和更好的样本复杂性,我们进一步展示了缩放模型和数据大小对于真实世界机器人学习的好处。
论文链接:https://arxiv.org/abs/2210.03109
---煤油灯科技victorlamp.com翻译整理---
